
RSGPT:高质量对齐助力遥感大模型跨越“语义代沟”
Rsgpt: A remote sensing vision language model and benchmark
本文提出了 RSGPT,一种专为遥控感(Remote Sensing)设计的视觉语言模型,并配套发布了高质量的人工标注数据集 RSICap 和评测基准 RSIEval。RSGPT 通过对 InstructBLIP 进行轻量化微调,在图像描述(Captioning)和视觉问答(VQA)任务上达到了 SOTA 水平。
TL;DR
在通用视觉语言模型(VLM)横扫一切的今天,遥感(Remote Sensing)领域由于其特殊的上帝视角和专业语义,一直面临“水土不服”的难题。武汉大学等机构的研究团队提出了 RSGPT,通过构建目前最精细的人工标注数据集 RSICap,证明了即使只有 2000 余条高质量样本,也能让大模型在遥感理解任务上实现质的飞跃。
痛点深挖:为什么通用大模型看不懂遥感图?
尽管 GPT-4 或 MiniGPT-4 在自然场景中表现惊艳,但在面对遥感图像时经常“翻车”。核心原因有三:
- 视角特殊性:自然图像多为水平视角,而遥感图像是俯视垂直视角,目标(如飞机、建筑)的视觉特征完全不同。
- 数据质量低下:现有的遥感图文数据集(如 RS5M)大多使用 BLIP-2 等模型自动生成标签,充满噪声且描述极其简略(如“这是一张机场的照片”),缺乏对数量、颜色及空间关系的深度解析。
- 推理能力缺失:现有模型大多在做“识别”,而非“理解”。它们无法解释为什么某张图是冬天(通过树木凋零的倒影猜测)。
核心方法:小而精的“对齐”哲学
RSGPT 的核心不在于暴力堆砌参数,而在于数据对齐的精度。
1. RSICap:遥感界的 LIMA
作者借鉴了 LIMA(Less Is More for Alignment)的思路,人工标注了 2,585 个精细的 Image-Text 对。相比前人,其描述平均长度达到 60 个单词,涵盖了场景主题、物体颜色、形状、绝对位置、相对关系,甚至包含了视觉预测(Reasoning)。
2. 模型架构与微调策略
RSGPT 基于 InstructBLIP 的架构,主要包含三个部分:
- Frozen Image Encoder (EVA-G):负责提取基础视觉特征。
- Q-Former:作为“中间人”,通过 Learnable Queries 从视觉特征中提取与指令相关的语义信息。
- Vicuna LLM:将提取的视觉特征与文本输入结合,生成最终回复。
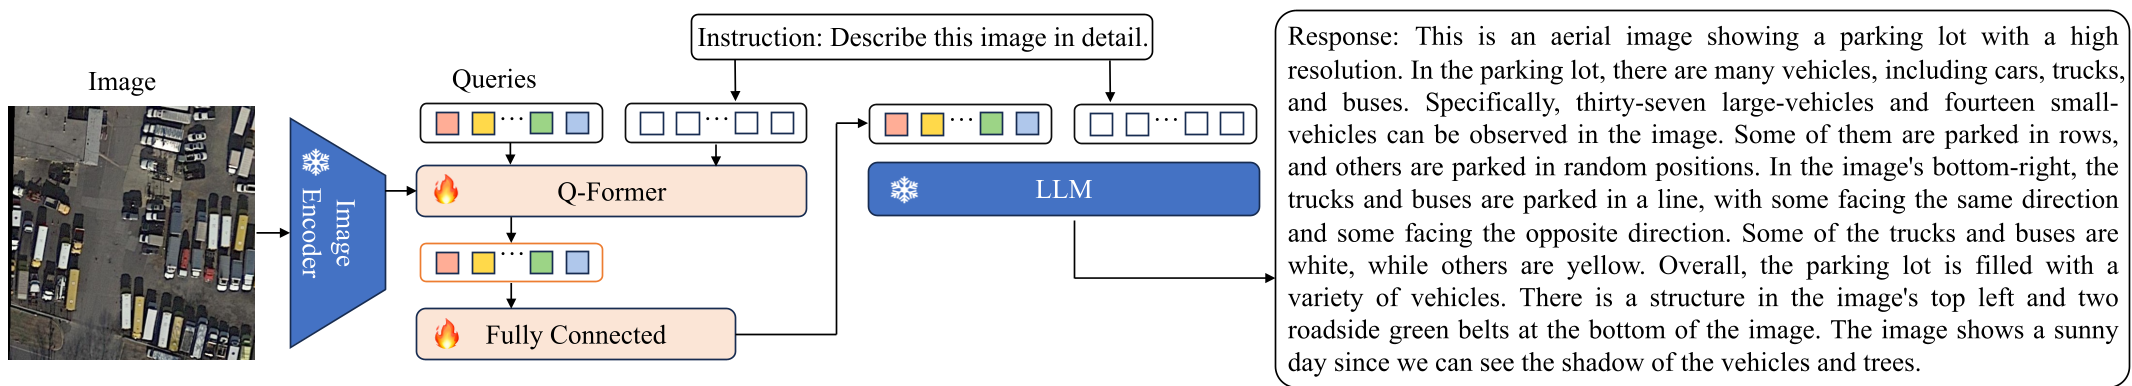 图 1:RSGPT 整体架构,仅微调中间的 Q-Former 和 Linear 层
实验战绩:让 VLM 拥有“专业测绘员”的眼睛
在作者提出的 RSIEval 基准测试中,RSGPT 展示了恐怖的解析力。
定性对比:细节与位置的胜利
与 BLIP-2 和 MiniGPT-4 相比,RSGPT 能够准确识别出“七辆正在路面行驶的车辆”以及“左侧的水体”,而其他模型往往会产生幻觉(Hallucination),例如在遥感图中“看到”了行人。
 图 2:四种模型在图像描述任务上的横向对比
定量分析:全面碾压
在 RSVQA 任务中,RSGPT 在物体存在性(Presence)、场景分类(Scene)和逻辑推理(Reasoning)上的精度均大幅领先。尤其是在最难的数量统计(Quantity)任务中,RSGPT 将相对误差降到了最低。
| Method | Presence Acc | Average Acc | Quantity Error |
|---|---|---|---|
| MiniGPT-4 | 29.70% | 21.82% | 0.8548 |
| InstructBLIP | 76.14% | 53.26% | 0.7318 |
| RSGPT (Ours) | 81.22% | 65.24% | 0.4828 |
深度洞察:垂直领域的 AGI 路径
RSGPT 的成功带给我们两点启发:
- 数据的“尊严”:工业界之前热衷于百万级的弱标注数据,但本文再次验证,在垂直领域,千条级别、由专家审定的高质量对齐数据对于激活大模型的领域知识至关重要。
- 空间推理是刚需:遥感任务不仅是简单的分类,准确理解物体间的相对空间位置是未来实现全自动化地理分析(Geo-AI)的核心屏障。
总结与局限
虽然 RSGPT 在基础任务上表现惊艳,但在极端超大规模场景或多时相数据处理上仍有探索空间。此外,对于高度专业化的地学知识(如特定植被覆盖度计算)还需更深度的知识图谱注入。
Takeaway: RSGPT 为遥感图像理解打开了一扇窗,证明了即使在资源受限的情况下,专业领域的知识微调依然拥有抗衡通用 SOTA 的能力。