
ERA:突破人类直觉极限,AI 领航专家级科学软件自动化
s41586-026-10658-6_reference
本文介绍了一种名为 ERA (Empirical Research Assistance) 的 AI 系统,旨在通过结合大语言模型 (LLM) 与树搜索 (TS) 算法,自动编写、优化并生成专家级的科学实验软件。该系统在生物信息学、流行病学和时间序列预测等多个领域打破了人类专家保持的 SOTA 纪录。
TL;DR
DeepMind 等机构的研究人员联合推出了 ERA (Empirical Research Assistance) 系统。这不是一个简单的代码补全工具,而是一个能通过“阅读”科研论文、提取核心算法思想,并利用树搜索 (Tree Search) 在解空间内疯狂迭代,最终写出比论文原作者更高效代码的“AI 科学家助手”。它在单细胞测序、疫情预测等多个硬核科学赛道直接刷爆了人类专家的榜单。
痛点深挖:被编码拖累的科学发现
现代科研中,很多问题(如气象模拟、药物发现)最终都会转化为一个可评分的软件任务:谁的代码跑出的 Acc 分数高,谁的算法就更先进。
然而,目前的现状是:
- 搜索盲区:人类科学家往往根据经验选择现成的库,很难系统性地探索所有算法组合。
- 工程瓶颈:从论文公式到高性能代码的转化极度耗时,限制了新假设的验证频率。
- 直觉偏差:设计选择往往基于“方便”而非“最优”。
核心机制:当 LLM 遇上树搜索
ERA 的核心逻辑非常硬核:它不从零开始幻想,而是基于“复原与改进”。
1. 架构解析
ERA 将代码生成的迭代过程看作一棵搜索树。每一个节点都是一段可运行的 Python 代码。
- 变异 (Mutation):LLM 扮演“程序员”,根据父节点的代码及运行反馈(报错信息或评分),重写一段新代码。
- 树搜索 (PUCT):系统利用一种改进的 UCB 算法平衡“开发”与“探索”。它会优先在得分高的路径上深入,同时不定期尝试全新的分支。
- 思想注入 (Instruction Injection):用户扔给 ERA 一篇 PDF,LLM 会总结其中的核心算法思路(如:使用布朗运动模型),并将其作为提示词引导代码演化。
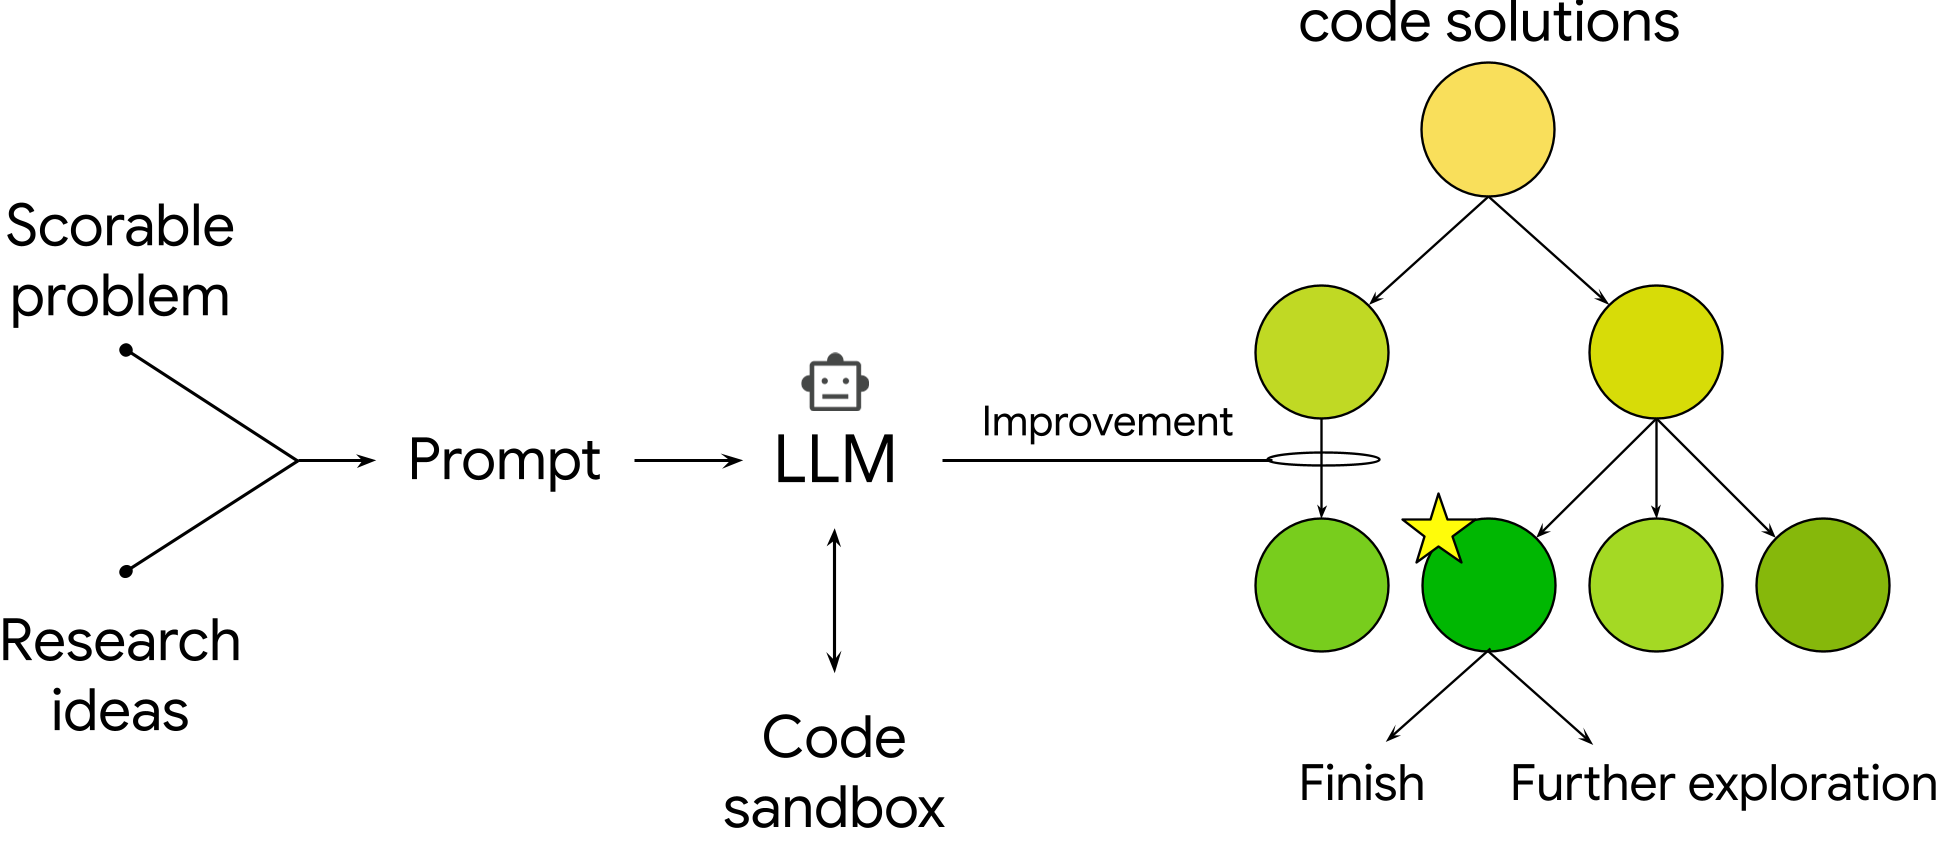 图 1:ERA 如何通过树搜索与思想注入循环优化代码性能
2. “思想重组”:AI 的超越之道
ERA 最令惊艳的能力是 Recombination。它能将 A 论文的预处理方法和 B 论文的核函数组合在一起,产生一种人类从未实现过的新算法。例如,在处理单细胞数据时,它发现将 ComBat 处理后的 Embedding 传给 BBKNN 算法能产生奇效,这一组合直接刷新了 OpenProblems 榜单。
实验战绩:全线碾压人类基准
单细胞数据集成 (scRNA-seq)
在生物信息学领域,消除不同实验批次产生的“噪声”极难。ERA 不仅能通过论文描述复现现有 9 种主流算法,甚至通过自动微调和结构重组,让其中 8 种算法的性能直接超越了原作者发布的 SOTA 结果。
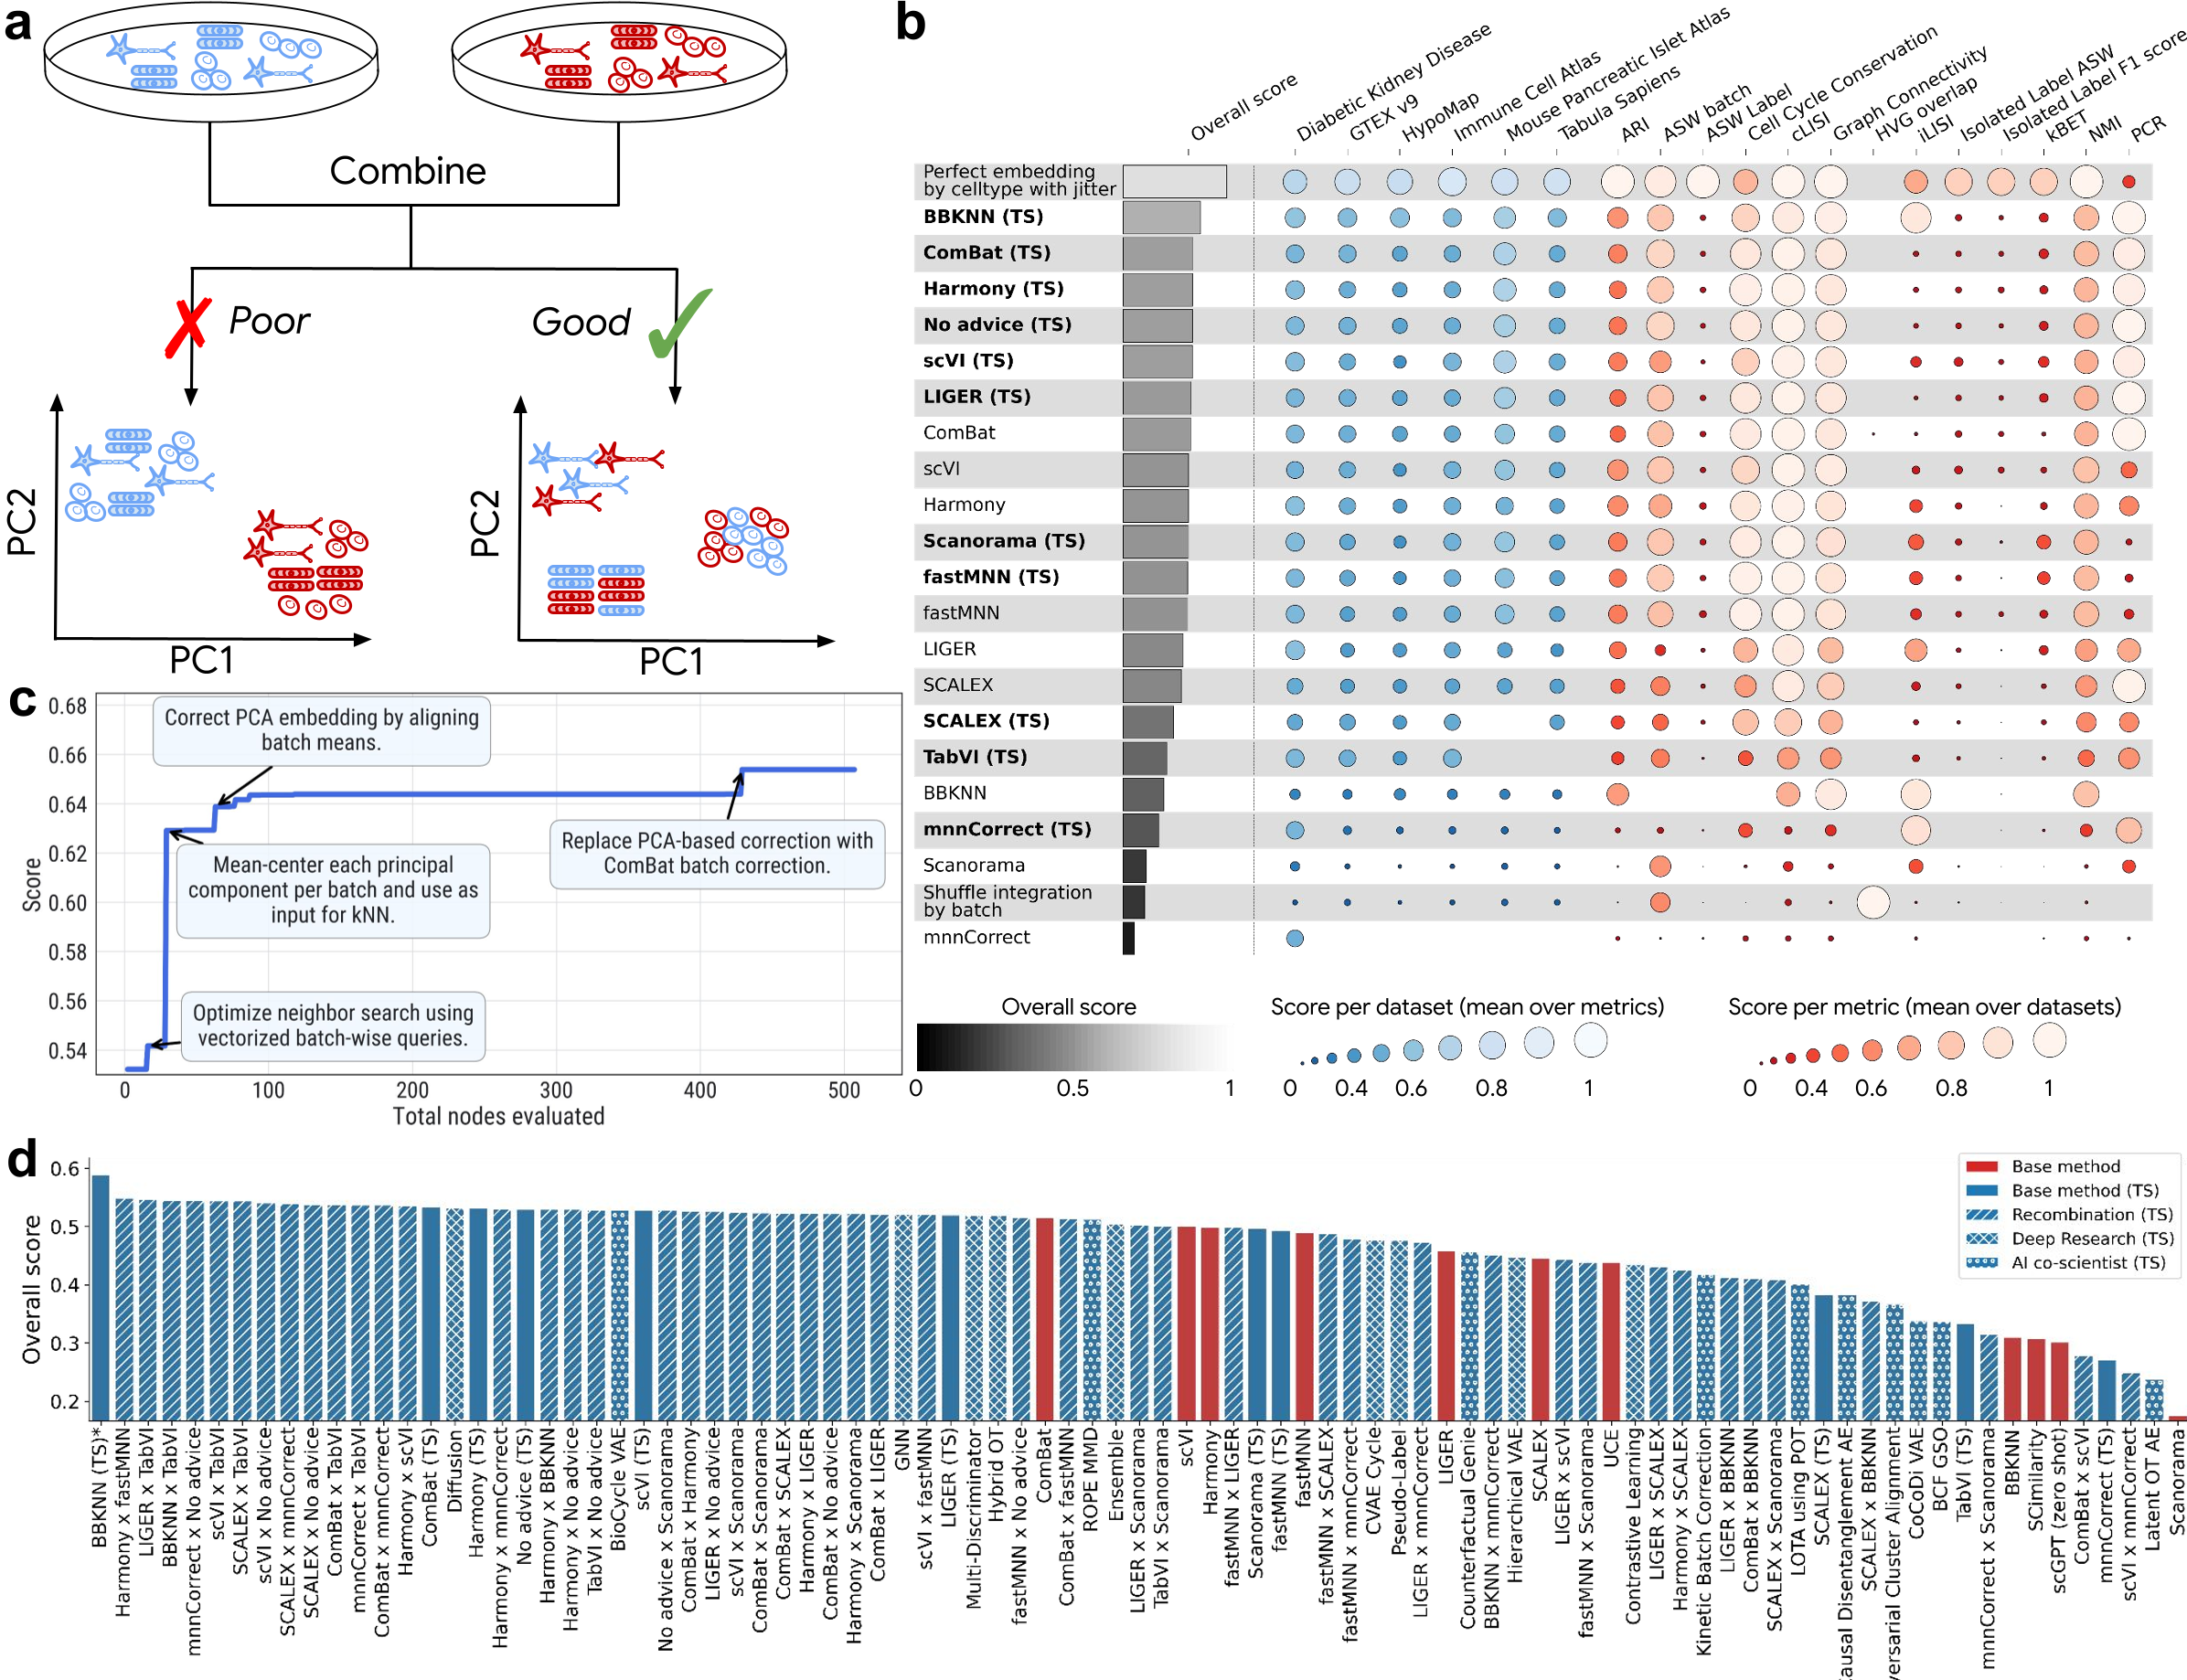 图 2:ERA 生成的模型与 OpenProblems 排行榜上人类专家方法的性能对比
COVID-19 流行病预测
在流行病学预测中,ERA 生成的 14 个模型性能超过了 CDC 的官方集成模型。实验显示,AI 能够自主学习如何平衡历史趋势与最新的传染动力学模型。
深度洞察:科学研发的“缩时”效应
ERA 的出现标志着科学研究中“实验软件开发”这一环节正在从手工业转向自动化流水线。
- 速度提升:以前需要博士生花费数周甚至数月去探索的代码方案,ERA 在 500-1000 个节点的内(约数小时)就能完成探索并取得突破。
- 超越超参数优化:ERA 改变的是代码逻辑本身,而非仅仅调整参数。
局限性与风险
虽然 ERA 在“经验性能优化”上无往不利,但作者坦言,它目前还无法进行跨越式的原始科学理论发现(即它擅长优化已有逻辑,而非凭空创造质能方程)。此外,自动化的高级编程能力也带来了潜在的安全风险。
总结
ERA 证明了:只要一个问题能被定义为“可评分的软件任务”,AI 就能通过暴力搜索和逻辑重组,在极其复杂的科学领域达到并超越人类专家的水平。这不仅仅是编程的进步,更是科研方法论的升级。