
AdaptiveFlow:用 18 维属性网格把 690 亿分子的虚拟筛选成本砍掉三个数量级
s41587-026-03217-x.pdf
本文提出 AdaptiveFlow,一个面向超大规模虚拟筛选(ULVS)的开源平台,核心创新是自适应目标引导虚拟筛选(ATG-VS)方法。作者将 Enamine REAL Space 整理为全球最大的 ready-to-dock 化合物库(690 亿分子),用 18 维分子属性网格划分化学空间,并通过代表性分子的预筛选优先探索高潜力子空间。在 FSP1 与 PARP1 两个靶点上,该平台分别发现了纳摩尔级抑制剂,并获得了共晶结构验证。
TL;DR
早期药物发现面临一个根本性的张力:可合成的类药分子空间估计超过 ,而可购买的在库化合物已从 2020 年的约 20 亿膨胀到万亿量级,但穷举对接每一个分子的算力成本随之爆炸。AdaptiveFlow 给出的答案是不穷举:把 690 亿分子的 Enamine REAL Space 整理成 ready-to-dock 格式,用 18 个物理化学属性将化学空间划成约 1200 万个 tranche,先只对接每格的代表分子(约 1200 万次对接,比全库筛选少 5000 倍计算量),再依据预筛选分数锁定高潜力子空间做全量筛选。在十个蛋白靶点上,该方法用 10 万次对接的预算击败了 100 万随机化合物的标准筛选;在 FSP1 和 PARP1 上分别拿到纳摩尔级抑制剂,其中 iParp1 的 IC50 为 8.8 nM,与 FDA 批准的 olaparib 相当。
背景定位
这是一篇典型的系统性工程 + 方法改进混合型工作,其定位更接近「平台级基础设施建设」而非单点算法创新。判断依据有三:其一,作者同时交付了三样东西——一个 690 亿分子的 ready-to-dock 化合物库、一个开源筛选平台(GNU GPL v2.0)、以及一套端到端的实验验证流程;其二,方法层面的核心贡献 ATG-VS 并不是一个全新的打分函数或对接算法,而是一种搜索空间缩减策略,其正确性依赖的是经验基准而非理论证明;其三,论文在 Discussion 中明确把平台定位为「支持生成模型和强化学习管线的评估后端」,说明作者瞄准的是社区基础设施而非单项 SOTA。
理解这一点很重要,因为它决定了我们应该用「基础设施是否降低了领域门槛」而非「某个指标是否刷新纪录」来评价这篇工作。
问题与动机
现有 ULVS 的困境可以拆成三个具体的失效机制。
第一是成本随库规模超线性增长。 论文指出,可购买的按需合成分子数已达 3 万亿量级(Introduction),而最新的库已超过 1 万亿化合物。在这样的规模上,即使使用云端算力,穷举对接的财务成本也「使其变得不切实际」。这不是工程优化能解决的问题——库的增长是指数式的,而单次对接的成本下降是线性的。
第二是灵活性缺口。 有效的虚拟筛选需要针对不同靶点类别灵活组合对接算法,因为不同算法建立在不同的理论基础之上、需要不同的输入格式。现有平台往往把用户锁死在少数几个对接程序上,难以匹配 RNA、DNA、共价配体、蛋白-蛋白相互作用界面这些形态各异的靶点。
第三是扩展性天花板。 论文明确指出,很多现有平台局限于 CPU,而此前版本的 AdaptiveFlow 只被证明能扩展到 16 万 vCPU。在需要数小时内完成数十亿分子筛选的场景下,这个数量级远远不够。
作者的直觉是:能与某个特定口袋最佳结合的分子占比极小,而且它们共享特定的分子特征(原文 Adaptive ULVSs 一节)。因此算力应该被导向「最可能含有命中物的化学子空间」,而不是均匀撒在整个库上。这个直觉不是空想——它建立在虚拟筛选性能随库规模提升的经验规律上(库越大,命中物的效价越高、命中率越高),同时也被论文自己的对比所支撑:此前识别 KEAP1-NRF2 纳摩尔抑制剂需要无偏筛选 13 亿分子,而这次 FSP1 的 ATG 引导筛选仅用 2200 万次对接就达到相近的成功度。但需要注意,作者也承认这种聚焦策略的效果依赖靶点,并非普遍成立。
核心章节
出发点:把 690 亿分子装进一张 18 维表格
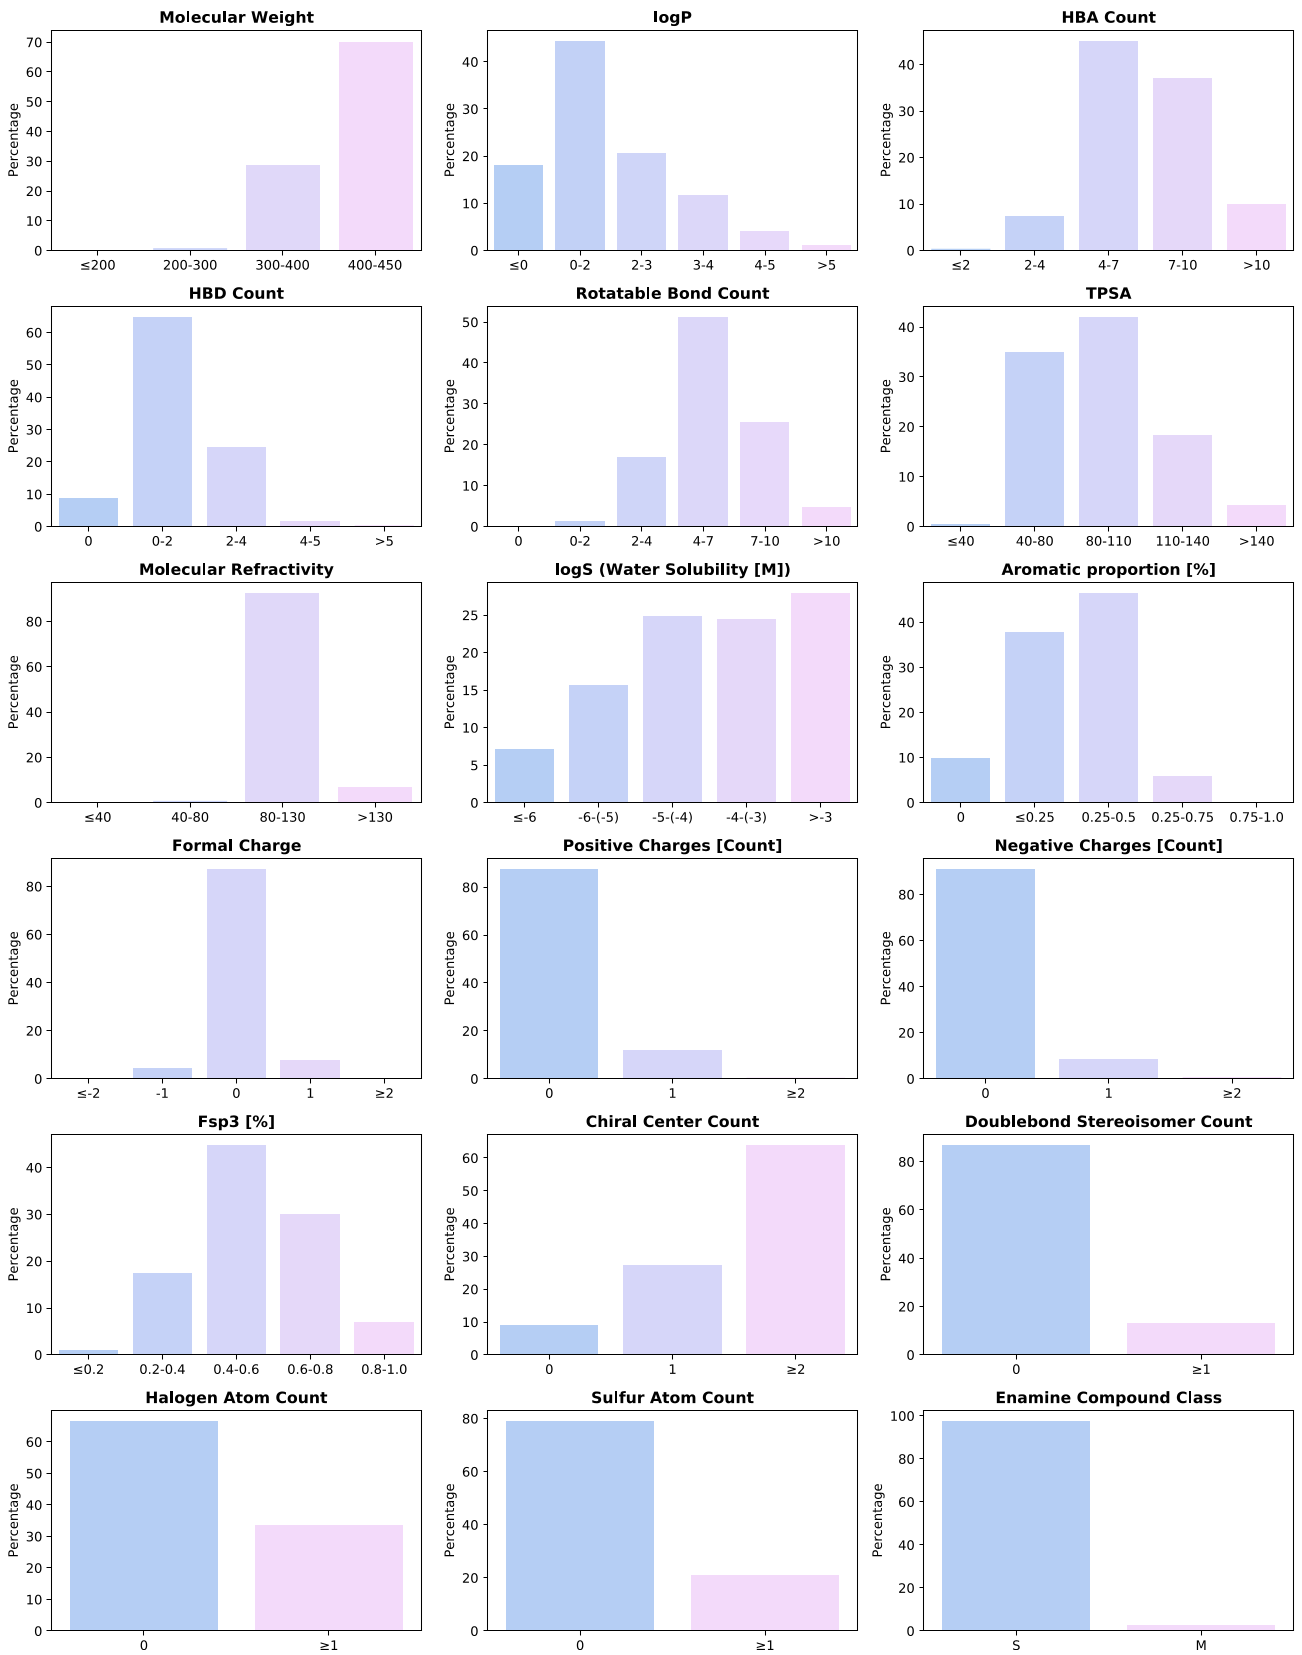
平台中最基础也最容易被忽视的一环是化合物库的组织方式。Enamine REAL Space(2022q1-2 版本)原始包含 31,507,987,117 个枚举分子,经配体准备后因立体异构体和互变异构体枚举扩张到 68.7 亿——准确说是 68.7 billion。作者为每个分子计算了 28 个物理化学属性与化学信息学描述符,再从中选出 18 个构建多维矩阵:
| 维度 | 属性 | 取值区间数 |
|---|---|---|
| 1 | 分子量 | 5 |
| 2 | logP | 6 |
| 3 | 氢键受体数 | 5 |
| 4 | 氢键供体数 | 5 |
| 5 | 可旋转键数 | 6 |
| 6 | TPSA | 5 |
| 7 | 摩尔折射率 | 4 |
| 8 | logS | 5 |
| 9 | 芳香比例 | 5 |
| 10 | 形式电荷 | 5 |
| 11 | 正电荷数 | 3 |
| 12 | 负电荷数 | 3 |
| 13 | Fsp3 | 5 |
| 14 | 手性中心数 | 3 |
| 15 | 双键立体异构体数 | 2 |
| 16 | 卤素原子数 | 2 |
| 17 | 硫原子数 | 2 |
| 18 | Enamine 化合物类别 | 2 |
这 18 个维度经离散化后理论上构成 244 亿个可能的 tranche,而 REAL Space 的分子实际只占据其中约 1200 万个,平均每个被占据的 tranche 含约 5600 个分子。Extended Data Fig. 1 给出了每个维度的分箱方案与各区间化合物数(以热力图着色),Extended Data Fig. 2 则展示了每个属性的完整分布。读这两个图能看出一个关键事实:这个 18 维矩阵极其稀疏——大量 tranche 完全是空的。作者在正文中把这一点解读为机会而非缺陷:未占据的 tranche 意味着可通过对合成活动的定向投入去填补的化学空间。
维度数为什么是 18 而不是更多?作者给出的理由是显式的:18 个属性是「在药物发现相关的化学意义与计算效率之间的平衡」,因为维度过高会导致稀疏性加剧、降低实际可操作性(Enamine REAL Space 一节)。论文没有给出把维度从 18 增加到 19 或 20 的消融实验,这是一个未被验证的设计边界。
核心内容:ATG-VS 的四步漏斗
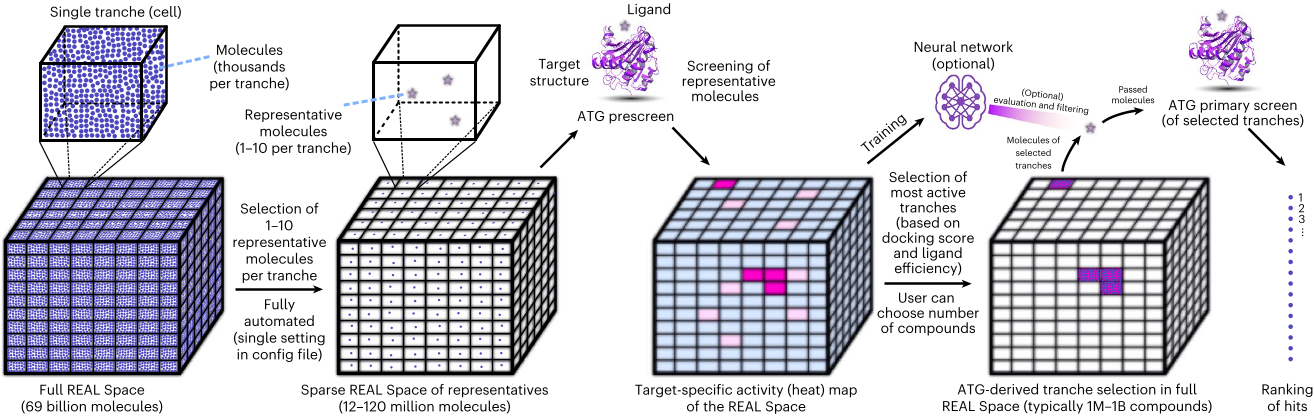
ATG-VS 的完整流程由四个步骤构成,Fig. 3 给出了概念示意。这里的每一步都有明确的预算含义。
第一步是库分解。 对每个 tranche 选取 1 至 10 个代表性分子。若每格取 1 个,全库预筛选恰好需要 1200 万次对接。当用户选择多于 1 个代表分子时,同格内的额外分子会被自动选择为彼此多样,避免代表集合内部冗余。
第二步是 ATG 预筛选。 这里有一个可选但成本收益极高的技巧:用户可以基于 18 维属性施加动态过滤,比如根据目标口袋的特征限定分子量、logP、TPSA 的取值范围,从而在预筛选之前就把待对接的 tranche 数进一步压缩。预筛选结束后,对接分数最好的若干 tranche 进入下一阶段。
第三步是活跃 tranche 选择。 论文给出两种选择策略:其一,从 18 维矩阵中手动挑出单个 tranche,提供细粒度控制;其二,限定在一个超矩形区域内——即先在 18 个属性维度中各自识别表现最好的区间(bin),再计算它们的笛卡尔积,形成一个结构化且化学多样的 tranche 子集。第二种策略是论文生产级基准测试中实际使用的。
第四步是活跃格筛选。 进入这一阶段的 tranche 会被全量筛选,但在此之前还会插入一个 ML 分类模型来进一步筛选格内分子:
其中 是待分类的分子, 是 RDKit 生成的长度 1024、半径 2 的 Morgan 指纹, 是四层全连接网络(输入 1024 维,隐藏层 512、256、128,ReLU 激活), 是 sigmoid 输出层, 是预测的结合概率,取值在 0 到 1 之间。这个模型的作用是在对接之前做一次廉价的预判:只有 的分子被保留做全量对接,其余被过滤掉。训练标签来自预筛选阶段已经获得的对接分数,采用基于百分位的阈值化——对接分数最负的前 25% 标记为正样本(「高置信结合物」),其余为负样本,训练时对多数类做下采样以缓解类别不平衡。
这个设计的关键在于目标函数的选择:为什么用对接分数的 75 百分位而不是绝对阈值?论文未直接说明理由,但从方法论上看,绝对阈值会让不同靶点(对接分数分布不同)需要重新调参,而百分位阈值使流程对分数尺度不敏感。这一过滤步骤通常能减少 30%–70% 的待对接分子数(ML classifier for tranche prioritization 一节),且保持或提升命中富集度。若把这一步去掉,退化的就是论文中的 100K ATG 配置——实验显示它仍然优于随机筛选,但不如叠加 ML 的版本。
依据与代价:并行架构与规模验证
ATG-VS 的有效性依赖一个前提:平台能够以可接受的墙上时间完成千万到亿级的对接。这正是工程层面的贡献所在。
AdaptiveFlow 被完全重写为 Python(此前版本是 Bash),核心的并行化抽象是三级结构:collection(约 1000 个配体一组,用于摊薄调度开销)、subjob(一个或多个 collection 构成的计算原子单元)、work unit(多个 subjob 的聚合,作为 job array 发送给调度器)。这个设计好处有二:一是把调度粒度与计算粒度解耦,二是让 spot 实例的中断变得可管理——论文指出 subjob 的运行时长被刻意控制在约 30 分钟,配合 AWS Batch 自动重跑提前退出的任务,实测只有不到 0.1% 的 CPU 小时因抢占而中断。
在 AWS 上,平台实现了最高 560 万 vCPU 的近线性扩展(Supplementary Fig. 2),相比此前版本演示的 16 万 vCPU 提升了一个数量级以上。这个数字的实际意义是:涉及数十亿化合物的 ULVS 能在数小时内完成,而在传统本地集群上这需要数周到数月。代价方面,论文明确标注了存储开销——ready-to-dock 库在 PDB、PDBQT、MOL2、SDF 四种格式下各约 50 TB(压缩态),总计约 200 TB,未压缩约 2 PB。这是一个不容忽视的门槛,尽管库托管在 AWS Open Data 上、用户无需本地存储即可使用。
实验与证据
主结果:ATG 用十分之一预算打败随机筛选
论文的基准测试分两类:一类使用 500 万化合物的子集做快速原型验证,一类使用全部 690 亿分子做生产级验证。
测试集基准的结果在 Fig. 4 中以小提琴图呈现。三种配置的对比是:
| 筛选策略 | 对接次数 | 相对表现 |
|---|---|---|
| 标准 ULVS(随机) | 100 万 | 基线 |
| ATG-VS | 10 万(含预筛选) | 优于随机筛选 |
| ATG-VS + 主动学习 | 10 万(含预筛选) | 进一步改善富集 |
需要强调这里的对比是不对称的:ATG 两种配置的总对接预算(含预筛选)只有 10 万次,而随机筛选用了 100 万次。也就是说,ATG 在预算少一个数量级的前提下取得了更好的 top 50 对接分数。Fig. 4 中黑色圆点代表单个数据点,小提琴图上方的数字是 top 50 命中的平均对接分数。
生产级基准(Extended Data Fig. 6 和 7)的规模更大:标准 ULVS 从全库随机抽 1 亿化合物,ATG-VS 则做 1200 万化合物的预筛选(每格 10 个代表分子),随后做最多 100 万化合物的主筛选,并在十个靶点上系统改变主筛选深度(1 万、10 万、100 万)。作者报告 ATG-VS 取得了与标准 ULVS「相当或更优」的 top 对接分数,同时所需对接评估次数大幅减少。值得注意的是,这一设置下未启用主动学习,目的是单独隔离 tranche 优先化的效果。
拆解性证据
论文做了三类拆解实验,每一类都对应一个具体的设计选择。
其一,预筛选参数的敏感性。 作者比较了三种配置:(1) 每格 1 个代表分子配合穷举度 1;(2) 每格 10 个代表分子配合穷举度 1;(3) 每格 1 个代表分子配合穷举度 10。结果在 Extended Data Fig. 5 中给出,包含每个属性的每个 tranche 的平均对接分数与排名。作者的核心结论是三种配置「相对相似」,因此配置 (1) 对多数应用已经足够。这个结论直接支撑了「预筛选只需 1200 万次对接」这一成本底线。但需要指出,这个比较是在单个测试系统上完成的,论文未报告多靶点的重复。
其二,对接协议的鲁棒性。 作者用 Smina(Vinardo 打分函数)和 GWOVina(含柔性侧链对接)重复了基准测试。结果显示基于物理化学属性的分箱「独立于所用对接协议」仍然有效,平均 top 50 预测结合亲和力相对随机筛选有改善,计算成本仍显著更低(Supplementary Fig. 13)。这是论文证据中最有说服力的一项——它说明 ATG-VS 增益的来源不是某个特定打分函数的偏置,而是属性分箱与结合潜力之间存在的普遍相关性。
其三,目标依赖性的诚实披露。 论文指出 ATG 的改善幅度「随靶点的生物物理性质而变化」。具体而言,具有复杂、特征丰富结合口袋的蛋白——特别是那些同时具备大面积疏水表面和明确极性亚口袋的——从 ATG 优先化与 ML 增强中获益最大。这是一个重要的限定条件:它意味着该方法的增益不是均匀分布的,对于口袋浅、动态或定义不清的靶点,效果可能显著打折。
实验验证
平台在 FSP1 和 PARP1 上的表现是论文说服力的关键。
FSP1 方面,作者先通过祖先序列重建获得了四足动物祖先版本的 FSP1,与人类酶有 72.5% 序列同一性、保留全部活性位点残基,在大肠杆菌中表达量约 100 mg/L、Tm 为 62 摄氏度、保留完整酶活。用这个结构做了 ATG 筛选:每格 1 个代表分子(1200 万次对接)做预筛选,随后用 ATG-VS 主筛选 1000 万化合物。应用了 logP 低于 5、logS 高于负 5、TPSA 低于 140 平方埃、立体中心数不超过 3 等基础过滤后,从 37 个不同簇中订购了 42 个化合物,33 个成功合成并测试。其中两个命中物 afi-FSP1-1 和 afi-FSP1-2 的 Ki 分别为 0.283 微摩尔和 0.777 微摩尔。共晶结构显示 afi-FSP1-1 以延伸构象占据辅酶 Q 结合位点,其中心羰基氧与黄素的 N(3)H 形成氢键——这与辅酶 Q 泛醌头部的羧基氧建立的相互作用类似。后续一轮基于复合物结构的再筛选返回了 20 个类似物,其中 4 个(afi-FSP1-3 至 afi-FSP1-6)显示出三位数纳摩尔到低微摩尔范围的抑制活性。
PARP1 方面,预筛选加 1 亿化合物主筛选后合成 160 个候选物,两浓度酶学 HTS 识别出 7 个抑制剂,其中 4 个的 IC50 低于 250 nM。iParp1 的 IC50 为 8.8 nM,与 olaparib 相当。作者特别强调,这些命中物来自纯粹虚拟筛选,没有任何已知抑制剂的先验知识或药物化学优化。X 射线晶体学解析了 2.05 埃的 PARP1 催化域结构,验证了结合模式;BRCA1 缺陷型三阴性乳腺癌细胞的克隆形成实验显示 iParp1 和 iParp2 具有选择性细胞毒性,尽管 iParp1 因水解导致膜通透性差、细胞活性有所降低。
证据质量评估
哪些结论是稳健的,哪些是有条件的,需要区分清楚。
跨设置稳健的结论有三条:ATG 优先化优于随机筛选(在十个靶点、两种规模、三种对接协议下一致);ML 分类器叠加能进一步提升富集(Fig. 4);平台能在数百万 vCPU 上近线性扩展(Supplementary Fig. 2,且 AFLP 和 AFVS 共享并行机制,作者据此推断 AFVS 扩展性与 AFLP 相同)。
有条件或证据较弱的结论也有三条。第一,预筛选参数不敏感性的结论基于单个测试系统(Extended Data Fig. 5),论文未报告跨靶点重复。第二,主动学习的效果只在 500 万化合物子集上验证过,生产级基准中刻意未启用它,所以「主动学习在 690 亿规模下仍能带来增益」目前只是作者的推测而非实测(原文表述为「基于测试集基准,我们预期纳入主动学习能带来进一步的效率与富集改善」)。第三,FSP1 和 PARP1 的成功属于案例研究,两个靶点都有明确的、结构已解析的结合口袋,这与作者自己指出的「复杂特征丰富口袋获益最大」相吻合——也就是说,这两个成功案例恰恰落在方法的最有利区间内。
深度洞察与总结
总结
AdaptiveFlow 的核心贡献可以归结为一个具体机制:用属性网格把连续的化学空间离散化为可导航的 tranche 结构,从而把「筛选全库」转化为「筛选高潜力子空间」。这个转化的经济学意义是清晰的——预筛选 1200 万 vs 全库 690 亿,是超过 5000 倍的计算量缩减;配合 ML 分类器再减少 30%–70% 的待对接分子;配合 GPU 加速与深度学习对接方法还能再获得 10–100 倍的吞吐提升(Discussion 一节)。三个层次叠加起来,构成了从「不可行」到「数小时内完成」的跨越。
更深一层看,这篇工作的价值不只在于省算力,还在于它把化学空间的探索从被动搜索变成主动选择。作者在 Discussion 中的判断值得引用:随着化学空间的持续扩张,聚焦靶点特异子空间「将不再是可选项,而是必需品」。
局限性
第一,18 维这个数字缺乏消融支撑。作者给出的是「过高维度导致稀疏、降低可操作性」这一原则性论证,但没有报告 15 维、20 维或 25 维的对比实验。这意味着该超参数的选取是经验性的,跨不同靶点类别是否仍为最优未被验证。
第二,主动学习闭环的规模化效果未经实测。论文描述的闭环机制——每轮筛选产生新标记数据、重训模型、选择下一批——在概念上很完整,但生产级基准中并未启用。考虑到 ML 分类器的训练数据来自预筛选的代表分子(数量级为千万),在 690 亿规模下模型是否会因训练集与实际筛选空间分布不匹配而退化,是一个悬而未决的问题。
第三,FSP1 和 PARP1 的验证属于有利设置。两个靶点都有高分辨率晶体结构作为受体输入,且结合口袋定义清晰。论文没有给出在冷冻电镜低分辨结构、或口袋高度动态的靶点上使用该平台的案例,而这恰恰是传统虚拟筛选最吃力的场景。
第四,预筛选参数的不敏感性只在单一测试系统上验证。若某类靶点的对接分数方差很大,每格 1 个代表分子可能不足以稳定估计该格的潜力,此时配置 (2) 或 (3) 可能成为必要——论文未探讨如何预判该选哪种配置。
未来展望
从技术路线看,这项工作最值得跟进的延伸有两个方向。
其一是主动学习与生成模型的耦合。平台已经支持 SELFIES 表示(每一条 SELFIES 字符串都对应合法分子,这使生成模型无法产生无效分子)并把对接分数暴露为可用的目标函数,这意味着它可以充当生成式分子设计的评估后端。但论文只做了被动筛选的闭环,未做「生成—评估—再生成」的主动设计闭环。如果把这个循环跑通,化学空间的探索将从「从既有库中选择」升级为「定向合成新的 tranche」,而论文自己已经指出未占据 tranche 代表了可填补的机会空间。作者在 Discussion 中提到,随着分子胶和靶向蛋白降解剂等模态成熟,识别能结合特定蛋白表面并产生功能后果的小分子将越来越有价值——这类分子往往不在现有合成库中,恰好需要生成式方法配合。
其二是功能性选择性抑制的设计逻辑。FSP1 研究中出现了一个耐人寻味的现象:afi-FSP1-1、afi-FSP1-2 和 afi-FSP1-3 对 NADH 氧化酶活性的抑制效力比其对辅酶 Q 还原活性的抑制弱 10 到 12 倍,afi-FSP1-4 则完全无效力。晶体结构解释了原因——抑制剂的结合保留了 NAD(P)H 的结合能力。作者由此提出一个假说:优先抑制醌还原活性而保留与氧的反应性,可能具有药理学益处,因为这类抑制剂能把酶从抗铁死亡状态转化为促铁死亡状态。论文明确声明这一概念「需要在 FSP1 药理学中进一步探索和验证」。这是一个典型的由结构生物学驱动的、可证伪的机制假说,如果成立,它将为铁死亡相关癌症治疗提供一个新的设计原则——不是简单地抑制酶,而是重新平衡它的两条反应路径。