
SAGE:为什么最尖端的 LLM 检索器在深度研究 Agent 中败给了 BM25?
SAGE: Benchmarking and Improving Retrieval for Deep Research Agents
本文推出了 SAGE 评估基准,专门用于衡量 Deep Research Agent 在科学文献检索中的推理能力。研究发现,虽然 LLM-based 检索器在其他领域表现强劲,但在 Agent 工作流中,传统的 BM25 稀疏检索器性能反而高出约 30%,为此作者提出了库级推理扩展(Corpus-level Test-time Scaling)框架进行优化。
TL;DR
在 Deep Research Agent(深度研究智能体)飞速发展的今天,我们默认“更强的 LLM 检索器 = 更好的结果”。然而,由 OpenAI、耶鲁大学等机构联合发表的最新 SAGE 基准测试给出了一个令人惊讶的结论:在科学文献检索任务中,传统的 BM25 竟然比最先进的 LLM 检索器强出 30%。问题的核心不在于检索器不够聪明,而在于 Agent 太喜欢用“搜索关键词”了。
背景定位:从 RAG 到 Deep Research
传统的 RAG 是“一问一答”的单次检索,而深度研究 Agent(如 OpenAI Deep Research, DR Tulu)通过多轮思考、生成子查询(Sub-queries)并反复检索来回答复杂问题。SAGE (Scientific Agentic retrieval Evaluation) 填补了该领域的空白:它包含 1,200 个横跨四大科学领域的查询和 20 万篇论文构成的语料库。
核心痛点:严重的“查询-检索 mismatch”
为什么 LLM 检索器(如 gte-Qwen2-7B)表现不佳?
- 关键词依赖:现有的 Agent 在拆解任务时,更倾向于生成一组关键词(类似 Google 搜索),而不是完整的自然语言。这对于经过自然语言指令微调的 LLM 检索器来说是“非分布”的输入。
- 长文档瓶颈:科学论文动辄上万词,LLM 检索器在处理这类超长上下文时存在明显的性能衰减。
- 多样性缺失:LLM 检索器的嵌入向量容易在长文档下趋同,导致检索结果缺乏多样性。

方法论:既然改不了 Agent,那就“改造”文档
作者提出了 Corpus-level Test-time Scaling。
既然 Agent 喜欢用关键词,我们就预先让 LLM 把每篇文档里的“考点”总结出来。
- 元数据增强:提取论文的出版年份、会议名称、引用量。
- 关键词注入:调用 Qwen3-Next-80B 提取 8 个核心语义关键词。
- 格式修补:将这些信息以强调格式置于 Markdown 文件的首部。
这种方法不需要重新训练检索模型,只需在索引构建阶段多花一点推理算力,就能显著提升 Off-the-shelf 检索器的召回率。
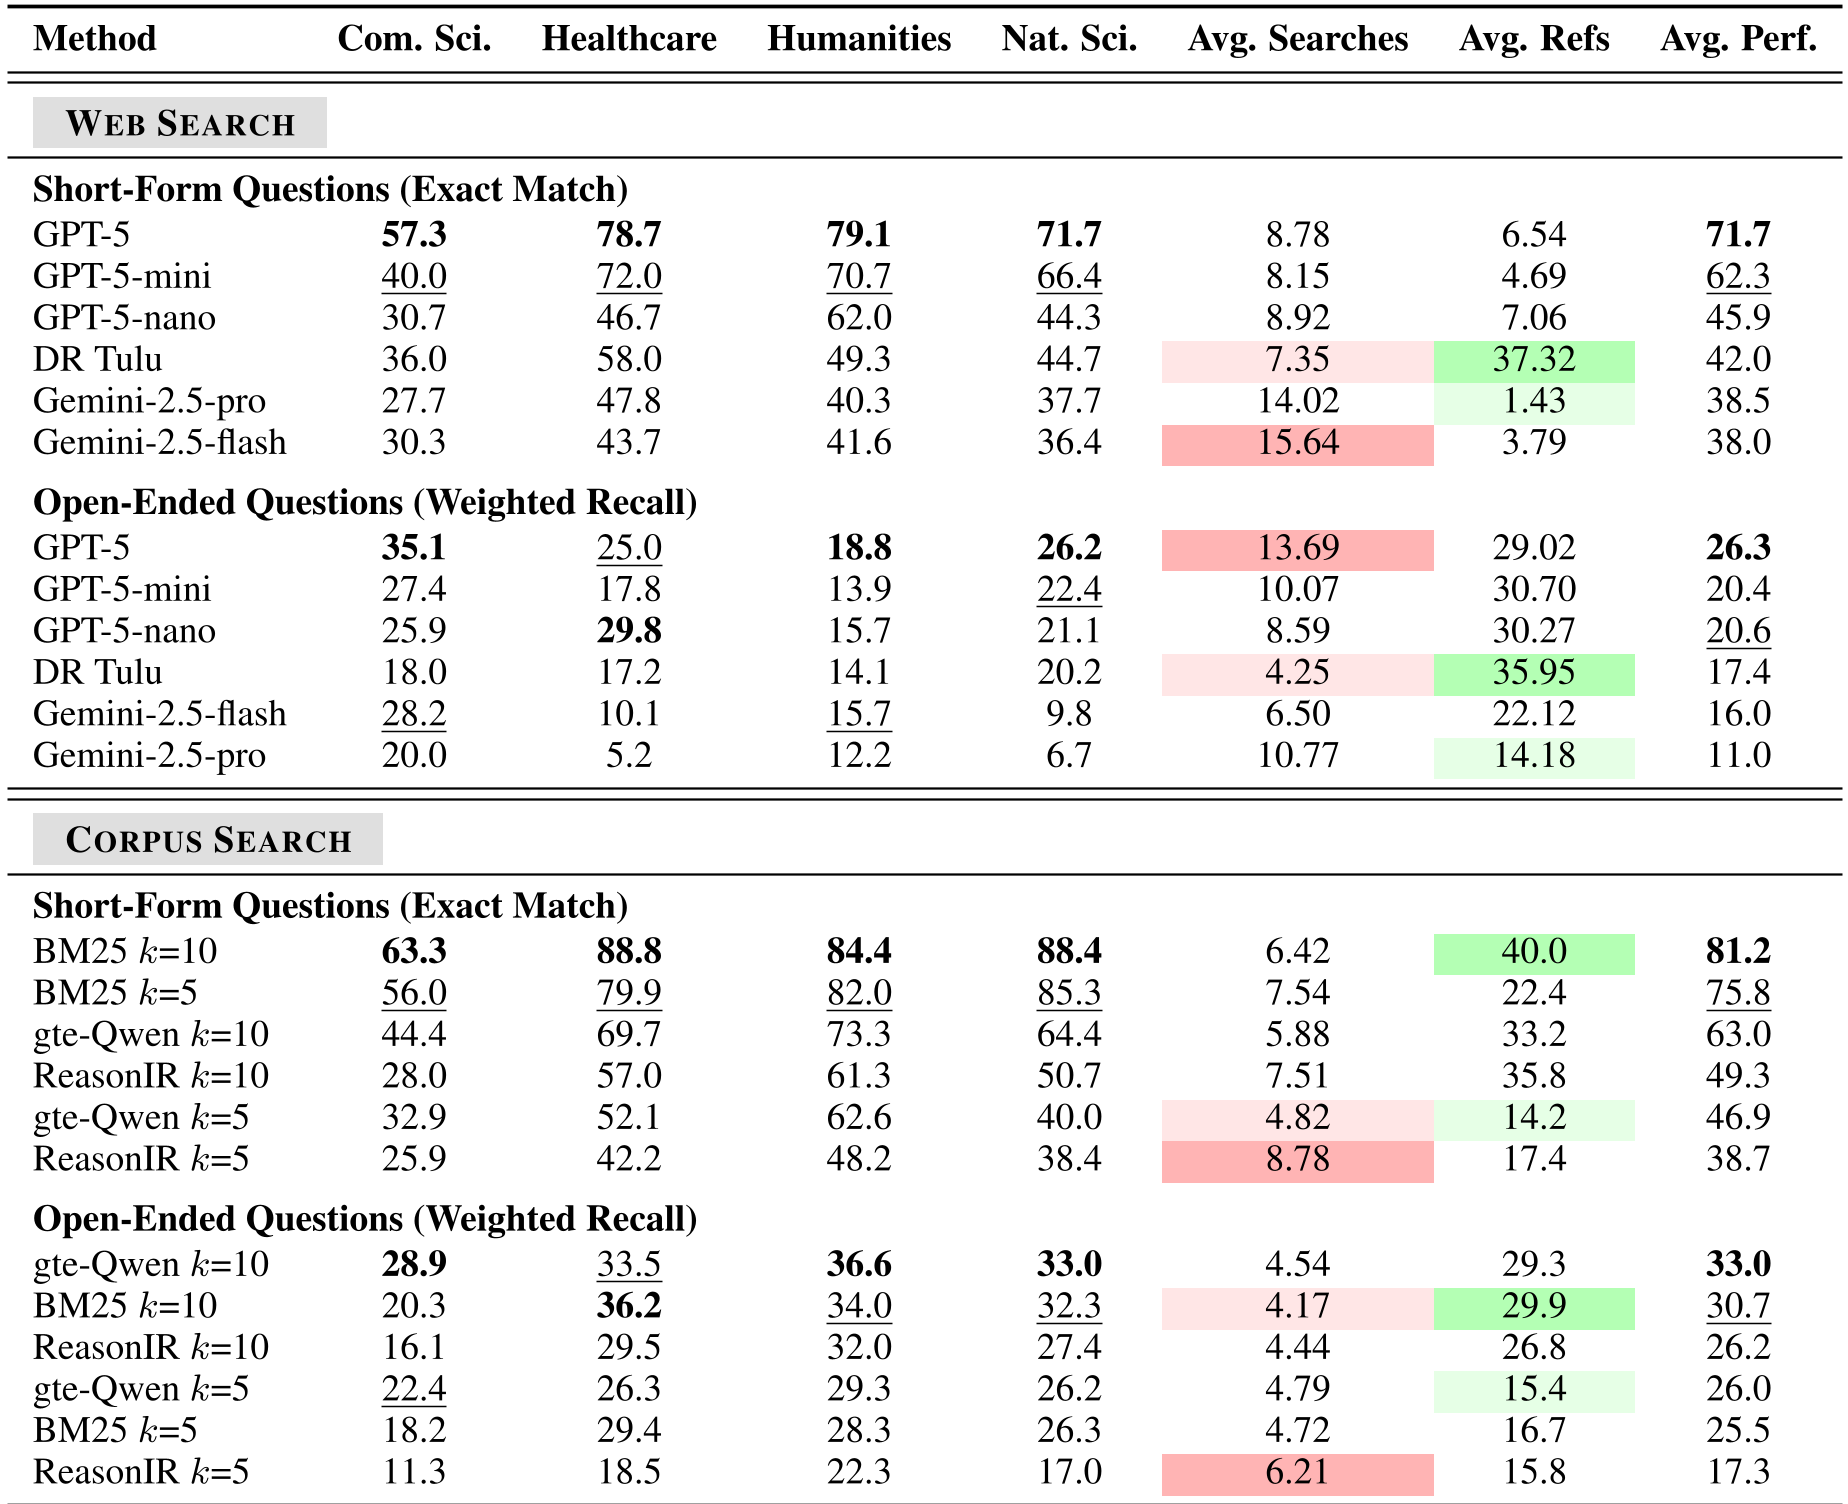
实验战绩:老将 BM25 的逆袭
在 SAGE 的 Short-form 任务中:
- BM25 (k=10) 达到了 81.2% 的准确率。
- gte-Qwen2-7B 仅为 63.0%。
- ReasonIR(专门做推理检索的 SOTA)更是只有 49.3%。
但在应用了作者提出的“库级扩展”后,BM25 进一步提升至 83.98%,通过简单的关键词预处理,我们让检索器看文档时更有“针对性”。
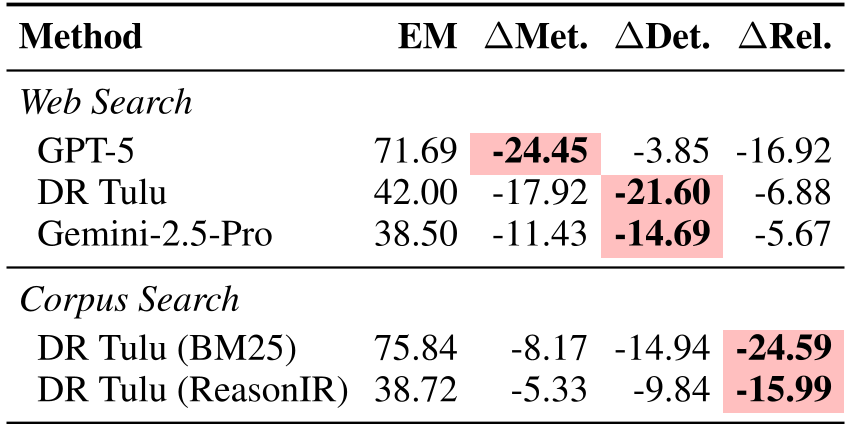
深度洞察:这对未来的 Agent 开发有何启示?
- 别迷信语义检索:在领域高度专业化、且 Agent 还在使用搜索式逻辑的阶段,BM25 的鲁棒性依然是王者。
- 检索器的独立性:现有的 Agent 训练(如 DR Tulu)往往是在 Web Search 环境下进行的,这可能导致 Agent 进化出一种“面向搜索引擎”而非“面向语义检索”的策略。未来的研究应该考虑 Retriever-aware Agent Training,让智能体学会根据后端检索器的特性来调整其“提问”姿势。
- 数据治理胜过模型调优:与其追求极致的 Retriever 算法,不如通过 LLM 对 Corpus 进行更有结构的“二次创作”。
总结
SAGE 不仅仅是一个 Benchmarking,它揭示了当前 Deep Research 技术栈中的一个关键断层。解决办法可能不全是提升模型参数,而在于更好地理解 Agent 与 Retriever 之间的“沟通协议”。
注:实验中的 DR Tulu 表现出色,在某些细分任务中甚至可以与 GPT-5 的早期版本一较高下,显示了开源 Agent 社区的巨大潜力。