
SANA-WM:单卡实现分钟级 720p 世界模型,效率起飞的 2.6B 视频视觉模拟器
SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer
SANA-WM 是一种由 NVIDIA 团队提出的 2.6B 参数视频世界模型,专门针对分钟级(一分钟)、720p 高清视频的生成进行了原生训练。该模型通过混合线性 Transformer 架构,在单卡 H100 上实现了高保真度、具备精确 6-DoF 摄像机控制的视频合成,并在效率上显著超越了 LingBot-World 等工业基线。
TL;DR
NVIDIA 的研究团队推出了 SANA-WM,这是一个极低成本、高效率的 2.6B 参数视频世界模型。它不仅能根据单张图片、文本提示和 6-DoF 摄像机轨迹 生成一分钟长度的 720p 视频,而且将原本昂贵的多卡生成任务简化到了**单张显卡(如 RTX 5090)**即可运行,生成效率比此前 SOTA 提升了 36 倍。
背景定位:长时程模拟的破局者
在当前 AI 模拟物理世界的竞赛中,"长视频"和"精确控制"始终是鱼与熊掌不可兼得。由于 Transformer 的 复杂度,生成一分钟的高清视频往往需要庞大的显卡集群。SANA-WM 的出现标志着世界模型进入了“平民化”时代,它通过架构创新证明了:不需要数千张 H100,也能训练出具有物理直觉和几何一致性的模拟器。
核心痛点:为什么长视频生成这么难?
- 内存爆炸:Softmax Attention 的 KV Cache 随帧数增长,一分钟视频的 Token 数量足以撑爆绝大多数 GPU 显存。
- 漂移现象:在长序列生成中,场景的几何结构容易发生“塌陷”或漂移,导致转了一圈回来后,房子变样了。
- 控制精准度:简单的动作标签(如“向前走”)无法满足自动驾驶或机器人仿真对度量级(Metric-scale)轨迹的要求。
架构详解:SANA-WM 的四大利器
1. 混合线性注意力 (Hybrid GDN-Softmax)
为了在保持长程记忆的同时降低开销,作者引入了 Gated DeltaNet (GDN)。
- 物理直觉:它像 RNN 一样拥有固定的隐状态(Recurrent State),并引入了“衰减门”和“增量修正”,自动减弱过时信息的影响。
- 混合策略:每 4 层 GDN 插入一层标准的 Softmax 注意力,用于精确的全局长程召回。
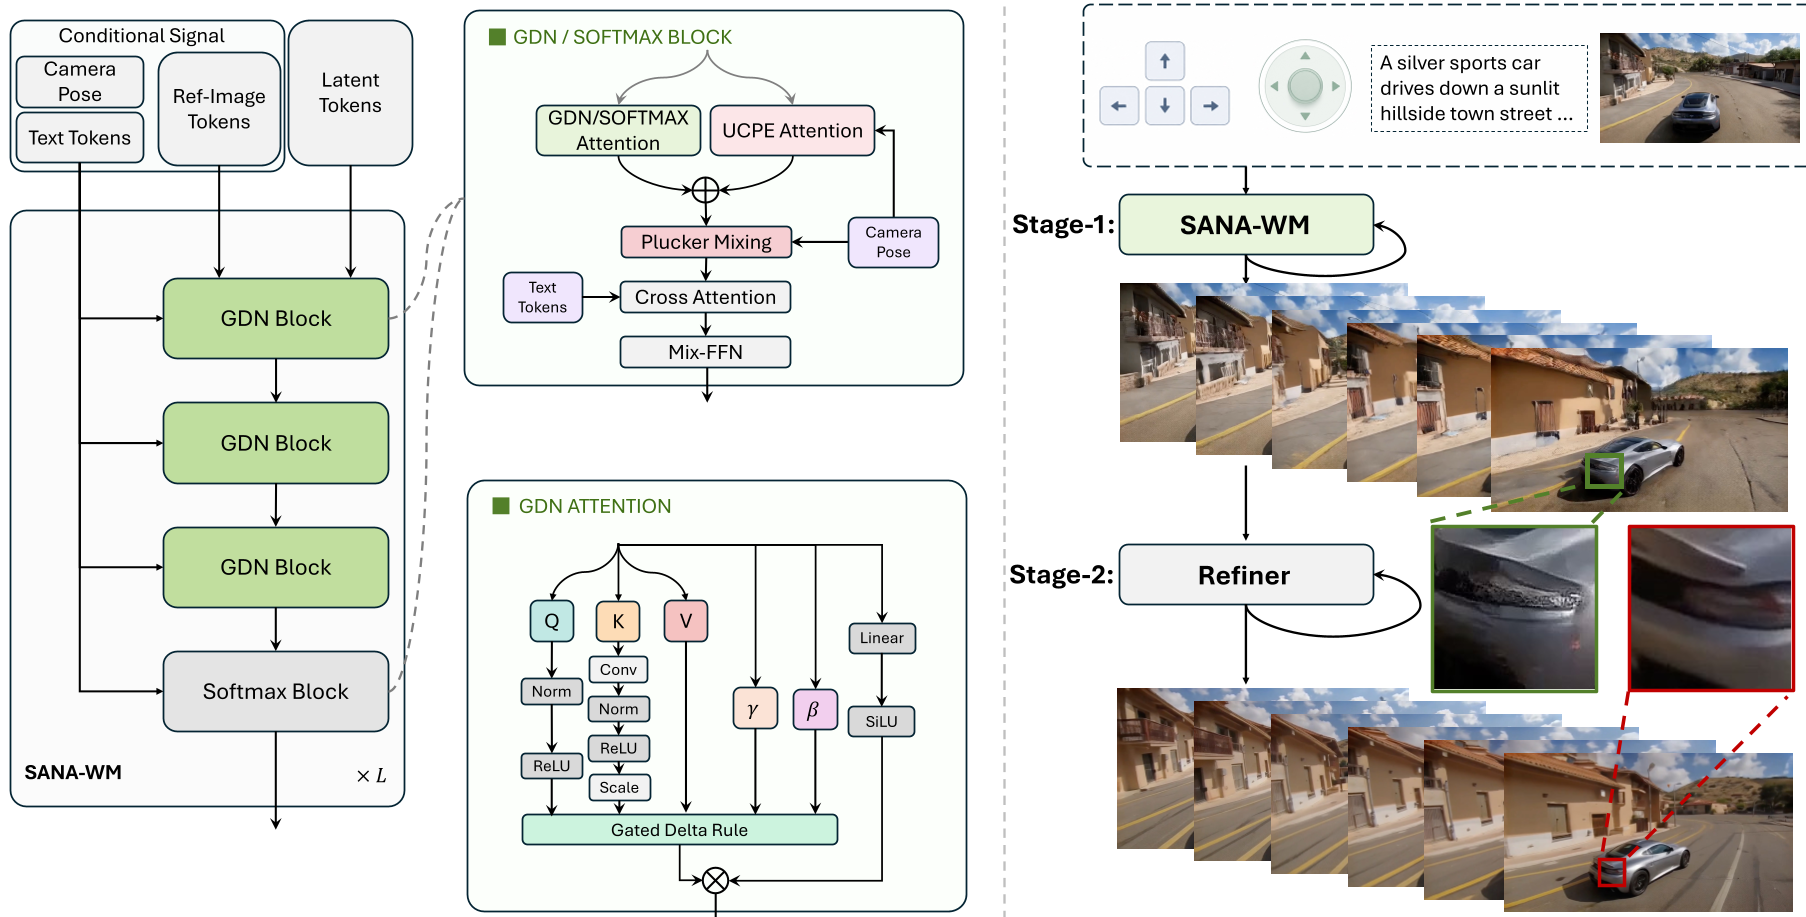
2. 双支路摄像机控制 (Dual-Branch Camera Control)
这是实现“想怎么看就怎么看”的关键。
- 粗粒度支路 (UCPE):在 Latent 层级通过摄像机位置编码捕捉整体轨迹。
- 细粒度支路 (Plücker Mixing):在 VAE 压缩的步幅内,直接修正原始像素级的摄像机微动,解决了高压缩比下动作细节丢失的问题。
3. 两阶段视觉精炼 (Refiner)
SANA-WM 采用分层生成的思想:第一阶段先用 2.6B 的小模型跑出逻辑合理的视频(类似草稿),第二阶段利用基于 LTX-2 改装的 Refiner 进行纹理锐化和结构修正。
实验战绩:单卡 34 秒的奇迹
实验结果令人震撼。在对比 LingBot-World 和 HY-WorldPlay 等重型模型时,SANA-WM 表现出了极强的统治力:
- 动作跟随:旋转误差(RotErr)降低到了 4.50°,远低于同类模型。
- 推理速度:在 H100 上,一分钟视频生成速度达到 24.1 个/小时。利用 NVFP4 量化,在 RTX 5090 上仅需 34 秒即可“去噪”生成 60 秒 720p 视频。
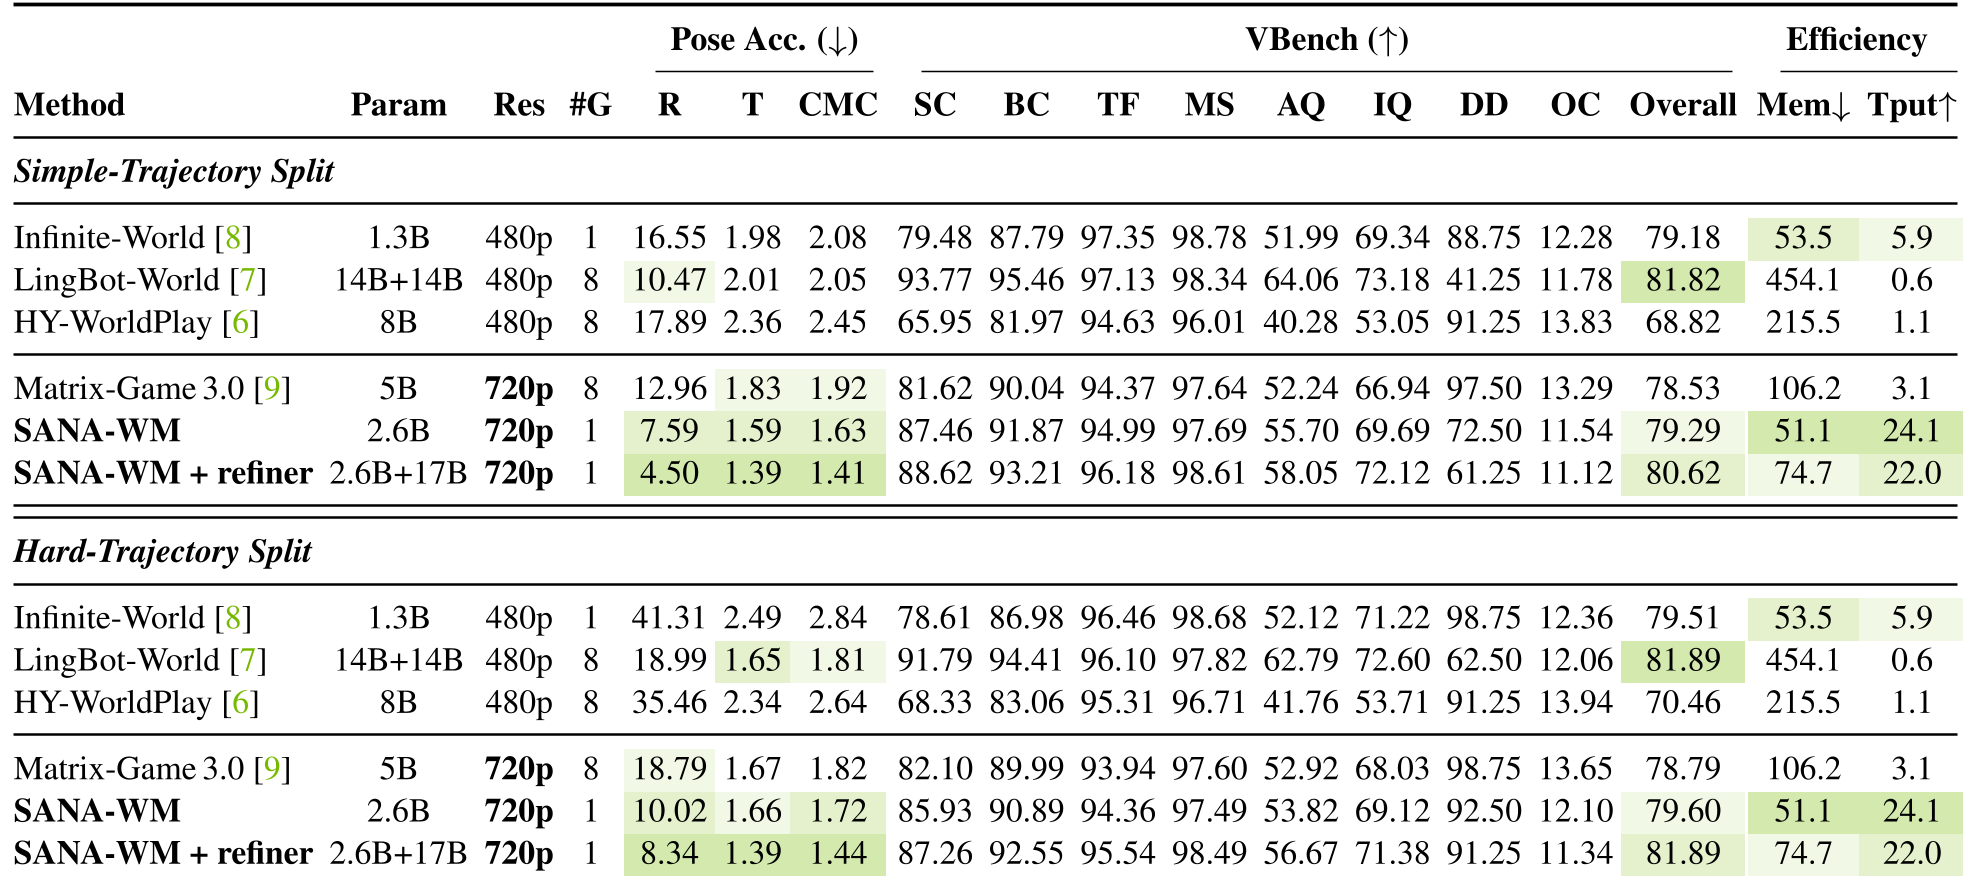
图注:SANA-WM 在保持与其参数量多倍的模型相当的视觉质量的同时,推理吞吐量(Tput)遥遥领先。
深度洞察:数据标注的基石
值得关注的是,作者解决了一个“巧妇难为无米之炊”的问题:怎么给网上的视频打上精确的位姿标签? 他们建立了一个自动化管线,结合了 Pi3X(时序一致的深度估计)和 MoGe-2(度量尺度恢复),从 213K 公开视频中榨取出了度量级的 6-DoF 标签。这意味着未来不再需要昂贵的实测数据集,就能训练强大的模拟器。
总结与局限 (Takeaway & Limitations)
SANA-WM 的核心贡献在于将计算友好性置于设计的第一位。
- 局限性:尽管目前在 60 秒生成上表现卓越,但对于动态物体极多或极端视角的场景,仍可能存在内容漂移(Lack of explicit 3D memory)。
- 未来启示:这一工作为自动驾驶仿真和具身智能训练提供了一个极其高效的底座,预示着基于单卡的高清物理模拟将很快普及。
主编评语:SANA-WM 的价值不在于“堆参数”,而在于“调架构”。通过线性注意力对 Transformer 的成功背刺,它告诉我们:算法的进步有时比算力的堆砌更加动人。