
SANA-WM:单卡实现分钟级 720p 世界模型,GPU 效率提升 36 倍
SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer
SANA-WM 是由 NVIDIA 研究团队推出的开源视频世界模型,专门针对 2.6B 参数量下的分钟级(60秒)720p 视频生成。该模型采用 Hybrid Linear DiT 架构,仅需 64 张 H100 训练 15 天,即可在单卡 GPU 上实现具备精确 6-DoF 摄像头控制的高保真长视频合成。
TL;DR
NVIDIA 团队发布的 SANA-WM 重新定义了长视频世界模型的效率标杆。作为一个仅有 2.6B 参数的模型,它实现了原生一分钟长度、720p 分辨率、带 6-DoF 摄像头控制的高质视频生成。最令人惊叹的是,它将这种工业级性能搬到了单卡 GPU 环境中,推理速度比现有 SOTA 提升了 36 倍。
背景定位:从“短时片段”到“无限模拟”
在具身智能(Embodied AI)和交互式仿真领域,世界模型是核心。然而,目前的开源模型大多面临“三难困境”:画质低(480p)、时长短(<10s)、或者算力成本极高(需多卡 H100 并行)。SANA-WM 旨在打破这一局面,通过架构创新,在有限的数据(21.3万条视频)和算力(64张 H100)下训练出具备强场景一致性的长程模型。
痛点深挖:长序列的“双重枷锁”
- 显存爆炸:标准的 Transformer 依赖 Softmax Attention,其计算复杂度随视频长度呈平方增长。一分钟的 720p 视频包含海量 Token,显存会迅速崩溃。
- 动作偏航:在视频被高度压缩(VAE)后,细微的摄像头动作(如微小的旋转、平移)在潜空间中容易丢失,导致生成的视频不听“指令”。
核心方法论:混合动力与几何感知
1. 混合线性注意力架构 (Hybrid GDN-Softmax)
作者没有盲目堆砌 Softmax,而是设计了一个“混合动力”引擎。
- Gated DeltaNet (GDN):作为主要的注意力模块,它通过循环状态(Recurrent State)来聚合帧信息,显存占用不随时间增长,且引入了 Delta Rule 修正机制,解决了传统线性注意力容易产生的特征漂移问题。
- Softmax 插值:每隔四个块插入一个标准的 Softmax 块,充当“锚点”,保证模型在长程生成时依然能精确回溯起始帧的细节。
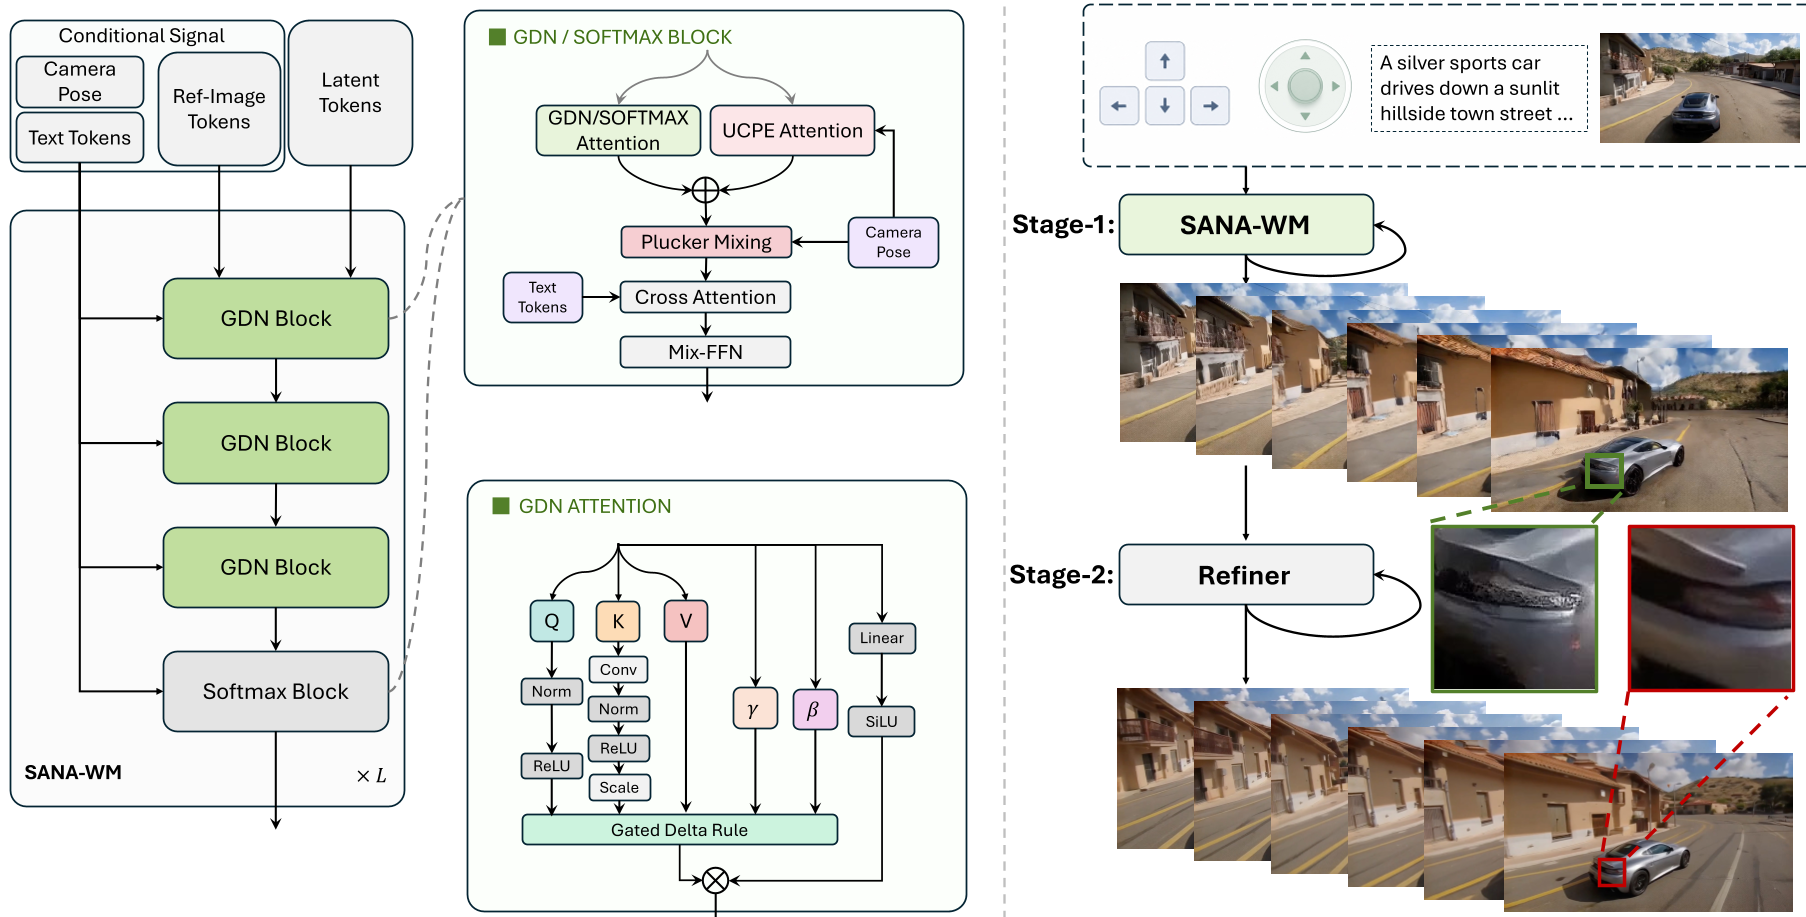 图 1:SANA-WM 整体架构,展示了 GDN 与 Softmax 的交替设计。
2. 双分支摄像头控制 (Dual-Branch Control)
为了实现毫米级的位姿遵循,模型采用了双重约束:
- UCPE 分支:在 Token 层面注入全局几何信息,确保大尺度的运动轨迹准确。
- Plücker Mixing 分支:在 VAE 的 Stride 内部(原始帧层面)注入光线图信息,补偿压缩过程中丢失的高频运动细节。
实验战绩:性能与效率的双重飞跃
在自建的 60 秒长航时基准测试中,SANA-WM 的表现堪称惊艳:
- 动作准确度:在 Hard 轨迹测试中,其位姿误差(RotErr/TransErr)远低于 LingBot-World 等庞然大物。
- 长程鲁棒性:通过 ΔIQ 指标分析发现,普通模型在 50 秒后画质会剧烈崩溃,而 SANA-WM 配合其專属 Refiner,能保持极高的画面稳定性。
- 推理速度:在 H100 上每小时可生成 24 个视频;在 RTX 5090 上使用 NVFP4 量化,生成 1 分钟高清视频仅需 34 秒。
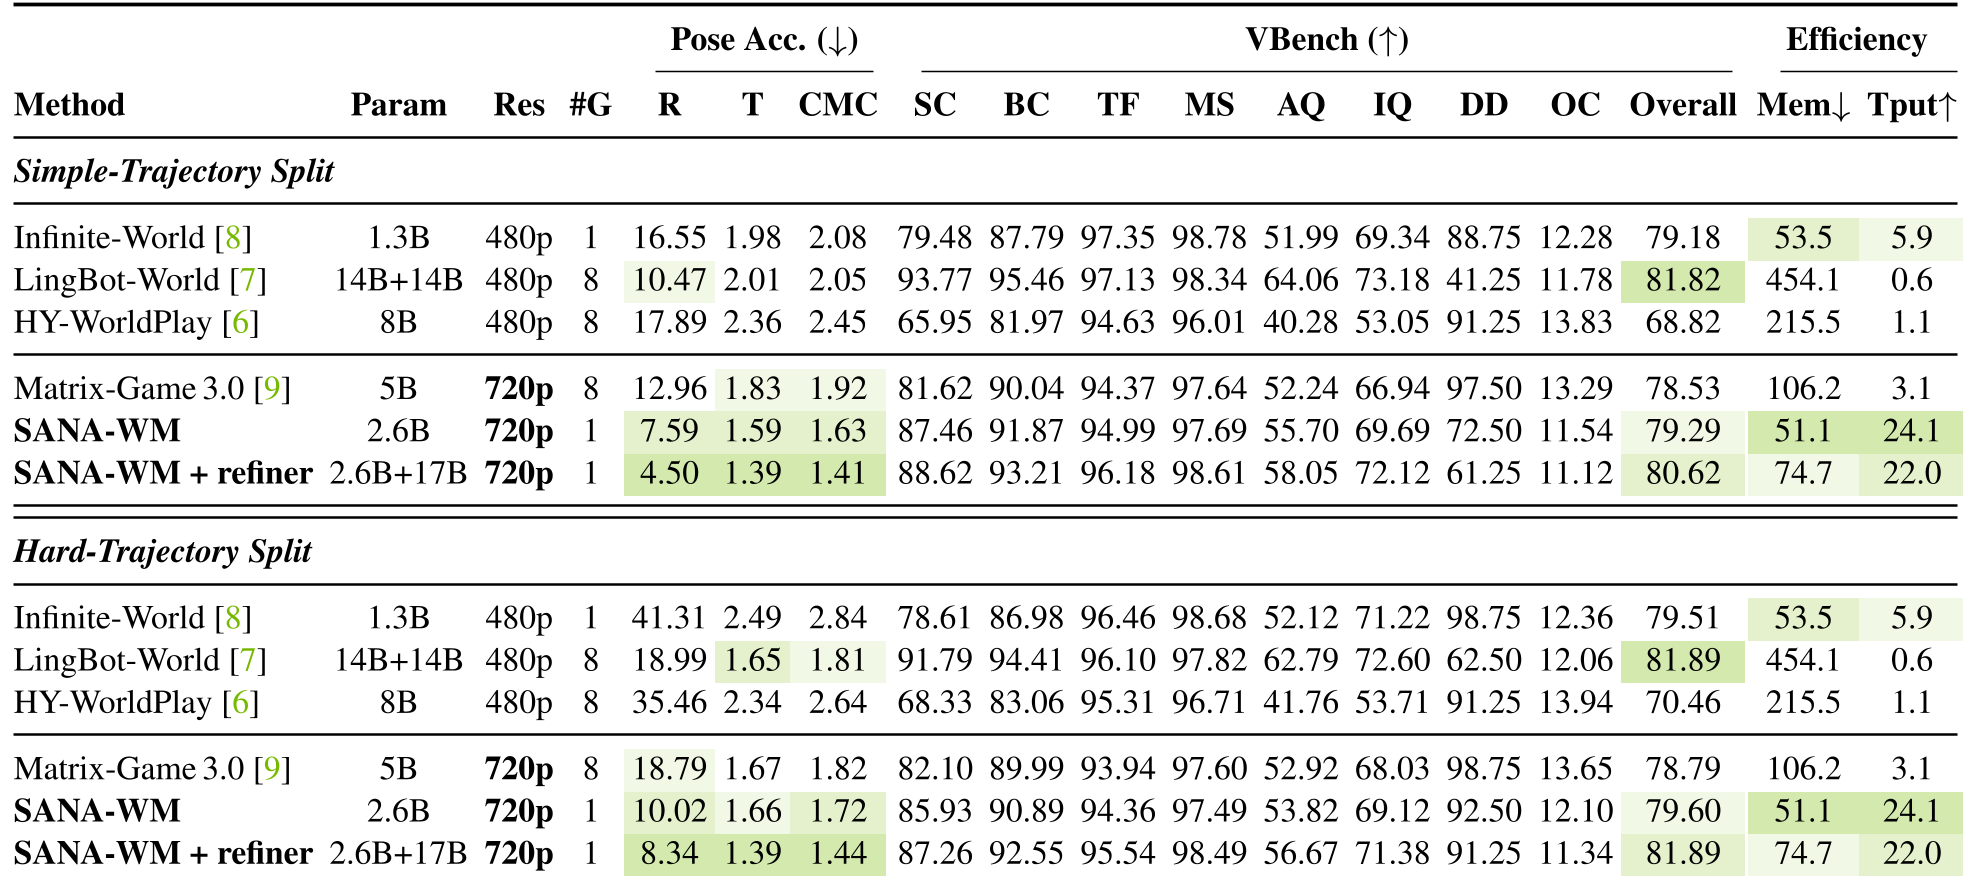 表 1:SANA-WM 与业界各主流模型的量化对比,可以看到其在吞吐量(Tput)上的压倒性优势。
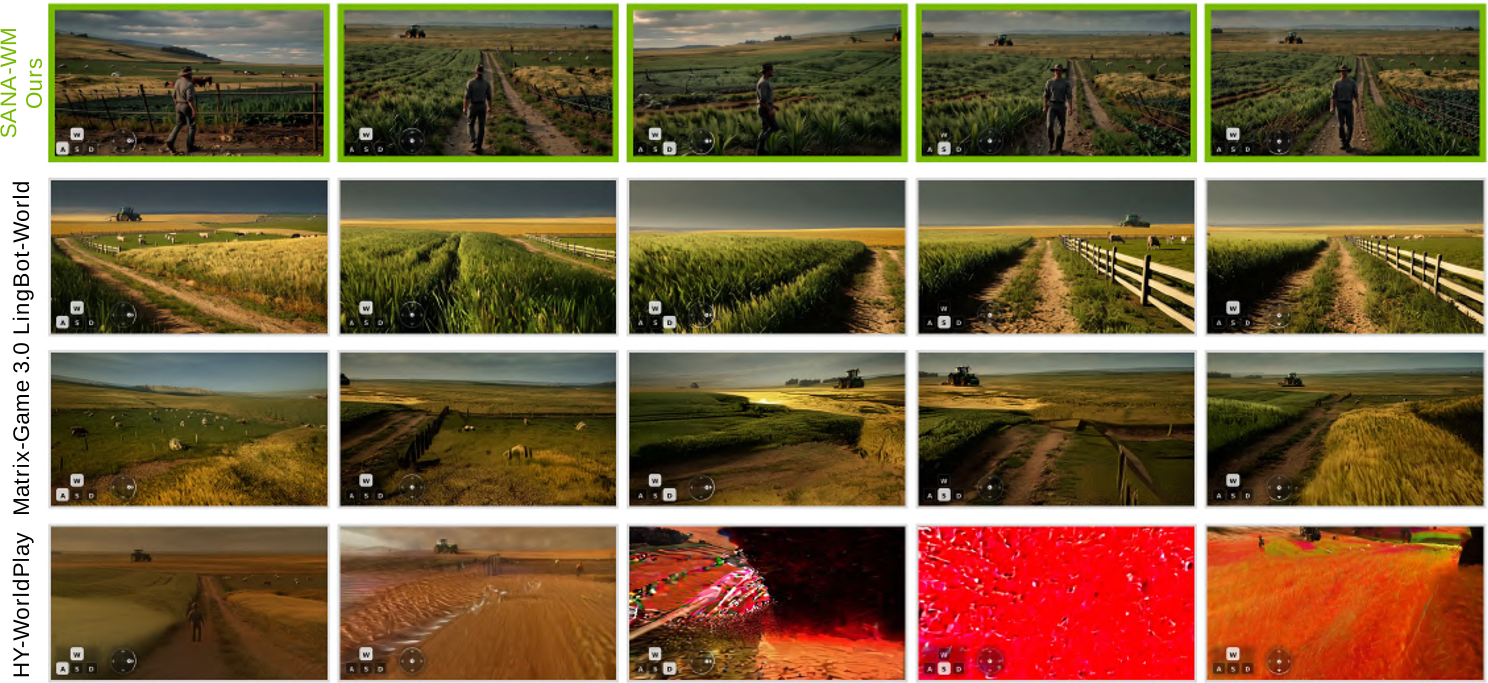 图 2:长航时视角下的生成效果,即便在复杂的视角和光影变换下,场景的一致性依然保持完好。
深度洞察与总结
SANA-WM 的成功核心在于“非对称设计”:它意识到并不是每一层注意力都需要全局感知,通过 GDN 的高效循环和 Softmax 的关键点回溯,模型成功在“计算效率”和“建模能力”之间找到了这一代 DiT 架构的最优解。
局限性与挑战: 尽管 SANA-WM 表现卓越,但在处理动态物体(如走动的人体)与摄像头联动的超复杂场景时,仍存在偶发性的形变。未来通过引入更显式的 3D 表征或点追踪约束,有望进一步提升极致动态下的稳定性。
总结:这篇论文为研究者提供了一套完整的“低成本、高性能”长视频生成方案。对于学术界和中小型实验室来说,SANA-WM 的开源不仅意味着一个强力基座的诞生,更证明了优秀的架构设计可以弥补巨额算力的空缺。