
重排序系统的 Scaling Laws:如何精准预测 1B 模型的排名表现?
Scaling Laws for Reranking in Information Retrieval
本文完成了首个针对检索重排序(Reranking)系统的 Scaling Laws 系统性研究,涵盖了 Pointwise、Pairwise 和 Listwise 三种训练目标。研究表明,Cross-Encoder 重排序器的性能(NDCG@10 等)随模型规模和数据暴露量呈规律的幂律分布,并成功在 MS MARCO 和 TREC DL 任务上通过 150M 参数模型外推预测了 400M 和 1B 模型性能。
TL;DR
在大型语言模型(LLM)领域,Scaling Laws(缩放法则)被奉为圣经,但在搜索系统的核心环节——重排序(Reranking)中,这一规律此前从未被系统性验证。本文通过对 Cross-Encoder 架构的研究发现,NDCG 等排名指标不仅遵循幂律分布,且可以通过 150M 的小模型精准预测 1B 规模模型的表现。这为搜索架构师提供了重要的“路线图”:Pairwise 目标在深层重排序中拥有最佳的扩展潜力。
1. 为什么要研究重排序的缩放法则?
现代搜索系统通常采用“召回-重排”的多阶段架构。重排序作为决胜阶段,直接决定了用户看到的 Top-K 结果。
- 痛点:重排序器处理的是已被初步筛选的候选集,优化的是非连续的排名指标(NDCG, MAP),这与预训练模型优化 Log-loss 或召回模型优化向量空间检索有着本质区别。
- 动机:如果我们能像物理定律一样预测更大模型的表现,就能避免昂贵的实验浪费,并在固定的计算预算(FLOPs)下,寻找模型大小(Model Size)与训练数据量(Data Steps)的最优平衡点。
2. 核心实验框架:三种训练维度的较量
作者对比了重排序中常见的三种损失函数(Loss Functions):
- Pointwise (BCE):将判别任务视为二分类。
- Pairwise (RankNet):学习两个文档之间的相对顺序。
- Listwise (ListNet):从整体文档列表的角度进行优化。
核心公式背后的物理直觉
作者采用如下加法形式的联合缩放法则: 这里 代表性能天花板。通过拟合 17M 到 150M 模型在不同训练节点(Checkpoints)的数据,可以解出代表模型缩放能力的 和代表数据缩放能力的 。
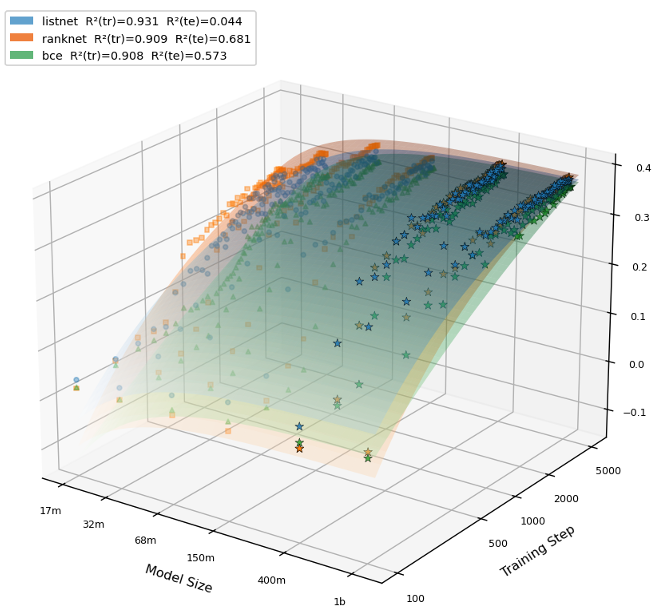 图 1:(a) 展示了 NDCG@10 随模型参数增加的平滑增长趋势,其中实线为拟合曲线,虚线为跨越两个数量级的外推预测。
3. 关键发现:Pairwise 是大规模重排的“王者”
通过对 MS MARCO 数据集的深入分析,研究得出了几个颠覆性或验证性的结论:
- NDCG 比 CE 更稳定:对比对比熵(Contrastive Entropy, CE),NDCG 后期表现异常平滑()。这意味着即便模型的概率评分还在抖动,文档的相对顺序已经稳定下来,这对于工业预测非常有价值。
- 计算预算的最佳分配:
- Pairwise 表现出“数据饥渴”特性。在总计算量一定时,使用更小规模的模型(如 68M)配合更多数据训练,效果往往优于更大规模(400M)但没“吃饱”的模型。
- Pointwise 则相反。它的性能提升主要由模型容量驱动。如果你只有少量高质量标注数据,扩大模型参数是提升 Pointwise 重排性能的唯一路径。
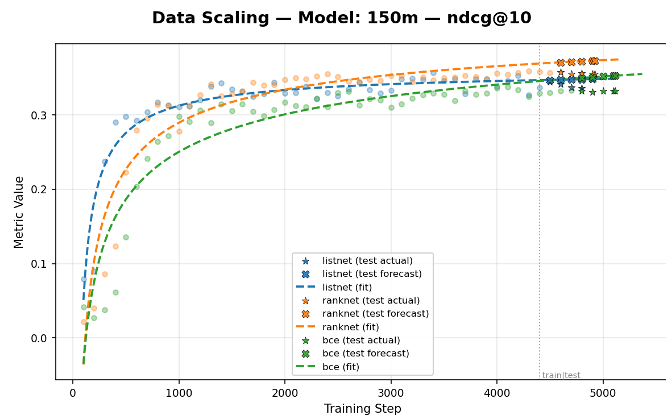 图 2:展现了 NDCG 在模型规模和训练步数双重驱动下的平滑演进。
4. 实验结果:1B 模型的“神预言”
在 MS MARCO-dev 榜单上,基于 150M 以下数据的缩放定律成功预测了 1B 模型在 Pairwise 目标下能达到 0.378 的 NDCG@10,预测偏差极小。
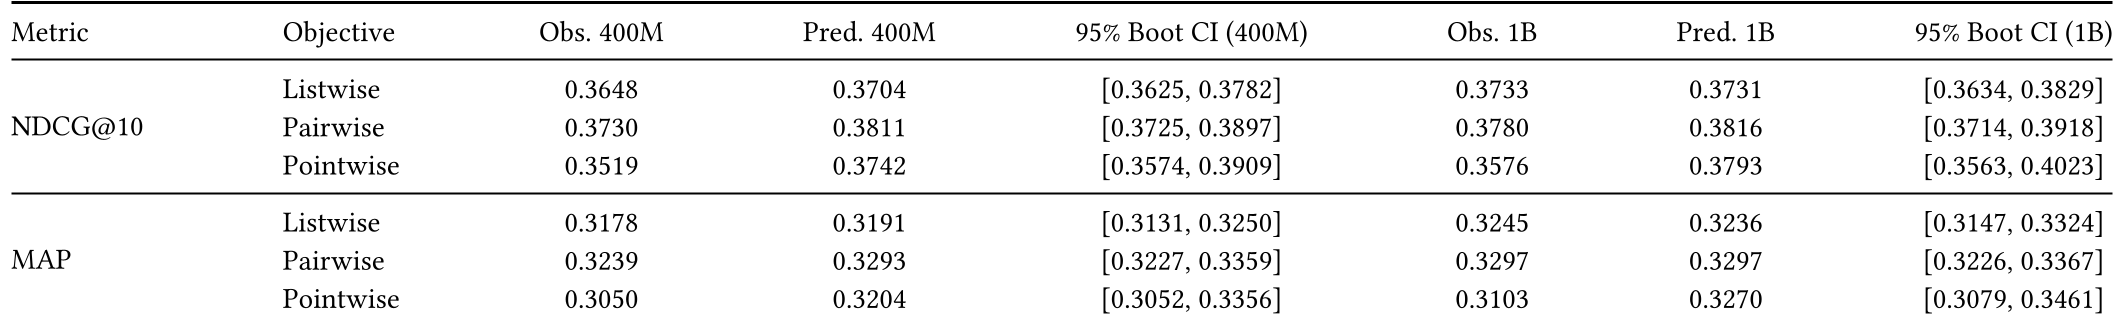 表 1:400M 与 1B 模型的观测值(Obs.)与预测值(Pred.)对比,可以看到大部分落在了 95% 置信区间内。
5. 深度洞察与局限性
为什么这个研究很重要?
它消除了重排序领域的“不确定性”。对于要在 2026 年部署大规模搜索系统的团队,现在只需在 50M 级别做几次消融实验,就能算出来要达到指标需要买多少张显卡、标注多少数据。
局限性与避坑指南
- 架构依赖:本研究基于 Encoder-only(BERT 式)模型。目前大行其道的 Decoder-only(LLM 式)重排序器是否遵循相同比例的系数,仍需进一步验证。
- 指标失效风险:MRR 等指标表现较差(噪声大),在做 Scaling 预测时,优先信任 NDCG 和 MAP。
- 校准冲突:在 Pairwise 模式下,当参数规模超过 150M 后,模型会为了排名准确度而牺牲概率校准(CE 损失开始恶化),如果业务场景需要精确的置信分数,需谨慎对待。
总结
重排序并不是一门“玄学”,它严谨地遵循着计算缩放定律。通过本文的法则,我们可以告别盲目训练,让每一 FLOPs 的算力都产生最高效的排名收益。