
REOPOLD:打破“名师出笨徒”魔咒,让小模型推理效率飞跃 12 倍
Scaling Reasoning Efficiently via Relaxed On-Policy Distillation
本文提出了 REOPOLD,一种针对紧凑型模型(SLMs)的“放松”策略在线蒸馏框架。该方法将在线蒸馏重新定义为基于 Token 奖励的策略优化任务,利用混合激励裁剪和动态采样,使 7B 规模的学生模型在推理速度提升 3.32 倍的同时,在数学和视觉推理任务中达到或超越 32B 教师模型的性能。
TL;DR
在 AI 领域,“名师出高徒”并不总是成立。当我们将像 DeepSeek-R1 或 O1 这样拥有强大推理能力的教师模型蒸馏给小模型(SLMs)时,学生往往因为“模仿过度”而产生严重的训练不稳定。本文提出的 REOPOLD (Relaxed On-Policy Distillation) 框架,通过“放松”模仿约束、智能裁剪有害奖励,让 7B 小模型在数学、视觉推理上通过极少的样本就追平了 32B 的教师,推理速度提升 3 倍以上。
背景定位:从“盲目模仿”到“策略优化”
当前大模型的逻辑推理能力主要源于强化学习(RL)和推理链(CoT)的 Test-time Scaling。然而,小模型容量有限,直接跑 RL 极易崩溃。为了解决这个问题,学术界转向了在线蒸馏(On-Policy Distillation)。
作者精准地发现:在线蒸馏本质上就是一种特殊的 RL。在蒸馏过程中,教师与学生的对数似然比(Log-likelihood Ratio)其实就是一种 Token 级别的奖励信号。
痛点深挖:为什么传统的蒸馏会失败?
传统的 Reverse KL (RKL) 蒸馏存在三大致命伤:
- 重尾负奖励:如果学生生成了一个教师完全不认可的 Token,奖励会趋向负无穷,导致梯度爆炸,模型瞬间“学废了”。
- 信号稀释:大部分 Token 是确定性的(低熵),老师和学生看法一致,奖励接近于零。这些无意义的计算占用了大量显存和算力。
- 熵塌陷:模型为了迎合老师,很快就只会复读一两种答案,失去了探索复杂推理路径的能力。
核心内容:REOPOLD 的“放松”艺术
REOPOLD 并没有强制学生每一步都死记硬背老师的分布,而是引入了以下核心机制:
1. 理论根基:停止梯度 (Stop-gradient)
作者证明了在期望上,将奖励项视为固定值进行处理(停止梯度),与完整的 RKL 梯度是一致的,但能像控制变量一样极大降低方差。
2. 奖励裁剪 (Reward Clipping)
受混合分布理论启发,作者推导出了一个数学上更稳健的罚分上限。
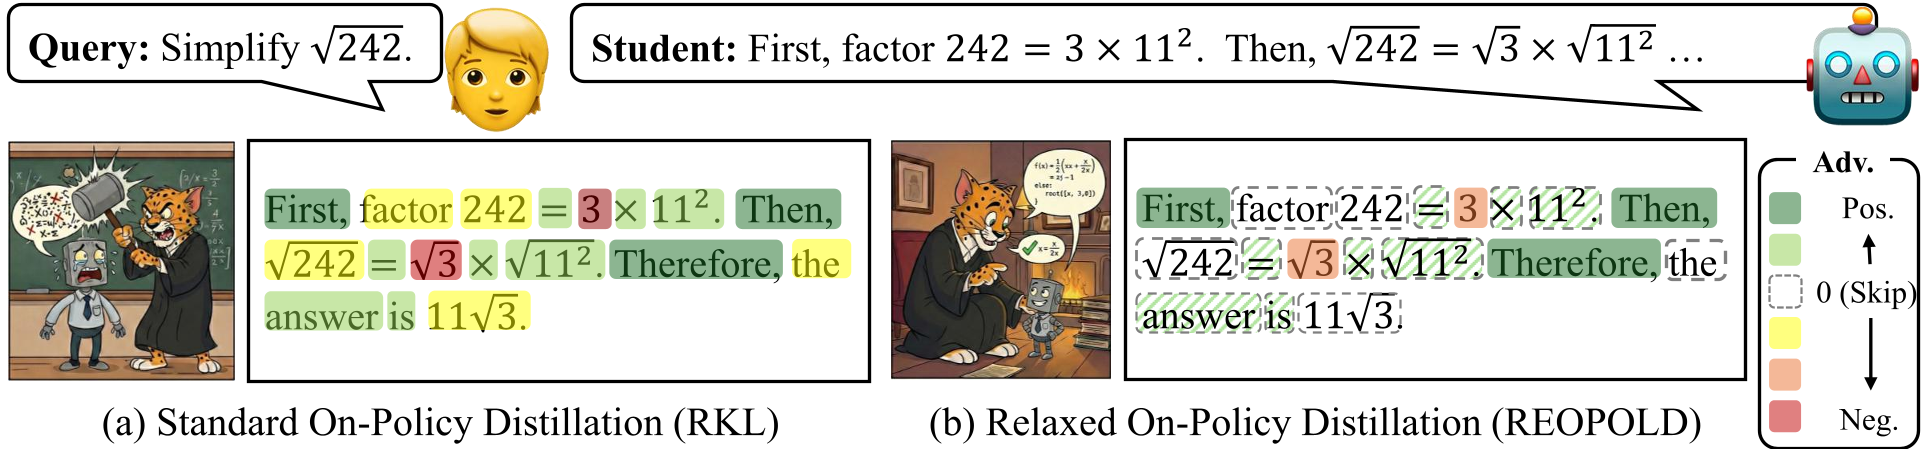 图注:REOPOLD 与标准蒸馏的对比。左侧标准方法由于强制模仿导致不稳定,右侧 REOPOLD 通过选择性吸收信号,保护了学生模型免于偏离分布。
3. 熵引导的动态采样 (Entropy-Guided Sampling)
REOPOLD 只关注那些“关键分歧点”。如果一个 Token 的熵值特别高,说明学生在这里很迷茫,此时引入教师的指导信号效率最高;而对于确定的 Token 则直接过滤,缓解了信号稀释。
4. 双阶段:探索 -> 精炼
- 探索阶段:屏蔽过大的负奖励,保护模型的熵(多样性),类似于 SFT 的温和学习。
- 精炼阶段:引入负反馈,利用熵遮罩精确锁定错误点,实施高强度修正。
实验战绩:以小博大的胜利
数学推理的降维打击
在 1.5B 模型的数学测试中,REOPOLD 仅用 300 步就超越了需要 2000 步的其他 RL 方法。
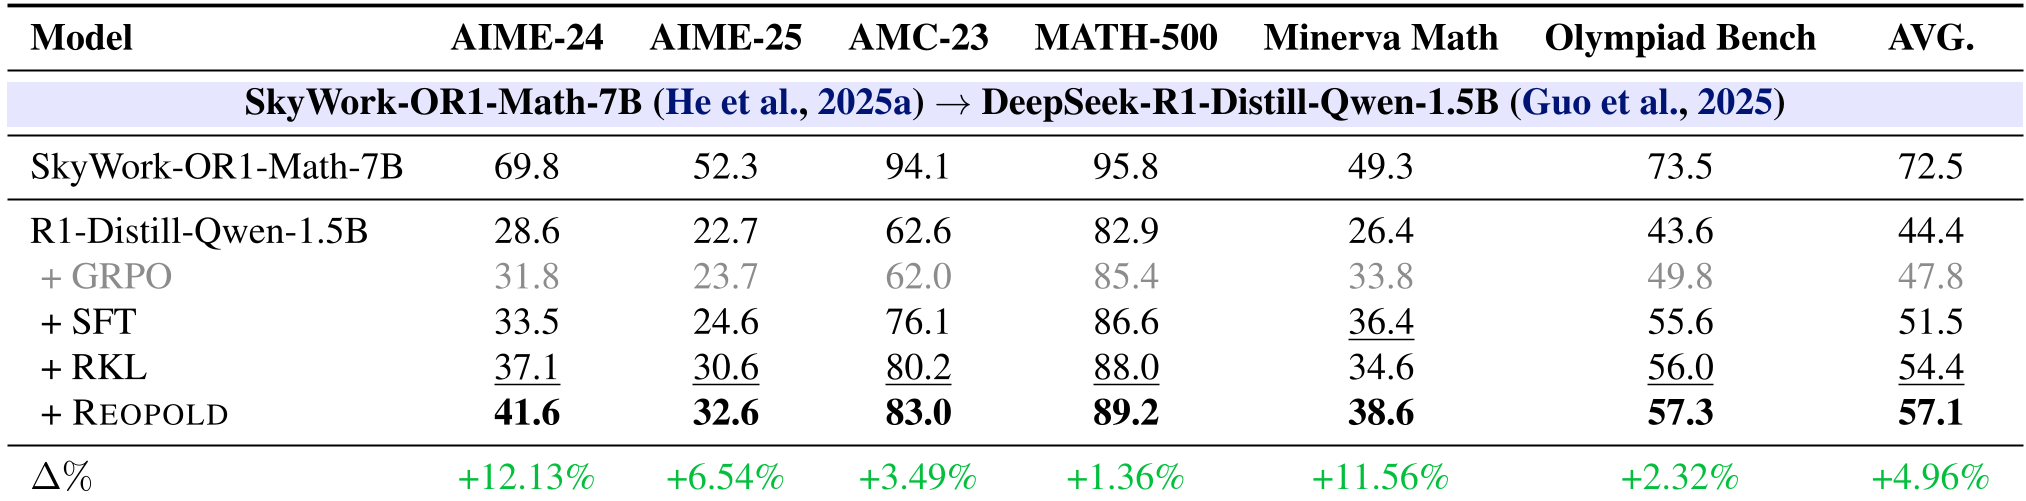 表注:在 AIME-24 等竞赛级数学题目上,REOPOLD 相比 SFT 和 RKL 均有显著提升(Δ% 达到 4.96%~13.48%)。
视觉推理与自省能力
在视觉数学任务(MathVerse)中,REOPOLD 培养出的学生模型展现出了惊人的“自纠错”能力。
 图注:对比实验显示,Vanilla RKL 陷入了逻辑死循环,而 REOPOLD 模型在中间步骤发现错误后明确触发了“However, we need to re-evaluate...”的自省过程,最终修正了答案。
深度洞察
REOPOLD 的成功在于其对“学习成本”的认知。它意识到并不是每一个 Token 的监督都有价值。通过在时域上分阶段(探索 vs 精炼)和在空间上分 Token(高熵采样),它实现了一种极其高效的推理能力迁移。
局限性:虽然通过熵采样提升了效率,但对于极其冷僻的任务,可能依然需要教师模型具备极高的领域覆盖率。
总结
REOPOLD 为算力受限的场景提供了一套标准模版:不要让小模型去吃大模型走过的所有弯路,而是通过精心设计的裁剪和采样,只在关键决策点上提供“恰到好处”的指导。