
SciAgentGym:当 LLM 走进实验室,如何从“做题家”变为“科学家”?
SciAgentGym: Benchmarking Multi-Step Scientific Tool-use in LLM Agents
本文推出了 SciAgentGym,一个包含 1,780 个领域特定工具、跨 4 个自然科学领域的交互式基准测试环境,旨在评估 LLM Agent 在多步骤科学工作流中的表现。研究发现,即使是 GPT-5,在面对长程(Long-horizon)科学任务时成功率也会从 60.6% 暴跌至 30.9%。
TL;DR
复旦大学 NLP 团队近日发布了 SciAgentGym,这是一个专为 LLM Agent 设计的科学实验室环境。它不考模型“背书”,而是考模型“实操”。通过集成 1,780 个涉及物理、化学、生物、材料的专业工具,研究者发现:目前最顶尖的 LLM(如 GPT-5)在处理复杂科学步骤时依然面临“长程性能崩溃”,成功率随步骤增加折半。为此,团队提出的 SciForge 策略通过模拟“失败中学习”的轨迹,让 8B 小模型逆袭 235B 大模型。
痛点深挖:静态问答的局限与长程推理的坍塌
传统的 LLM 评估(如 GPQA)更像是闭卷考试,考察模型存储了多少科学知识。但在真正的科研中,科学家需要操作分子模拟、查询数据库、编写数据分析代码。
此前工作的局限性在于:
- 缺乏交互反馈:模型给出错误指令后无法根据报错修正。
- 工具链逻辑缺失:模型知道有哪些工具,却不知道工具之间的 A 依赖 B 的拓扑关系。
- 长程迷失:随着推理步数增加,模型极易陷入死循环(Loop)或因一次误操作导致全局溃败。
核心架构:SciAgentGym 的三位一体
为了模拟真实的科研链路,SciAgentGym 构建了三个核心组件:
- Toolkit (1780+ Tools):从 RDKit (化学) 到 PyMatGen (材料),提供类型安全的专业接口。
- SciAgentBench:分层评测集,从 L1(简单动作)到 L3(复杂工作流,8步以上)。
- 交互沙盒:提供文件系统、数据库和 Python 解释器,模型可以像人类一样在终端操作。
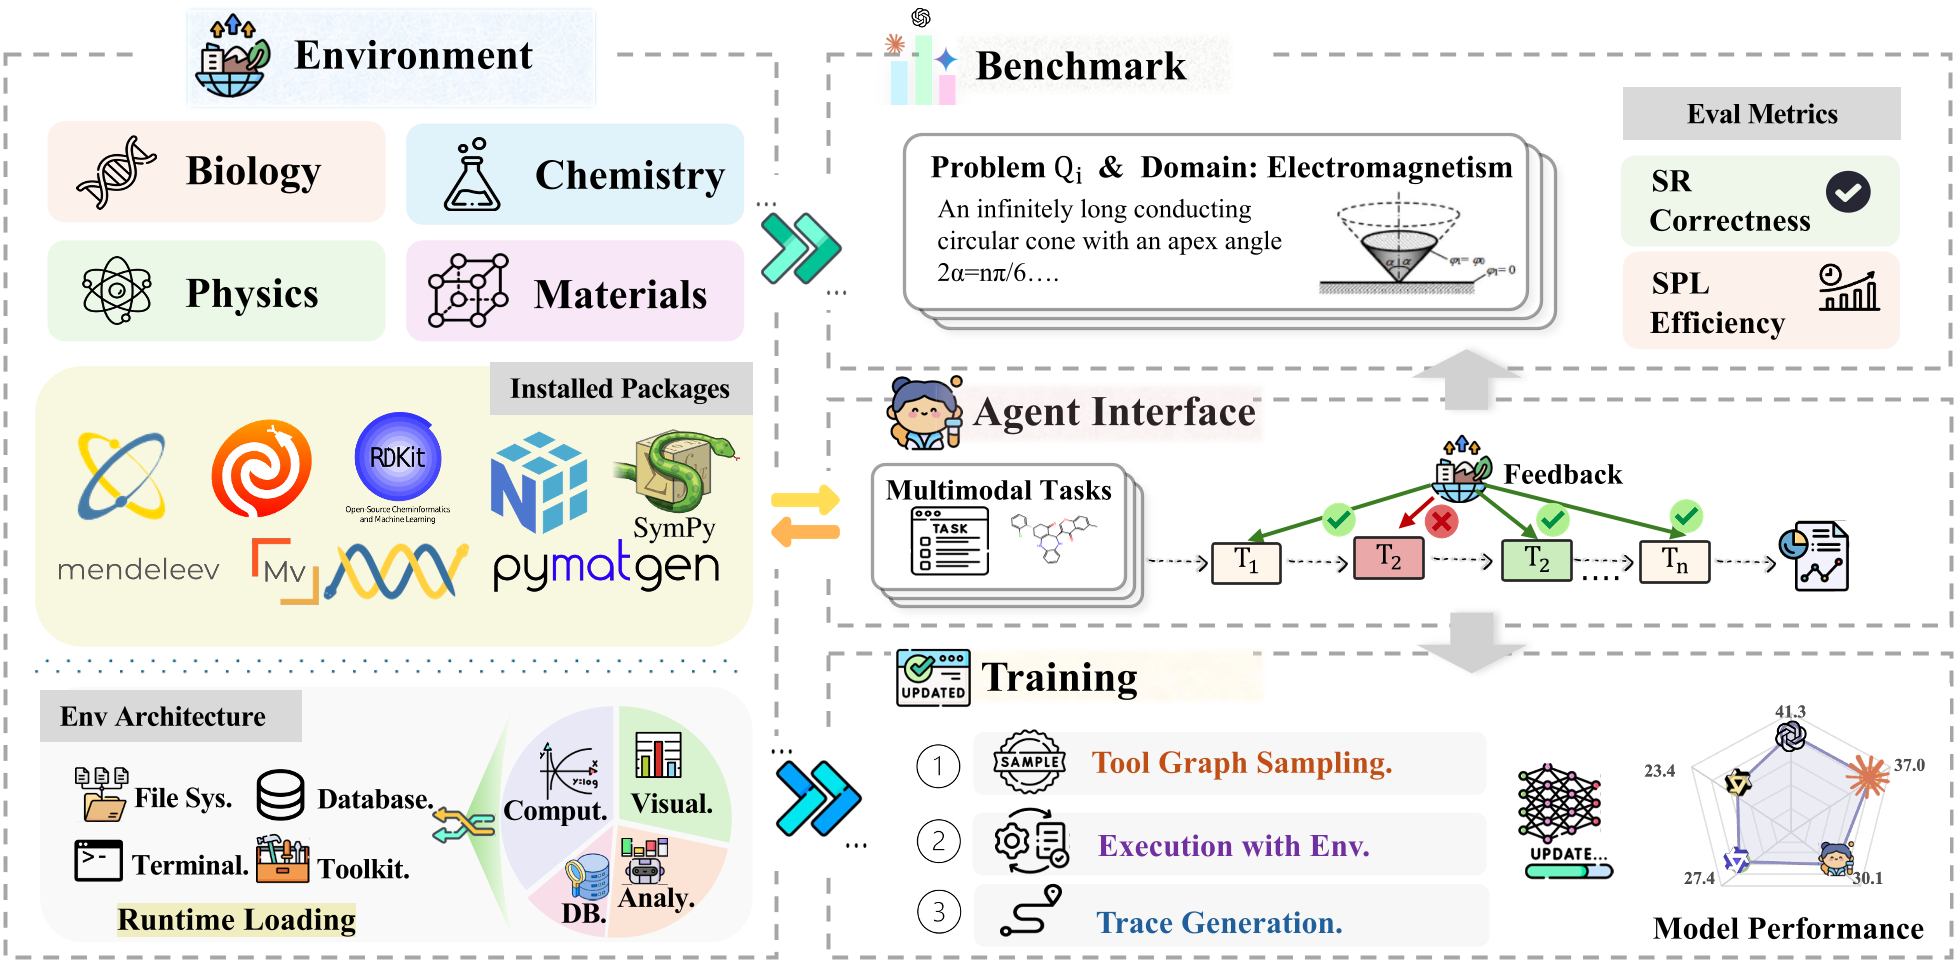 图 1:SciAgentGym 环境概览,展示了从环境注入到模型训推的完整闭环。
方法论:SciForge 如何让模型“学会失败”?
本文最深刻的见解在于:干净的成功路径(Golden Trace)不足以教会 Agent 鲁棒性。
SciForge 的核心流程包括:
- 依赖图建模:基于工具的输入输出类型构建有向图。
- 逻辑感知采样:模拟科学发现的典型阶段(数据库查询 -> 计算 -> 分析 -> 可视化)。
- 错误恢复合成 (Error-Recovery Data):故意让模型接触失败的调用指令及其修正后的指令。这种“试错轨迹”教导模型在收到环境报错信息后如何进行“参数微调(Tuning)”或“策略切换(Switching)”。
实验结果:小模型的“工具智慧”
实验显示了一个扎心的事实:全行业模型在面对 L3 级别的硬核任务时普遍表现不佳(平均准确率仅 14.7%)。
然而,经过 SciForge 增强的 SciAgent-8B 表现惊人:
- 跨模态与长程能力:在物理、化学等学科显著超越了基座模型。
- 效率提升:相较于基座模型频繁的重复调用,微调后的模型单次指令的信息增益更高,调用更精准。
- 以小博大:8B 模型在科学任务上的表现超越了 235B 的大参数模型,证明了“领域特定轨迹”的训练质量远比单纯堆砌参数量重要。
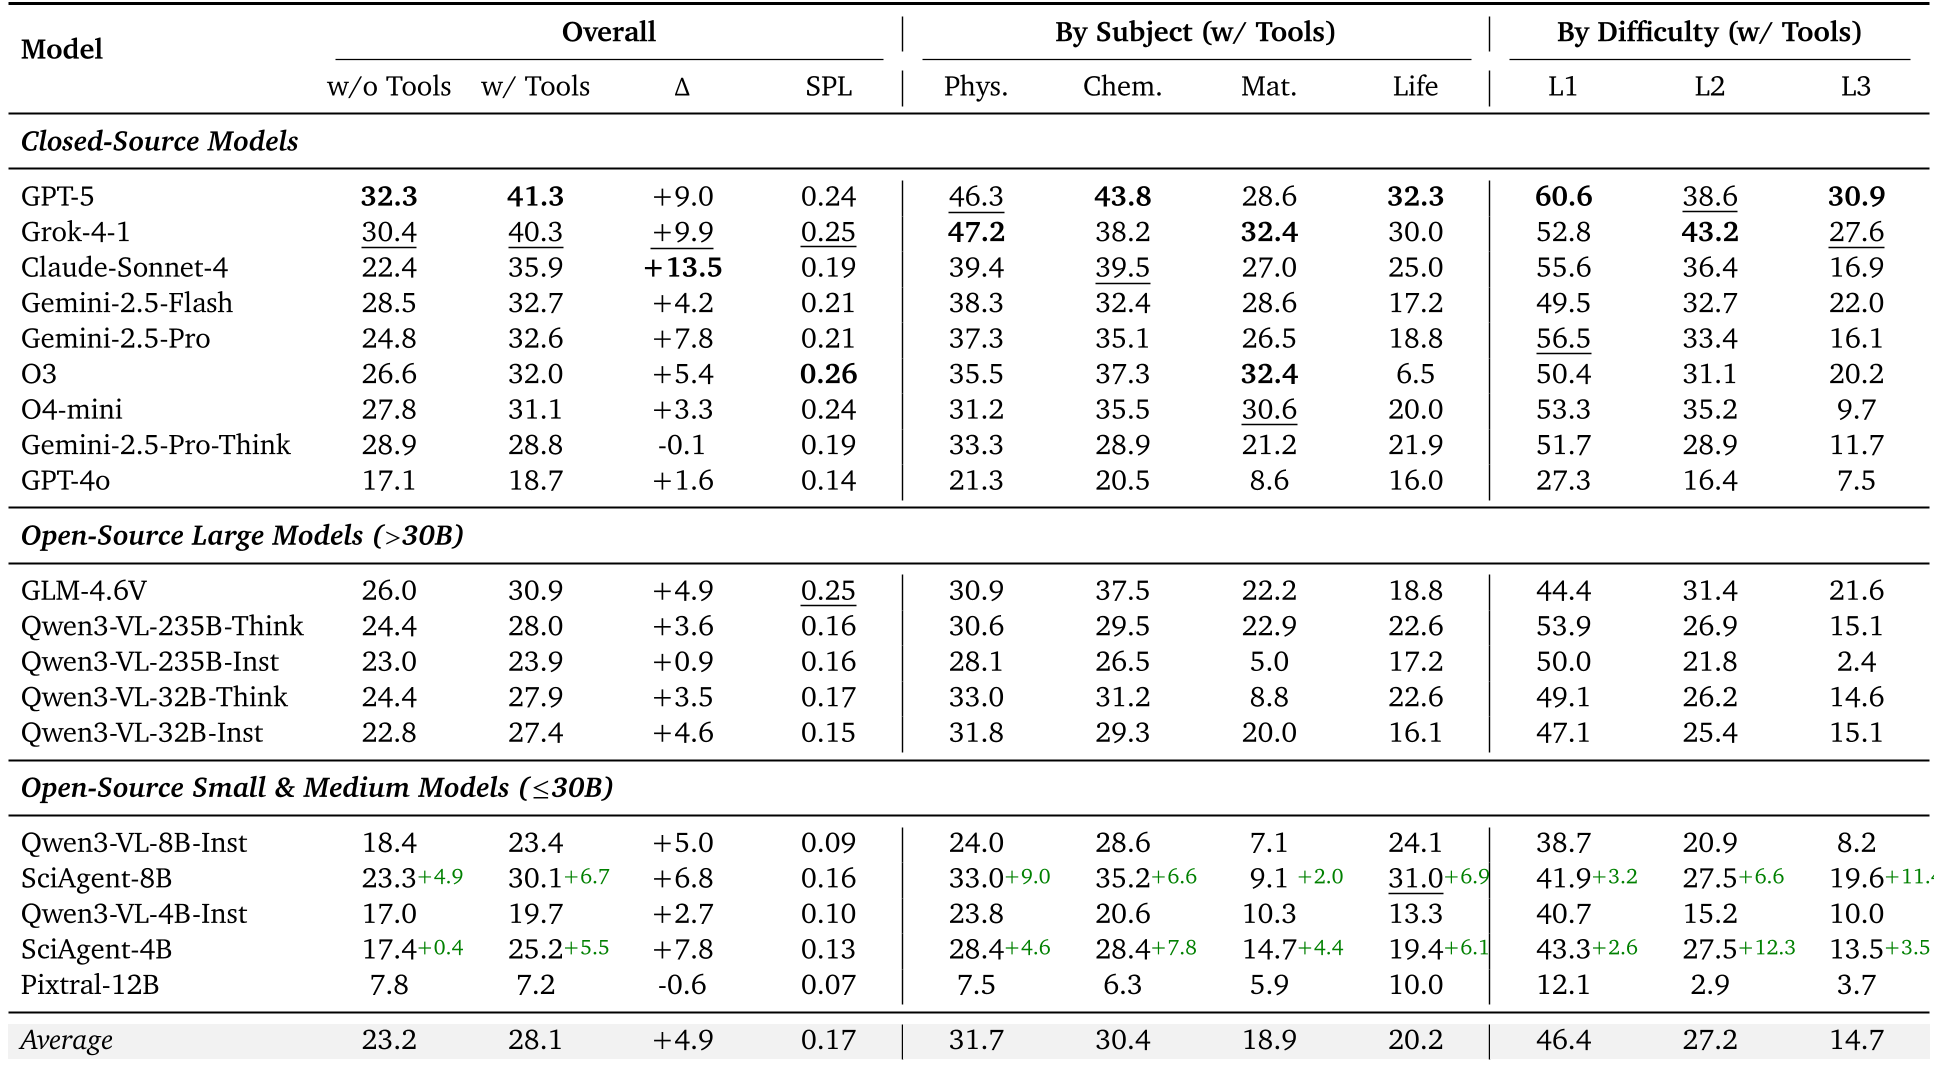 表 1:SciAgent 系列模型与国内外前沿模型的 SOTA 对比。
深度洞察:为什么有的模型会卡死在循环里?
研究者通过故障分析(Figure 4)发现,弱模型之所以失败,是因为其**报错处理管道(Error-handling Pipeline)**是断裂的:
- Adaptation(适应率):只有 32.9% 的情况会理会报错。
- Tuning(微调率):仅有 6.6% 的情况能修正错误的参数。
- 绝大多数弱模型在失败后会选择“原地踏步”,重复完全相同的错误动作。
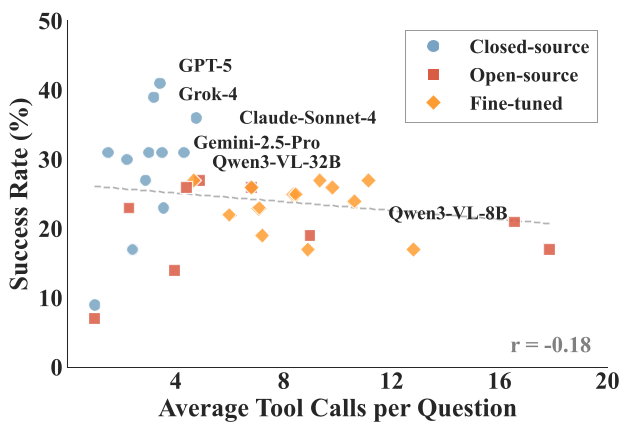 图 2:模型失效模式分析,展示了强弱模型在错误恢复能力上的分水岭。
总结与展望
SciAgentGym 的出现将科学 AI 的竞争从“知识储备”拉到了“行动能力”的维度。它告诉我们,未来的自主科学 Agent 必须具备:
- 对专业工具拓扑结构的深刻理解。
- 从环境报错中快速自愈的韧性。
- 能够跨学科迁移的“科学实验直觉”。
局限性:虽然 SciForge 极大地提升了准确率,但在某些极其复杂的动态场景下,Agent 的 SPL(路径效率)仍有提升空间。未来,强化学习(RL)可能会在 SciAgentGym 这种可交互环境中发挥更大作用。