
迈向深度学习的“物理学”:学习力学(Learning Mechanics)的崛起
There Will Be a Scientific Theory of Deep Learning
本文提出了“学习力学”(Learning Mechanics)这一新学科框架,旨在通过物理学的视角建立深度学习的科学理论。文章汇总了五个关键研究方向,旨在通过第一性原理预测神经网络的训练动力学、表示演化及泛化性能。
TL;DR
长期以来,深度学习被戏称为“黑盒炼丹”。本文提出了一项宏大的科学议程,主张深度学习正进入一个类似于 19 世纪物理学的时期。通过将训练过程定义为学习力学(Learning Mechanics),我们可以利用第一性原理预测模型行为,而非仅仅依赖经验性的试错。
核心速览:告别炼丹术
尽管大语言模型(LLM)已改变世界,但其背后的理论支撑依然贫瘠。本文作者(来自 UC Berkeley 等机构)指出,深度学习理论已从单纯的“数学证明”转变为“实证科学”。
- 定位:这是一篇里程碑式的愿景论文(Vision Paper),它在学术坐标系中为零散的理论分支(如 NTK, Scaling Laws, P)划定了统一的版图。
- 直觉:就像行星运动遵循引力场定律,参数更新也遵循损失函数的“梯度场”。
痛点深挖:为何我们需要力学而非统计?
传统的统计学习理论(如 VC 维)在解释现代神经网络时彻底失效。
- 过度参数化:传统理论认为参数越多越容易过拟合,但深度学习却能实现“双下降”并增强泛化。
- 黑盒动力学:我们知道初始状态和终点,却不理解训练路径(Trajectory)如何筛选出特定特征。
方法论详解:构建理论的五大支柱
1. 理想化的可解模型
作者强调了**深度线性网络(Deep Linear Networks)**的重要性。虽然它们没有非线性激活,但在优化动力学上表现出了惊人的相似性(如鞍点主导的景观、阶段性学习特性)。
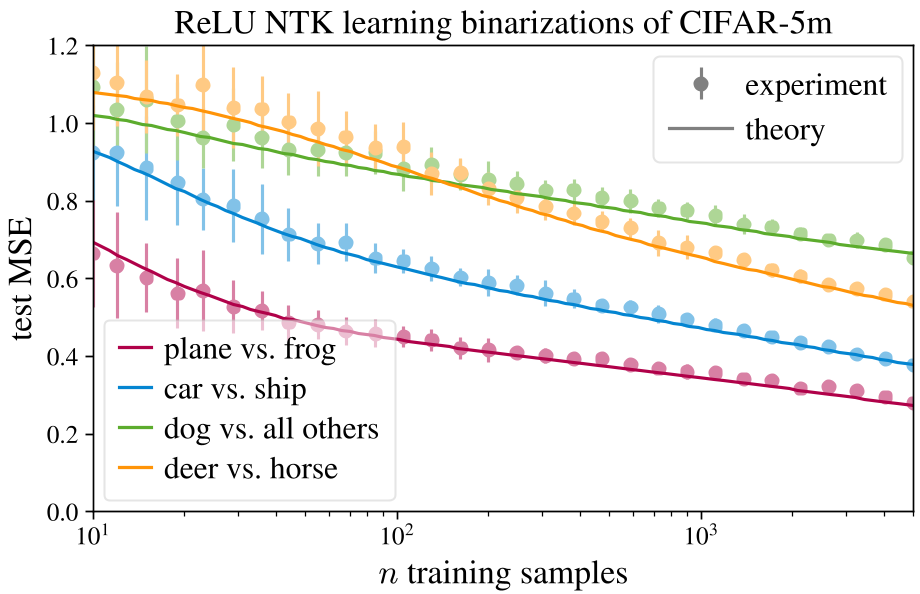 图 (a) 展示了线性化数据与参数下的学习曲线,揭示了模型如何从简单模式开始逐级学习。
2. 无穷限的简化(Limits)
物理学研究气体使用“热力学极限”(粒子数 ),深度学习也有无限宽度/深度极限。
- Lazy Learning:模型在训练中几乎不改变特征(NTK 机制)。
- Rich Learning:通过调整初始化尺度(P),模型可以进行深层特征演化(Feature Learning)。这是目前超越“懒惰训练”的关键。
3. 超参数的解耦
通过 Maximal Update Parameterization (P),研究者发现可以将模型规模(宽度)与最优学习率解耦。
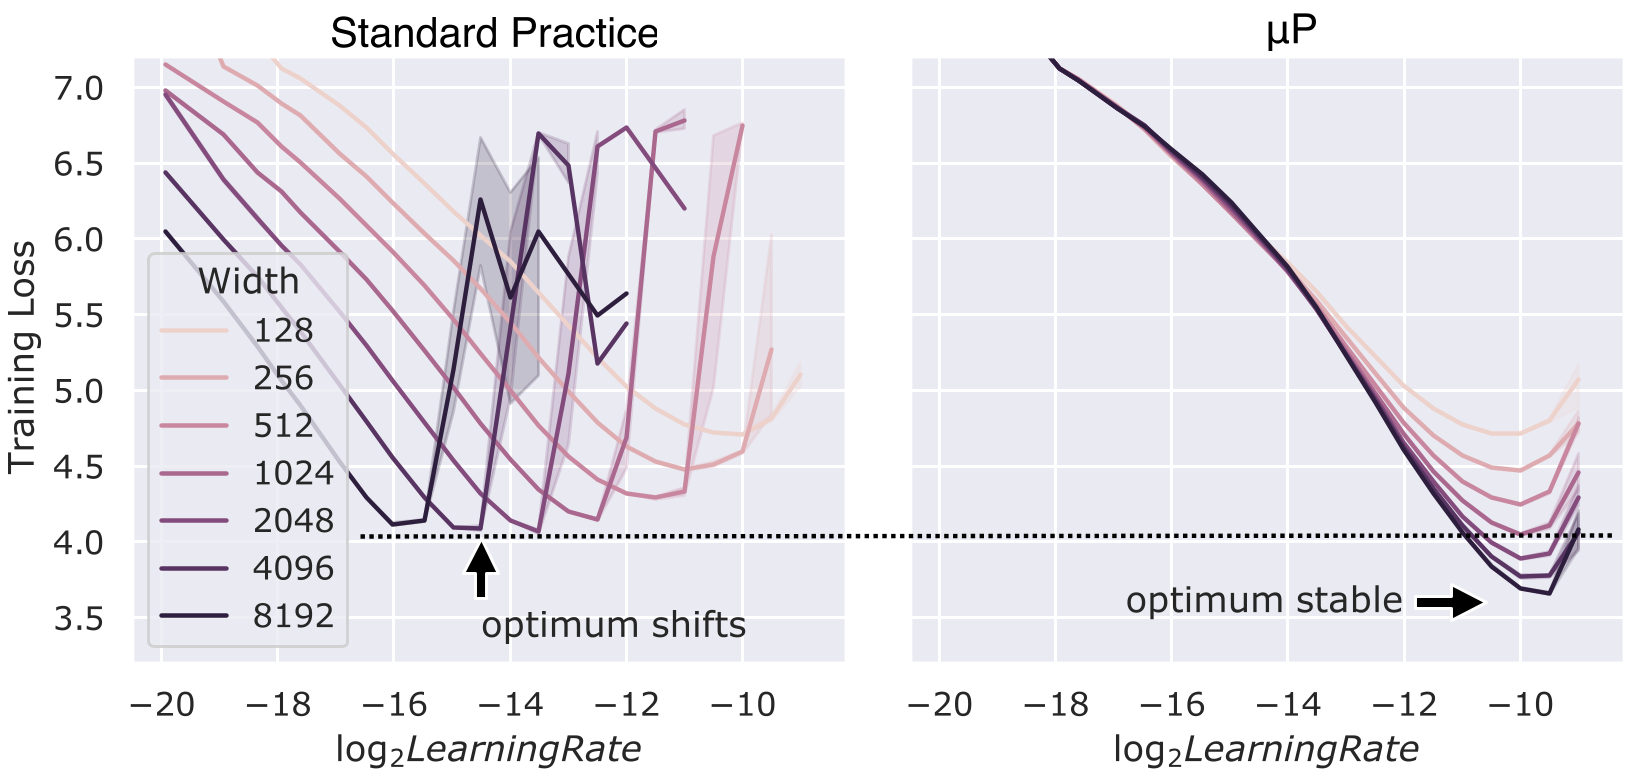 如图所示,在 P 架构下(右图),不同宽度的 Transformer 最优学习率几乎重合,这极大地降低了大模型的调优成本。
实验与实证:规律的普遍性
文章引用了 Edge of Stability (EoS) 这一重要发现。在全量梯度下降中,损失函数的 Sharpness 会上升并稳定在 的临界点。这种“自我稳定”的行为表明,训练并非随机,而是受深刻的数学准则驱动。
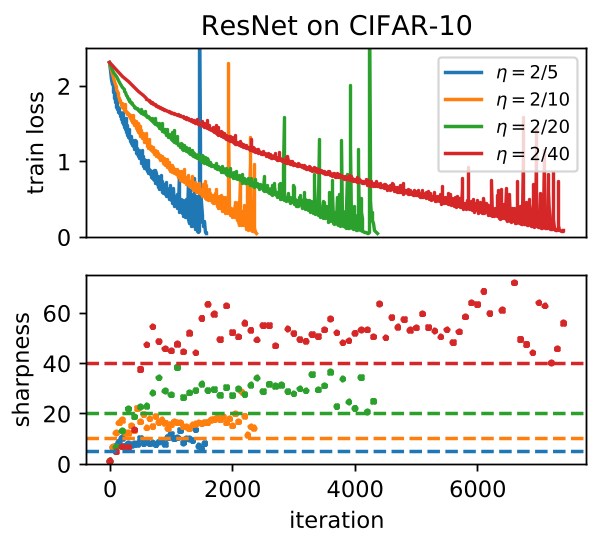 该实验展示了不同架构在接近 虚线时的锁定行为,验证了“学习力学”的预测力。
深度洞察:力学与解释性的共生
作者提出了一个极具启发性的类比:
- 机械解释性(Mechanistic Interpretability) 是深度学习的“生物学”,研究神经元和环路的具体构造。
- 学习力学(Learning Mechanics) 是深度学习的“物理学”,研究驱动这些构造形成的底层力场。 没有“力学”支撑的“生物学”只能停留在观察阶段,无法理解进化(训练)的必然性。
总结与局限
Takeaway:深度学习的科学化进程正在加速。我们不仅要看模型“能做什么”,更要通过 Scaling Laws 和动力学对称性理解模型“被迫做了什么”。
局限性:目前的理论仍难以完全描述“自然数据”的分布特征(Open Direction 2),且对于非梯度优化器的解释尚不充分。但正如牛顿力学先于量子力学,我们正处于建立“古典深度学习力学”的关键节点。