
ScientistTwo:把自主科研代理从刷指标推向可复核的论文生产线
ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI
本文提出 ScientistTwo,一个面向顶级会议论文问题的多智能体自主科研框架,通过子集先筛、消融归因和模拟评审补实验闭环生成可复现代码与论文。在 107 个 ICLR、ICML 和 NeurIPS 问题上,它完成 80.4%,平均相对增益 25.2%,并在自动评审中达到 ScholarPeer 91.9% 接收率和 Stanford Agentic Reviewer 72.1% 接收率。
核心速览
ScientistTwo 试图回答一个很硬的问题:给定一个真实顶级会议论文问题,AI 能否不只是复现代码或调超参数,而是自主发现一个有理由、有消融、有 rebuttal、有可执行仓库的新方法,并把整套研究写成接近可发表的论文。论文报告其在 107 个 ICLR、ICML 和 NeurIPS 问题上成功推进了 80.4%,相对人类 state-of-the-art 基线平均获得 25.2% 的相对增益;在自动评审体系中,Table 2 显示其 ScholarPeer 平均分为 7.5,接收率为 91.9%,在作为 held-out evaluator 的 Stanford Agentic Reviewer 下也达到 72.1% 接收率。这些数字让它在自主科研代理谱系中显得突出,但其结论仍高度依赖自动化评审器和代码可复现审计,不能简单等同于真实同行评审已经全面接受。
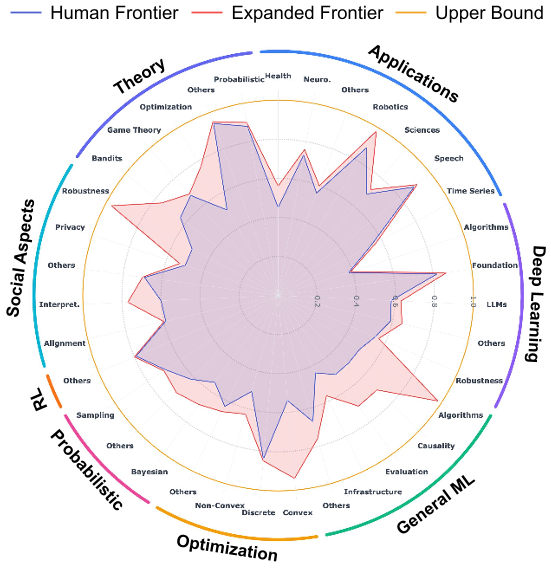
从背景坐标看,ScientistTwo 不是一个新的模型架构,也不是一个新的数据集 benchmark,而是一个面向科研生命周期的系统工程:它把 Idea Generator、Subset Coder、Full-Set Critic、Ablation Planner、Peer-Review Agent、Rebuttal Planner 和 Meta-Review Agent 串联成一条可迭代流水线。论文在 Introduction 中明确指出,其评测对象是顶级会议已发表的人类研究,要求系统在这些真实问题上越过既有 state-of-the-art,同时证明过程可测、可复现、可解释。因此,这篇工作的真实目标不是“让 LLM 写论文”,而是让一个 agent 完成发现、验证、归因、回应质疑的闭环。
问题与动机:单标量优化为什么不够
论文批判现有 autonomous research agents 的核心缺陷非常具体:它们通常只优化 isolated benchmark 上的一个 scalar metric。这个看似只是“指标太单一”的说法,背后有两层失效机制。第一,单一指标会混淆真正的方法贡献与容量扩大、学习率调优或数据泄漏等附带效应;没有系统消融,就不知道增益来自哪一项。第二,科研不是静态搜索,而是在评审质疑下不断补证据;如果系统只能生成文本,不能针对 review weakness 设计补充实验,那么产出的“论文”仍然只是草稿。Related Work 中对比 AI Scientist、AI Scientist-v2、ScholarPeer、PaperOrchestra、ScientistOne 等路线时,作者特别指出 ScientistOne 虽强调可验证性,却仍缺少 active analytical expansion。也就是说,本文的动机不是提高分数,而是补齐科研过程里的因果解释和反驳实验。
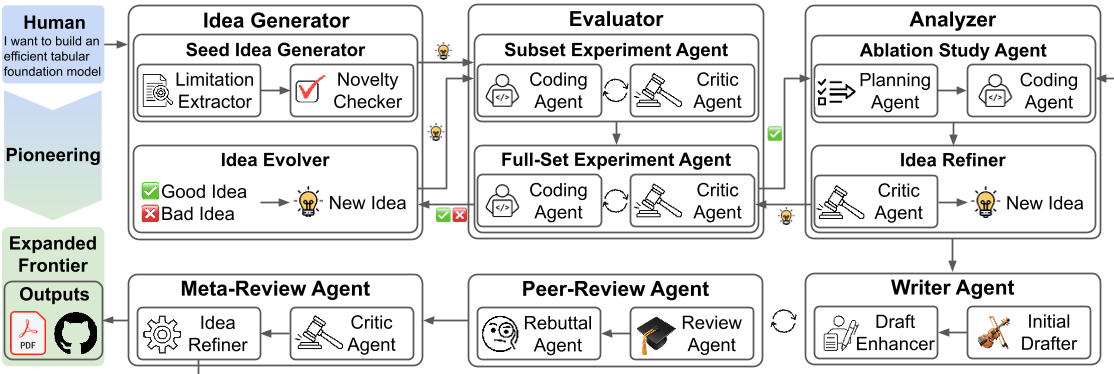
这一动机在 Table 1 的 stage、candidate、critic、refine 结构中被制度化。Finding Limitations 阶段不是直接生成想法,而是先让人类基线的不足被验证为“能引导改进”;Seed Idea Generation 阶段要求想法具备 novelty;Idea Experiment on Subset 阶段用子集先筛选;Full-Set 阶段才要求与原始 SOTA 对比;Ablation Study 阶段追问组件分解是否 clean;Peer-Review 与 Meta-Review 阶段则把评审分数与 venue bar 变成循环终止条件。Listing 1 用 Python-style pseudocode 把每个阶段都抽象为 critic 决定 accept、refine 或 discard 的过程。这个设计本身说明作者关心的不是“多跑几轮”,而是“每一轮是否有证据推动状态前进”。
核心章节:一条闭环发现流水线如何工作
出发点:从问题到论文与代码的形式化接口
论文首先给出一个高层定义:
其中 是输入科学问题,通常对应一篇人类 state-of-the-art 论文及其可复现基线; 是系统生成的新论文; 是新论文对应的代码仓库; 是由 个专门 agent 组成的系统集合。这个式子在全文中承担“接口定义”的角色:它把自主科研的目标从模糊的“生成 idea”收紧为三个同时成立的要求。新论文必须识别并解决 中的关键方法或实验瓶颈,新代码必须正确实现所提想法并保持可复现性,最终结果必须带来可测量的性能增益。若 不能复现报告结果,或 无法把增益归因到组件变化,这个接口定义就不满足。因此,ScientistTwo 的核心评价框架从一开始就不是单纯 accuracy,而是 paper、code 和 evidence 的三元闭环。
这一形式化也揭示了系统的工作对象:它不是从零开始做科学发现,而是在人类已有问题上寻找下一步扩展。论文第 1 节强调,这种 setup 更贴近真实科研,因为现代 AI 研究大多是在已有方法上识别限制并提出改进。ScientistTwo 的输入包括目标问题、基线论文与可执行代码;输出是超过基线的新方法、新结果、新论文和审计过的仓库。它试图用多 agent 协作替代人类团队,但并未声称替代理论突破中的原创范式,这一点在 Limitations 中也被承认。
核心机制:子集筛选、消融归因与评审即实验
ScientistTwo 的工程推进分三层:先生成有 novelty 的 seed ideas,再实施与筛选,最后通过 ablation 和 review-driven refinement 稳定住证据链。想法评估阶段不是直接在全量 benchmark 上跑所有候选,而是先由 Baseline Coding Agent 在子集上复现基线结果,再由 Subset Coding Agent 实现候选想法。Subset Critic Agent 对想法、代码和日志做分类判断:Bad 表示明显劣于基线,Good 表示可 scale-up,Engineer 表示有潜力但需要调参或修代码。这个 subset-first 策略的直觉很清楚:顶级论文问题往往包含多个数据集、多个指标和多条基线,若每个 idea 都直接全量实验,计算成本会迅速失控;但子集结果又只能作为粗筛,不能直接作为最终结论,所以 Good 之后还要进入 Full-Set 阶段,与原始 SOTA 结果比较。
论文把这一整套想法实施过程抽象为统一 Coder 接口:
这里 是候选想法, 是该想法产生的实验结果, 是可复现代码, 是 critic 发出的三态决策, 是反馈理由。相比前式只定义最终产物,这个式子承担的是内部状态迁移的角色:它说明 ScientistTwo 的 idea evolution 不是随机改写提示词,而是让每个候选想法都经历一次代码实现、子集验证、工程修补和全量扩大的证据生产。若 一直停留在 Engineer 而工程预算耗尽,系统会把它降级为 Bad;若 为 Good,才进入后续 best idea selection。这个机制把“想法是否漂亮”变成“想法是否能在基准上被验证”,从而降低纯语言生成容易出现的 hallucinated improvement。
当多个想法通过验证后,Selector Agent 会从全部 Good 候选中挑选最适合下游消融和写作的主假设:
其中 比较性能指标和执行日志,从全量基准上被验证为 Good 的候选里选出最优假设。该式的作用不是重新实验,而是把分散证据压缩成一个可写论文的主贡献。它的边界也很清楚:如果没有任何 为 Good,论文说系统会终止;如果 只是偶然在子集或某个 split 上占优,下游 ablation 阶段仍可能暴露它无法被解释。ScientistTwo 随后正是用 Ablation Planner 和 Ablation Coding Agent 自动构造组件级去除、替换或修改,追问增益是否真的来自核心机制。Table 1 中 Ablation study 的 critic 问题是 “Is the component breakdown clean?”,这句话比一般调参系统里的 “is score higher?” 更接近科学论文审稿。
模拟评审与 rebuttal 是第三处关键设计。Peer-Reviewer Agent 给出 strengths、weaknesses、questions 和 1 到 10 分评分;若评分低于阈值,论文设置示例为 8,系统不是只让 Writer Agent 改措辞,而是调用 Rebuttal Planner Agent 生成补充实验任务,再由 Rebuttal Coding Agent 执行这些任务。这个选择很关键:评审意见中的问题往往要求实证,例如泛化性、鲁棒性、复杂度、失败模式或基线缺失;如果 rebuttal 只停留在文字层面,就无法真正消解质疑。Meta-Review Agent 随后评估 paper 与 review 是否达到 venue bar;若决定 Refine,系统会回到 Full-Set Engineering Agent,更新核心假设并重新跑 ablation、drafting 和 review。Figure 3 的 overview 正是这条循环的可视化:从 previous experiments、ablation studies 和 reviewer 出发,生成并验证 novel ideas,最终输出 publication-ready papers。
代价与边界:速度、成本和证据强度
系统的另一面是代价。论文第 4.3 节在 NeurIPS 2025 派生的 33 个问题上分析成本,Figure 10(a) 和文字报告 ScientistTwo 平均需要 2 到 3 天完成一个完整研究周期。这个时间远短于人类团队,但对实验室级自动化科研而言仍不便宜,尤其因为多数时间消耗在 Idea Refinement、Dynamic Peer-Review 和 Meta-Review 阶段。Figure 10(b) 还给出平均约 3,800,两处口径略有差别,但数量级一致。它意味着 ScientistTwo 目前更像高投入的单任务 discovery engine,而不是廉价普及工具。
证据强度也存在边界。主评估大量依赖自动评审器,而论文自己承认 ScholarPeer 既是评审器,也在系统中用于 refine draft,因此它属于 in-distribution evaluator;Stanford Agentic Reviewer 才被定义为 development 中未见过的 held-out evaluator。这个区分很重要:只看 ScholarPeer 分数会高估系统,因为它直接参与了优化循环;Stanford 分数和接收率更能说明泛化。Table 2 显示 ScientistTwo 的 Stanford 平均分为 5.7,接收率 72.1%,虽然显著优于基线,但仍低于其 ScholarPeer 的 7.5 和 91.9%。同时,ScientistTwo 的成功率是 86 个任务中完成 80.4%,并非所有输入都能推进;ICLR 2026 Spotlight 行与 Overall 行之间也说明它在不同 venue 分布上的稳定性有限。
论文还给出一个与 AutoSOTA 的对比,提醒读者不能把所有“自动研究”混为一谈。Table 4 显示 AutoSOTA 在 105 个任务上 median gain 为 2.7,average gain 为 7.5;ScientistTwo 在 86 个任务上 median gain 为 7.7,average gain 为 25.2。在 NeurIPS 2025 任务上,ScientistTwo 同样领先:median 7.0 对 3.7,average 13.9 对 8.5。但在 ICLR 2026 任务上,ScientistTwo 的 average gain 只有 3.8,低于 AutoSOTA 的 7.2。正文解释这个差异来自目标不同:AutoSOTA 更像对既有代码和超参数空间进行搜索,而 ScientistTwo 要求提出新的方法性贡献,并通过 ablation 证明组件可解释。Appendix B 进一步说 AutoSOTA 的五项 ICLR 改进没有引入新算法组件,ScientistTwo 则要求增益能被归因到 proposed mechanism。这说明本文的指标优势不能脱离其任务定义:它不是单纯找“分数提升”,而是找“能写进论文且能辩护的贡献”。
实验与证据
Table 2 报告了八个自主科研代理框架在 ScholarPeer 和 Stanford Agentic Reviewer 下的平均评分、标准差与接收率,其中 “# Papers” 表示各系统公开可汇总的 AI 生成论文数量:
| Framework | Public papers | ScholarPeer average rating | ScholarPeer acceptance rate | Stanford average rating | Stanford acceptance rate |
|---|---|---|---|---|---|
| AI-Researcher | 7 | 1.0±0.0 | 0.0 | 2.4±0.6 | 0.0 |
| CycleResearcher | 6 | 1.0±0.0 | 0.0 | 2.8±1.0 | 0.0 |
| AI Scientist-v2 | 3 | 2.0±1.0 | 0.0 | 2.5±0.2 | 0.0 |
| AutoResearchClaw | 4 | 2.5±1.0 | 0.0 | 3.7±0.5 | 0.0 |
| Zochi | 2 | 3.0±0.0 | 0.0 | 2.9±0.6 | 0.0 |
| DeepScientist | 3 | 3.0±0.0 | 0.0 | 4.1±0.6 | 0.0 |
| ScientistOne | 21 | 3.8±1.2 | 14.3 | 4.1±0.7 | 0.0 |
| ScientistTwo | 86 | 7.5±1.3 | 91.9 | 5.7±0.6 | 72.1 |
这张表的关键不是 ScientistTwo 的绝对高分,而是它在两个评审器上同时拉开与旧系统的差距。ScientistOne 是表格中最强的 prior baseline,其 ScholarPeer 平均分为 3.8,接收率 14.3%;ScientistTwo 将 ScholarPeer 平均分提高到 7.5,接收率提高到 91.9%。更重要的是,Stanford Agentic Reviewer 下所有 baselines 接收率均为 0.0,而 ScientistTwo 为 72.1%。这说明系统的改进并非只在自身使用的 ScholarPeer 上奏效。不过 “# Papers” 一列也暴露了统计可比性问题:ScientistTwo 的 86 篇是其自身公开生成论文数,而多数基线公开论文数只有 2 到 7 篇。样本量不同会影响平均值和标准差的稳定性,尤其对 Zochi、DeepScientist 这类小样本基线。论文没有给出置信区间,只报告了均分和标准差,因此这里应把结果理解为趋势性优势,而不是严格的统计检验。
Table 3 则把 ScientistTwo 与人类 accepted papers 放在同一评审体系中比较。Table 3 显示,ScientistTwo Overall 行为 86 除以 107,ScholarPeer 平均 7.5,接收率 91.9%;Stanford 平均 5.7,接收率 72.1%。相比之下,ICLR 2026 Accepted 为 ScholarPeer 6.8、Stanford 5.2;NeurIPS 2025 Accepted 为 ScholarPeer 6.2、Stanford 5.5。论文据此说 ScientistTwo 在两个 venue 的 accepted paper 平均分上超过人类论文。但这个比较必须谨慎:ScientistTwo 的输入论文本身就来自这些 venue,系统是在它们的问题上继续推进,不是随机抽样同一会议的全部论文。另一方面,ICML 2026 Spotlight 的人类论文在 Stanford 下接收率为 96.9%,平均分 6.1;ScientistTwo 在对应 49 除以 64 的成功任务上 Stanford 平均为 5.7,接收率 69.4%。这与 Conclusion 的判断一致:系统能逼近 top-tier acceptance bar,但还没有稳定达到 Spotlight 或 Oral 级别。
| Venue | Papers | ScholarPeer rating | ScholarPeer acceptance | Stanford rating | Stanford acceptance |
|---|---|---|---|---|---|
| Agent4Science 2025 accepted | 4 | 3.0±0.0 | 0.0 | 3.8±0.4 | 0.0 |
| ICLR 2026 accepted | 5 | 6.8±1.6 | 60.0 | 5.2±0.7 | 60.0 |
| NeurIPS 2025 accepted | 38 | 6.2±1.9 | 65.8 | 5.5±0.7 | 76.3 |
| ICML 2026 Spotlight | 64 | 6.9±1.5 | 79.7 | 6.1±0.5 | 96.9 |
| ScientistTwo overall | 86 / 107 | 7.5±1.3 | 91.9 | 5.7±0.6 | 72.1 |
拆解性证据主要来自三组实验。第一是 Table 5 的 rebuttal ablation:没有 rebuttal agent 的 ScientistTwo Variant 在 ScholarPeer 下为 5.2,在 Stanford 下为 46.9% 和 49.0% 接收率;加入一轮 rebuttal 后 ScholarPeer 提高到 6.9,Stanford 接收率提高到 73.5%;二轮后 ScholarPeer 为 7.6,接收率 93.9%,但 Stanford 接收率略降至 69.4%。这显示 rebuttal 主要改善被优化评审器认可的证据,而 held-out 评审器可能在第二轮中更严格。第二是 Figure 9(a) 和 Figure 9(b):相对增益随 idea evolution 增加,早期 refinement 提升最明显;selected best ideas 分布表明,很多最终赢家并非原始 seed,而是从失败 trace 和成功 trace 演化出来的想法。第三是 Table 7 的 Integrity Audit:启用全部 refinement agents 后,49 个样本全部通过 score verification,spec violation 为 0 除以 49,reference verification 为 0 除以 1814,method-code alignment 为 49 除以 49。去掉对应 agent 会出现失败,这支持论文所谓“fully verified codebases”的说法,至少在其审计协议内成立。
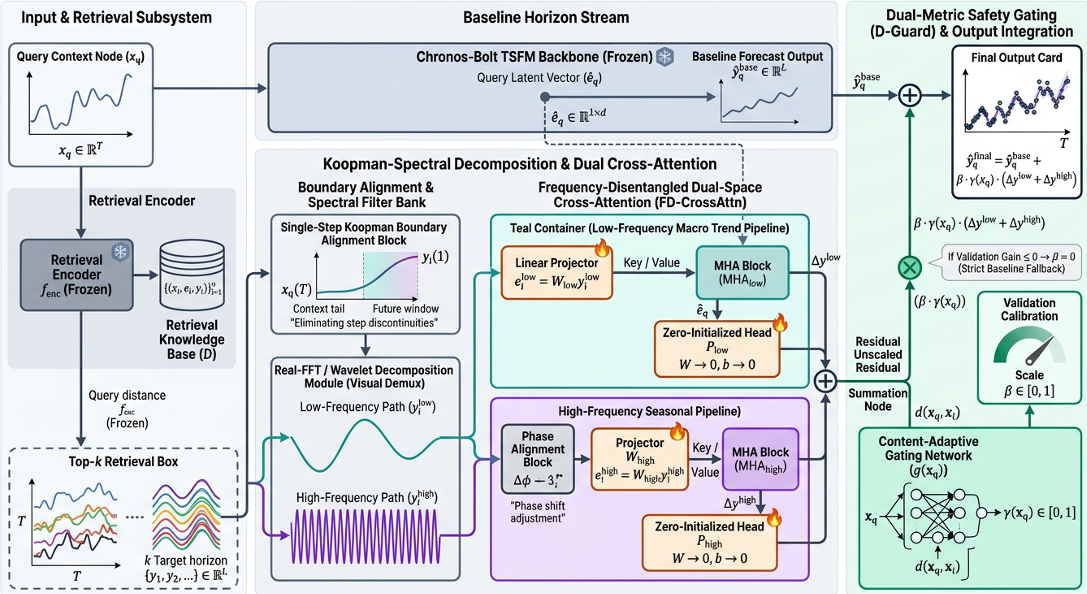
DynaSpec-RAG 案例展示了 ScientistTwo 生成论文的内部形态。正文第 1 节与 Figure 2 说,ScientistTwo 在一个增量 BPE tokenization 问题上相对人类基线获得 10.9% 的相对提升,并在 ScholarPeer 下得到 8.0 分、在 Stanford Agentic Reviewer 下得到 6.5 分。Appendix D 给出的 DynaSpec-RAG 论文草稿则显示,它针对时间序列 retrieval forecasting 中 retrieved targets 作为 monolithic block 造成的边界跳变、趋势和季节混叠、负迁移问题,提出 single-step boundary continuation、real-FFT sub-band decomposition、content-adaptive gating 和 validation-calibrated safety guard。Figure 11 的架构图中,模块在 frozen time-series foundation model 的输出空间上加 0.27M trainable parameters,Table 11 报告平均 MSE 为 0.1892、MAE 为 0.2488,优于 TS-RAG 的 0.1940 和 0.2492。这个案例的价值在于证明 ScientistTwo 不只是把 prompt 改成模板,而能生成包含动机、方法、消融和效率分析的论文结构。但也要看到,DynaSpec-RAG 的增益幅度相对时间序列 forecasting 基准并非颠覆式,它更像在一个工程可行空间中做出有解释的小幅改进。
深度洞察与总结
ScientistTwo 的核心贡献落在三处机制上。第一,它把自主科研从 candidate scoring 推进到 evidence production:想法不只要被生成,还要被实现、验证、消融、反驳和审计。第二,它把子集筛选作为工程策略,把全量基准作为科学结论门槛,避免在复杂多数据集问题上盲目扩展计算。第三,它让 simulated review 与 rebuttal 成为流水线的一部分,而 reviewer feedback 会触发新的实验任务。这三点共同回应了现有系统的失效机制:缺少因果归因、缺少动态实验补全、缺少代码与论文之间的一致性约束。
论文最有说服力的地方不是某个单一 SOTA 分数,而是把多个约束放在一起考核。Table 2、Table 3、Table 4、Table 5、Table 7 分别覆盖评审质量、人类论文对照、与 AutoSOTA 的任务增益、rebuttal 贡献和代码完整性。ScientistTwo 的优势在这些维度上大体一致:它生成更多证据,也通过更多审计。这比过去只报告“某个 benchmark 分数提高了多少”的工作更接近科学发表的真实压力测试。
但其局限也具体且可证伪。第一,评测依赖自动化评审器,而 ScholarPeer 同时参与论文草稿优化,虽然 Stanford Agentic Reviewer 是 held-out evaluator,论文仍未提供真实人类会议 reviewer 的盲审结果。第二,任务增益主要来自解析主表并平均报告,Table 4 与 AutoSOTA 的比较并非严格同协议,因为两个系统优化的 metric 和 reproduced baseline 不同。第三,ScientistTwo 在 ICLR 2026 任务上的 average gain 为 3.8,低于 AutoSOTA 的 7.2,说明当问题更偏配置优化或既有算法空间狭窄时,强制追求“新组件加可归因”可能牺牲分数效率。第四,平均成本约 $3765、周期 2 到 3 天,限制了其在普通学术组中的规模化运行。论文 Conclusion 也明确承认其尚未稳定达到 Spotlight 或 Oral 级别的概念突破。
未来最值得追问的不是“能不能再来 100 篇论文”,而是两个更基础的问题:一是如何把自动评审器从 in-loop optimizer 变成独立 verifier,降低奖励黑客和评审偏置;二是如何在高成本下保留 evidence-heavy 的研究风格,同时扩大理论型或实验科学型问题的覆盖。ScientistTwo 给出的工程答案是把科学发表中的限制、想法、代码、消融、评审、rebuttal 和 meta-review 全部变成可执行模块。它没有证明 AI 已能全面超越人类科学家,但它确实把“自主科研”从生成文本推到了一个更难、也更可信的位置:如果一篇 AI 论文不能跑通代码,不能解释增益,也不能回应补充实验,那它就不应该通过。