
sciwrite-lint:终结 AI“氛围写作”,为科学论文装上自动化校验器
sciwrite-lint: Verification Infrastructure for the Age of Science Vibe-Writing
本文推出了 sciwrite-lint,一个专门针对“科学氛围写作(Vibe-Writing)”时代的开源验证基础设施。该工具采用软件工程中的 Linting 范式,通过本地运行的轻量化 LLM(如 Qwen3 8B)对学术论文的引用真实性、声明支撑力及全文内部一致性进行深度静态检查。
TL;DR
随着生成式 AI 的普及,科学界正面临“氛围写作(Vibe-Writing)”的威胁——文章读起来旁征博引、逻辑严密,实则引用虚构、数据打架。本文提出的 sciwrite-lint 是首个将软件开发中的 Static Linting 概念引入学术写作的工具。它能足不出户(本地 GPU 运行)帮你查出论文中谁在撒谎、哪张图和文字对不上,并根据科学哲学原理给文章的“硬核程度”打分。
1. 痛点:被 AI 污染的科学引用链
在当前的学术环境下,验证一篇论文的所有引用几乎是不可能完成的任务:
- 引用的膨胀:现代论文平均拥有 45 个以上引用,评审人精读的不到 5%。
- AI 的“幻觉”:LLM 经常制造不存在的论文,或者仅根据标题盲猜内容。
- 隐私瓶颈:由于泄密风险(如三星代码泄露事件),研究人员不能将未发表的草稿上传到 ChatGPT 等云端服务进行润色和检查。
作者指出,目前的科研体系缺乏一种在撰写阶段就能快速反馈、全量核查引用的工具。
2. 核心机制:深度引用递归验证
sciwrite-lint 的核心不在于简单的 API 对比,而在于其深度验证流水线(The Verification Pipeline)。
2.1 递归穿透能力
不同于传统的引用检查工具(只查引用是否存在),sciwrite-lint 会“多走一步”:
- 本地解析:提取论文中的 Claims 和 Citations。
- 自动获取:从 OpenAlex、Semantic Scholar 等 14 个开放源下载被引论文。
- 引用链追踪:系统不仅检查被引论文是否支持当前的声明,还会自动解析被引论文本身的参考文献,检查其元数据准确性和撤稿状态(对接 Retraction Watch 分钟级更新库)。
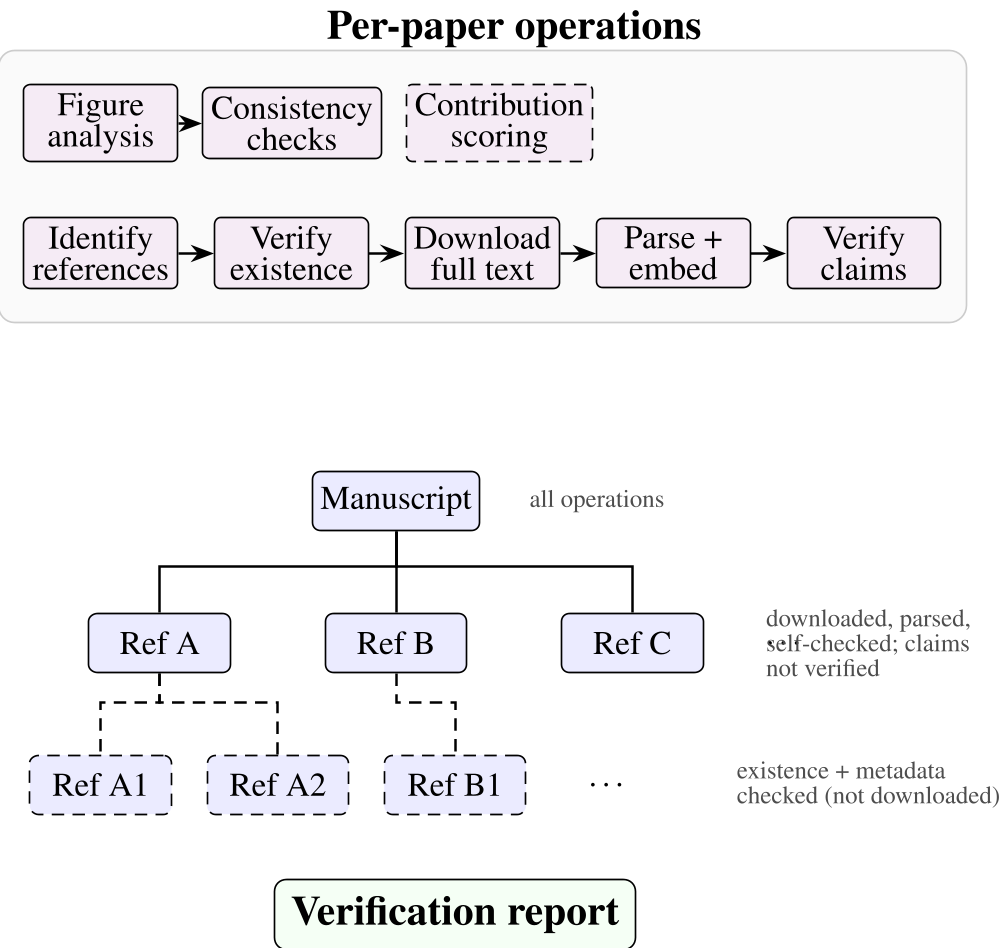 图 1:sciwrite-lint 的三层验证架构,实现从 manuscript 到 cited papers 再到 references 的深度穿透
2.2 内部一致性(Internal Consistency)
除了外查,更有内校。系统会通过视觉-语言模型(Qwen3-VL)扫描论文中的图表,对比:
- 数表对比:正文里的数字和表格里的数据是否符合?
- 图文一致:Axis Labels 是否与描述一致?
- 统计一致性:百分比求和是否等于 100%?
3. SciLint Score:不仅仅是影响力,更是贡献度
这篇论文最令人兴奋的理论贡献是 SciLint Score。作者认为 H-index 反映的是注意力,而非科学价值。他将科学哲学(Philosophy of Science)带入了算法逻辑:
- 证伪性(Popper):声明是否具体且可测试?
- 进步性(Lakatos):是提出了新预测,还是在为旧理论“打补丁”?
- 解释统一性(Kitcher):是否跨学科建立了连接?
- 严谨性(Mayo):基线对比和消融实验是否足够“硬”?
系统通过 LLM 对论文中的每一条 Claim 进行五个维度的打分,最终生成一个“雷达图”。
 图 2:三类论文的 SciLint 评分档案:诺贝尔奖发现(均衡且高分)、诚实的复制性研究(严谨性高但进步性低)、以及撤稿欺诈论文(进步性陡增但严谨性接近零)。
4. 实验表现与技术栈
- 硬件门槛:单张 RTX 4080/4090 即可运行,完全离线化,隐私友好。
- 准确率:在真实论文语料库中,对注入的“由于 AI 编辑导致的错误”达到了 98.5% 的召回率。
- 模型选型:使用了 Qwen3 8B(FP8 量化)和 Snowflake Arctic 嵌入模型。作者提出了“验证先验假设”,认为小型专门化模型在事实核查上往往比超大规模模型更具优势,因为它们不容易产生“阿谀奉承(Sycophancy)”倾向。
5. 局限性与展望
尽管表现强劲,sciwrite-lint 目前仍面临挑战:
- 运行耗时:长文首次验证需 30 分钟。
- 非开源文献:如果引用的文献在 paywall 之后且本地无 PDF,系统仅能从摘要进行推断。
- 哲学维度的量化:目前对“证伪性”的判断仍依赖 LLM 的提示词工程,存在主观误差。
6. 总结
sciwrite-lint 的出现为学术界提供了一把“手术刀”。它不仅仅是一个查错工具,更是一套学术规范的数字化准则。对于写作者,它是减少低级错误、提升论证质量的导师;对于期刊,它是高效过滤低质量、甚至是学术不端稿件的第一道防火墙。
未来,当 AI 写出的论文比人读得还快时,我们需要 AI 来守护科学的真实。