
[NeurIPS 2023] SDA:得分模型重塑数据同化,摆脱物理模拟器的高维推断
Score-based Data Assimilation
2023-06-21
总结
问题
方法
结果
要点
摘要
本文提出了基于得分的数据同化算法 (Score-based Data Assimilation, SDA),通过得分生成模型解决随机动力系统的状态轨迹推论问题。核心方法是利用马尔可夫结构将长轨迹得分分解为局部短片段得分,并在无需模拟物理模型的情况下实现全后验分布的 Zero-shot 采样。
TL;DR
数据同化(Data Assimilation, DA)一直是地球物理、气象预测等领域的核心难题,其本质是结合有噪观测和物理规律来推断系统状态。本文提出的 SDA (Score-based Data Assimilation) 放弃了通过繁重的物理模拟器进行迭代优化的传统路径,转而使用得分生成模型。它通过将长轨迹分解为局部片段,实现了非自回归的高效采样,并能在 Zero-shot 场景下应对各种复杂的观测模型。
1. 动力系统推断的“痛”与“痒”
在处理大气、海洋等复杂系统时,传统方法如 4D-Var 或粒子滤波器(PF)面临两大瓶颈:
- 计算成本极高:必须对复杂的物理模型进行反复的前向模拟和反向求导(Adjoint Model)。
- 维数灾难:状态空间动辄数百万维,长时程轨迹的梯度往往会消失或爆炸。
即使是近年来兴起的深度学习方法,大多也需要针对特定的观测模型进行端到端训练。一旦观测设备的分辨率、位置或噪声水平发生变化,模型往往需要推倒重来。
2. 核心机制:局部得分与伪马尔可夫毯
SDA 的核心直觉在于:长轨迹的物理一致性可以通过局部约束来维持。
伪马尔可夫毯 (Pseudo Markov Blanket)
动态系统通常具有一阶马尔可夫性,即当前状态仅依赖于前后相邻状态。但在扩散模型的加噪过程中,这种严格的独立性会被破坏。作者提出了“伪马尔可夫毯”概念:虽然在扩散中间维度独立性不复存在,但其互信息随时间演化有规律可循。
作者发现,只需要使用一个全卷积神经网络 (FCNN) 在短轨迹片段上进行训练,就能通过滑动窗口的方式拼接出完整长轨迹的得分:
abla_{x_i(t)} \log p(x_{1:L}(t)) \approx abla_{x_i(t)} \log p(x_{i-k:i+k}(t))$$ 这不仅极大降低了训练数据量,还允许我们在推理时进行大规模并行化。 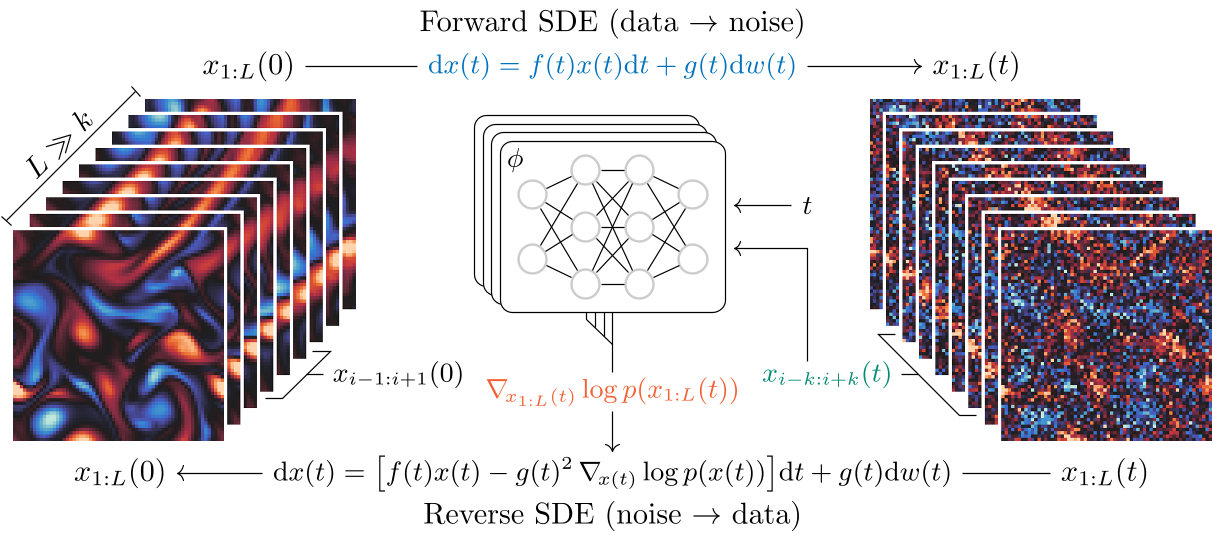 *图 1:SDA 将长轨迹分解为子片段进行得分估计,随后通过非自回归方式同步生成所有状态。* ## 3. 稳定推断:超越 DPS 的似然近似 在解决逆问题时,如何计算 $ abla_{x(t)} \log p(y|x(t))$ 是决定成败的关键。之前的 SOTA 方法(如 Diffusion Posterior Sampling, DPS)在处理高噪声或非线性观测时经常崩溃。 本文通过对先验分布协方差的深度分析,引入了一个校正项 $\Gamma$,提出了更稳定的似然近似公式: $$p(y \mid x(t)) \approx \mathcal{N}\left(y \mid \mathcal{A}(\hat{x}(x(t))), \Sigma_{y} + \frac{\sigma(t)^{2}}{\mu(t)^{2}} A \Gamma A^{T}\right)$$ 这种改进使得 SDA 在不进行启发式步长缩放的情况下,依然能保持推理的数值稳定性。 ## 4. 实验见证:从 Lorenz 到湍流流场 ### Lorenz 1963:精准的后验解析 在经典的洛伦兹混沌系统中,SDA 不仅给出了点估计,还完美复刻了多峰分布的后验概率(图 2)。这意味着模型真正理解了系统演化的不确定性。 ### Kolmogorov Flow:复杂流体的补全 对于 64x64 的高维湍流场,即使观测数据在空间上极度稀疏、在时间上间歇性中断,SDA 依然能生成符合 Navier-Stokes 方程约束的物理轨迹。 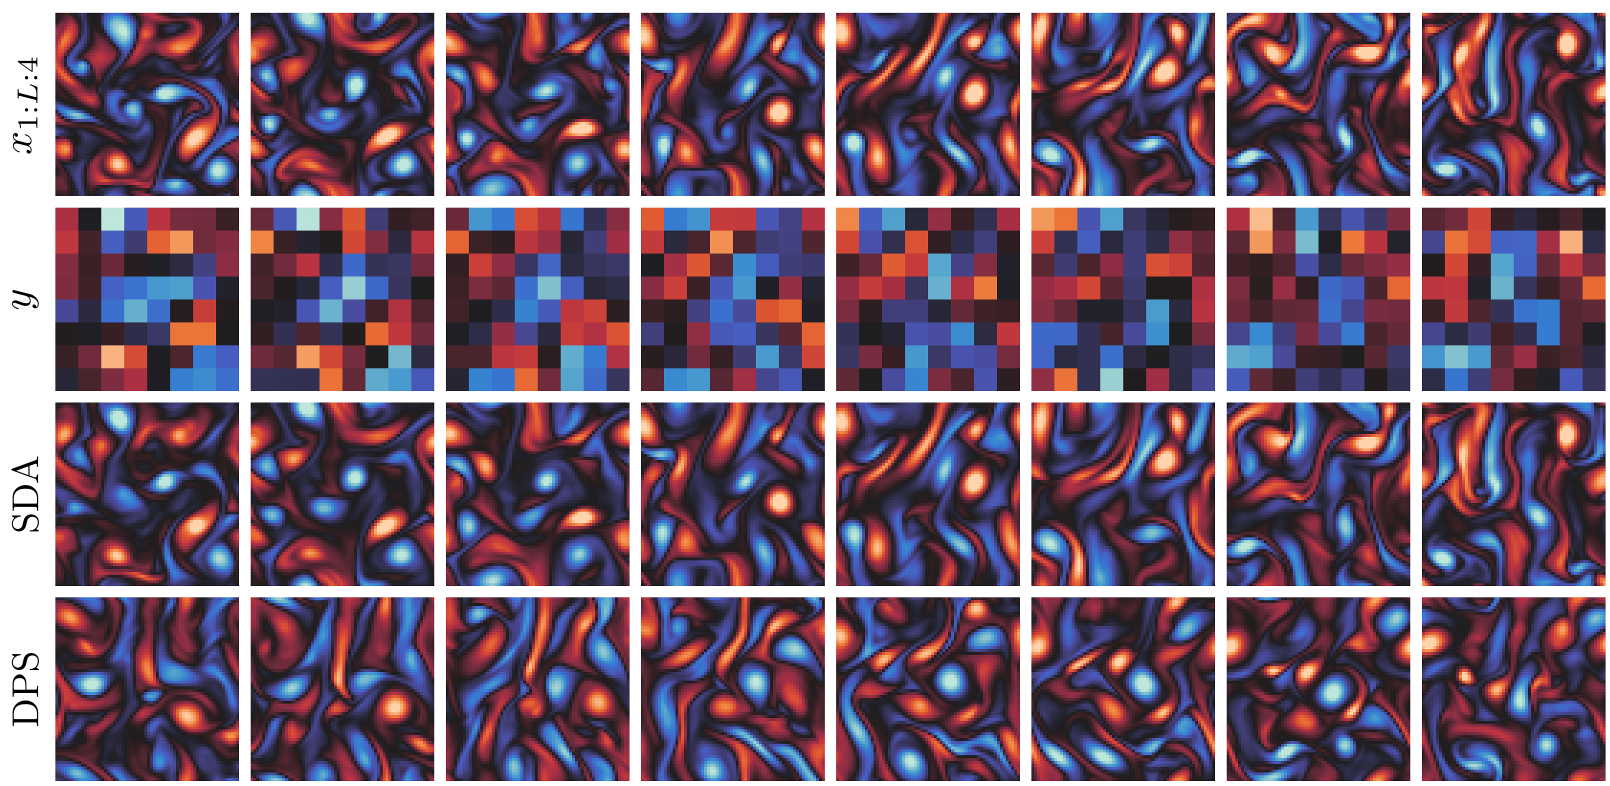 *图 2:在间歇性和高噪声观测下,SDA 准确还原了流场的涡量变化,表现远优于 DPS 近似。* ## 5. 局限与未来 尽管 SDA 展现了惊人的 Zero-shot 能力,但它仍面临挑战: - **推理速度**:虽然避免了物理模拟,但扩散模型的数百次迭代依然耗时。 - **参数识别**:目前模型假设物理参数已知,如何同时推断状态和未知物理参数是下一个前沿。 ## 总结与洞察 SDA 是生成式 AI 介入传统科学计算的一个范例。它告诉我们:**利用数据分布的局部一致性,可以绕过全球规模的参数优化。** 对于气象预报、海洋环境监测等依赖实时同化的领域,这篇论文提供了一套全新的技术栈。