
[Nature Methods] scVI:深度生成模型开启单细胞大数据分析的新纪元
scVI
本文推出了 scVI(single-cell Variational Inference),这是一个基于深度生成模型(VAE)的单细胞转录组(scRNA-seq)分析框架。它通过零膨胀负二项(ZINB)分布建模技术噪声,在批次效应校正、降维可视化、聚类及差异表达分析等任务上达到了 SOTA 水平。
TL;DR
传统的单细胞分析工具往往在“可扩展性”与“概率建模能力”之间顾此失彼。来自加州大学伯克利分校的团队开源了 scVI (single-cell Variational Inference),通过将变分推断(Variational Inference)与深度神经网络结合,首次实现了一个能够同时处理百万级细胞、校正批次效应、进行差异表达分析的统一概率框架。
背景定位:该工作是单细胞计算生物学领域从“启发式线性模型”向“深度概率生成模型”转型的里程碑作品,建立了大规模转录组数据标准化的新基准。
痛点深挖:为何单细胞数据这么“难搞”?
单细胞转录组测序(scRNA-seq)就像是在一个充满噪音的黑盒子中捕捉极少量的分子:
- 捕捉效率极低 (Dropout):很多表达的基因因为采样随机性变成了“0”值。
- 测序深度变异 (Library Size):不同细胞捕捉到的分子总量差异巨大,这不是生物变异,而是技术偏好。
- 批次效应 (Batch Effects):不同实验室、不同时间测得的数据无法直接对比。
前人工作如 ZIFA 或 ZINB-WaVE 虽然尝试建立概率模型,但受限于计算复杂度(无法处理超过 10 万个细胞)和模型灵活性(仅限于线性映射),难以应对当前爆发式增长的单细胞图谱数据。
方法论详解:当 VAE 遇见 ZINB
scVI 的核心逻辑是将每个细胞的基因表达分解为两个部分:独立的生物状态(潜变量 )和干扰技术因素(如库大小 和批次 )。
核心推断流程
- 编码阶段 (Encoder):通过神经网络将高维的基因表达矩阵映射到低维的高斯分布潜空间 。
- 解码阶段 (Decoder):利用另一个神经网络,结合批次信息 ,学习出反映基因表达概率的 ZINB(Zero-Inflated Negative Binomial) 分布参数。
- 优化目标:最大化变分下界(ELBO),通过 Adam 优化器进行随机梯度下降。
 图 1:scVI 架构示意图。左侧为编码器,从观测计数 学习潜变量;中间为生成过程,通过神经网络推导映射回 ZINB 参数。
这种设计的巧妙之处在于,它通过神经网络模拟了基因之间复杂的非线性交互(Inductive Bias),同时通过内嵌的库大小因子 实现了自动归一化。
实验与结果:速度与精度的双重碾压
1. 扩展性:百万级数据的实时处理
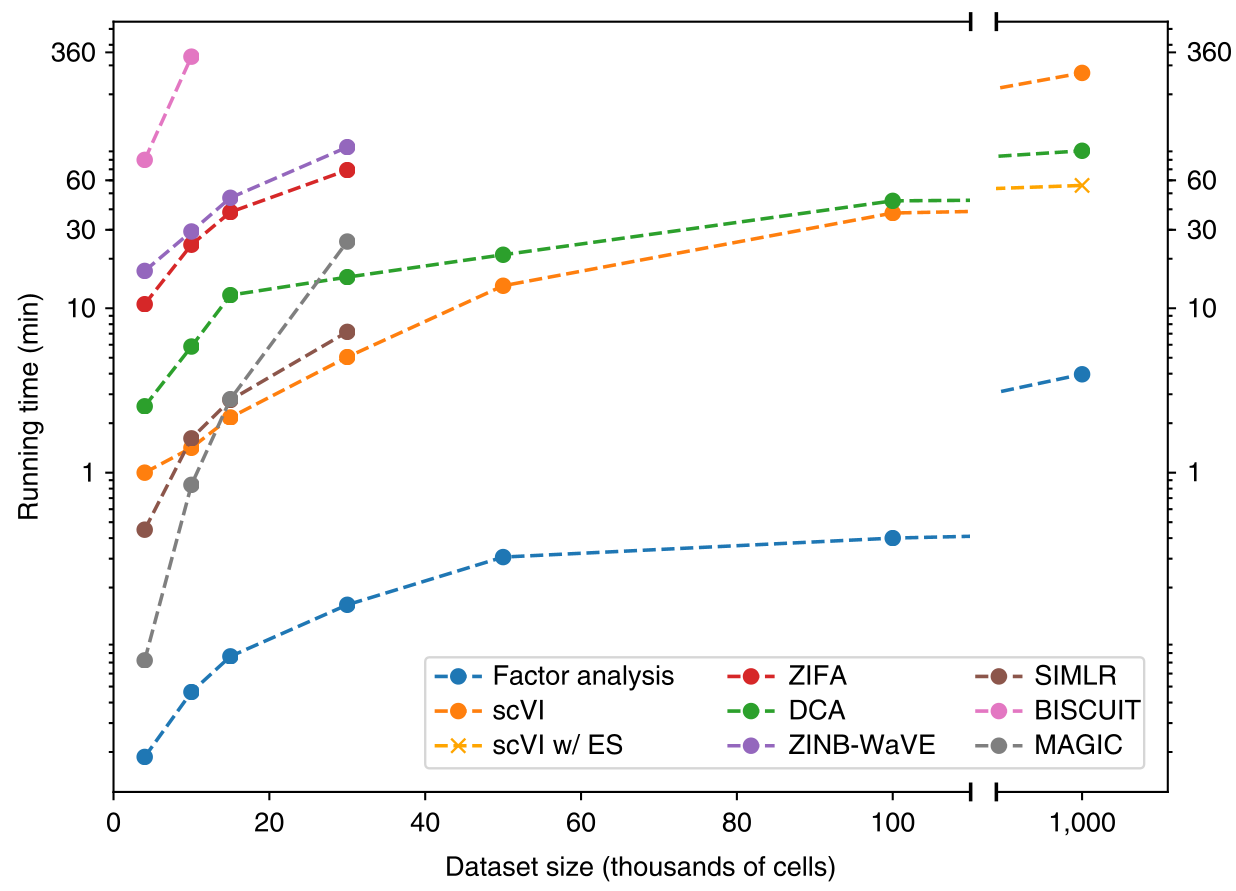
在对 130 万个小鼠脑细胞(10x BRAIN-LARGE)的测试中,scVI 展示了极强的线性扩展能力。相比之下,传统的聚类或降维工具在 5 万个细胞左右就会耗尽内存。
2. 差异表达 (DE) 检测
scVI 的另一个亮点是它不需要 P-value 过滤,而是直接计算 Bayes Factor。在与 bulk 测序的真值对比中,scVI 在 T 细胞亚型区分任务上的 AUROC 超过了 edgeR 和 MAST 等专门的 DE 工具。
 图 2:在 PBMC 数据集上,scVI 的差异表达结果与 Bulk 金标准高度吻合。
深度洞察:为什么 scVI 这么有效?
- 解耦 (Disentanglement):它是少数明确对“库大小”和“批次”进行物理意义建模的深度学习方法,而不仅仅是黑盒压缩。
- 概率本质:因为 scVI 学习的是分布而非点估计,它可以进行“数据填充”(Imputation),即通过后验分布预测那些丢失的基因表达值。
局限性与挑战
尽管 scVI 性能强劲,但在极小规模数据集上(如细胞数少于基因数),深度学习的过度拟合倾向会导致模型效果不如线性模型。此外,模型的超参数(如网络层数、学习率)对不同组织类型的数据可能具有敏感性,需要一定的微调经验。
总结
scVI 成功地将单细胞转录组分析从“统计描述”提升到了“生成式推断”的高度。随着人类细胞图谱(Human Cell Atlas)等国际项目的推进,scVI 提供的这种可扩展、标准化的分析范式将成为生物信息学家的常备利器。