Seedance 2.0:字节跳动的物理世界模拟器,音视频原生对齐的新范式

Seedance 2.0: Advancing Video Generation for World Complexity

2026-01-01
Team Seedance, De Chen, Liyang Chen, Xin Chen, Ying Chen, Zhuo Chen, Zhuowei Chen, Feng Cheng, Tianheng Cheng, Yufeng Cheng, Mojie Chi, Xuyan Chi, Jian Cong, Qinpeng Cui, Fei Ding, Qide Dong, Yujiao Du, Haojie Duanmu, Junliang Fan, Jiarui Fang, Jing Fang, Zetao Fang, Chengjian Feng, Yu Gao, Diandian Gu, Dong Guo, Hanzhong Guo, Qiushan Guo, Boyang Hao, Hongxiang Hao, Haoxun He, Jiaao He, Qian He, Tuyen Hoang, Heng Hu, Ruoqing Hu, Yuxiang Hu, Jiancheng Huang, Weilin Huang, Zhaoyang Huang, Zhongyi Huang, Jishuo Jin, Ming Jing, Ashley Kim, Shanshan Lao, Yichong Leng, Bingchuan Li, Gen Li, Haifeng Li, Huixia Li, Jiashi Li, Ming Li, Xiaojie Li, Xingxing Li, Yameng Li, Yiying Li, Yu Li, Yueyan Li, Chao Liang, Han Liang, Jianzhong Liang, Ying Liang, Wang Liao, J. H. Lien, Shanchuan Lin, Xi Lin, Feng Ling, Yue Ling, Fangfang Liu, Jiawei Liu, Jihao Liu, Jingtuo Liu, Shu Liu, Sichao Liu, Wei Liu, Xue Liu, Zuxi Liu, Ruijie Lu, Lecheng Lyu, Jingting Ma, Tianxiang Ma, Xiaonan Nie, Jingzhe Ning, Junjie Pan, Xitong Pan, Ronggui Peng, Xueqiong Qu, Yuxi Ren, Yuchen Shen, Guang Shi, Lei Shi, Yinglong Song, Fan Sun, Li Sun, Renfei Sun, Wenjing Tang, Boyang Tao, Zirui Tao, Dongliang Wang, Feng Wang, Hulin Wang, Ke Wang, Qingyi Wang, Rui Wang, Shuai Wang, Shulei Wang, Weichen Wang, Xuanda Wang, Yanhui Wang, Yue Wang, Yuping Wang, Yuxuan Wang, Zijie Wang, Ziyu Wang, Guoqiang Wei, Meng Wei, Di Wu, Guohong Wu, Hanjie Wu, Huachao Wu, Jian Wu, Jie Wu, Ruolan Wu, Shaojin Wu, Xiaohu Wu, Xinglong Wu, Yonghui Wu, Ruiqi Xia, Xin Xia, Xuefeng Xiao, Shuang Xu, Bangbang Yang, Jiaqi Yang, Runkai Yang, Tao Yang, Yihang Yang, Zhixian Yang, Ziyan Yang, Fulong Ye, Bingqian Yi, Xing Yin, Yongbin You, Linxiao Yuan, Weihong Zeng, Xuejiao Zeng, Yan Zeng, Siyu Zhai, Zhonghua Zhai, Bowen Zhang, Chenlin Zhang, Heng Zhang, Jun Zhang, Manlin Zhang, Peiyuan Zhang, Shuo Zhang, Xiaohe Zhang, Xiaoying Zhang, Xinyan Zhang, Xinyi Zhang, Yichi Zhang, Zixiang Zhang, Haiyu Zhao, Huating Zhao, Liming Zhao, Yian Zhao, Guangcong Zheng, Jianbin Zheng, Xiaozheng Zheng, Zerong Zheng, Kuan Zhu, Feilong Zuo
总结
问题
方法
结果
要点

字节跳动 Seed 团队发布了 Seedance 2.0,这是一个原生多模态音视频联合生成系统。该模型通过统一的架构支持文本、图像、音频和视频四类模态输入,在 Arena.AI 盲测榜单中位列 T2V 和 I2V 任务全球第一,实现了高保真物理世界复杂度的模拟。

TL;DR

字节跳动 Seed 团队正式推出了其新一代音视频生成大模型 —— Seedance 2.0。该模型不仅在 Arena.AI 视觉模型竞技场中霸榜 T2V 和 I2V 双赛道冠军,更在物理规律遵循(Physics Compliance)和原生音视频同步方面实现了跨越式突破。它支持长达 15 秒的高保真生成,深度集成了角色、动作、风格和音频的精准受控能力。

核心速览:为何 Seedance 2.0 是行业转折点?

在视频生成领域,我们经历了一场从“单纯序列生成”到“物理规律理解”的转型。Seedance 2.0 被定位为一种原生多模态大模型,这意味着它在训练之初就不仅是将音频作为视频的附属品,而是将两者在同一个特征空间内进行联合建模。其表现出的高阶导演和电影摄影思维,使其在专业创作场景中具备了极高的可用性。


1. 痛点深挖:生成模型的“恐怖谷”与“失语症”

当前视频生成模型主要面临三大挑战:

  • 物理一致性缺失:多主体互动时常出现肢体穿模(Overlap)或违反物理规律的运动。
  • 多维度失控:虽然能够通过 Prompt 文字控制,但难以实现“像这张图的人物、用那段音频的节奏、做这段视频的动作”这种复杂的组合控制。
  • 音画割裂:大多数模型是先生成视频再通过后置工具补齐音频,导致口型对齐(Lip-sync)不准,环境音缺乏空间感。

2. 架构解析:原生音视频联合生成

Seedance 2.0 的核心竞争力在于其统一的多模态处理能力

核心组件:

  • 全模态输入支持:它能够同时处理 Text, Image, Audio, Video 四种模态输入。
  • 双声道沉浸音频空间:内置升级的音频生成模块,支持背景音乐(BGM)、环境声效(Ambient SFX)与同步旁白的多轨输出。
  • 多参考控制(Reference-to-Video):通过对主体 ID 的强化记忆,解决了视频延长和编辑过程中最头疼的人脸闪烁、服装突变问题。
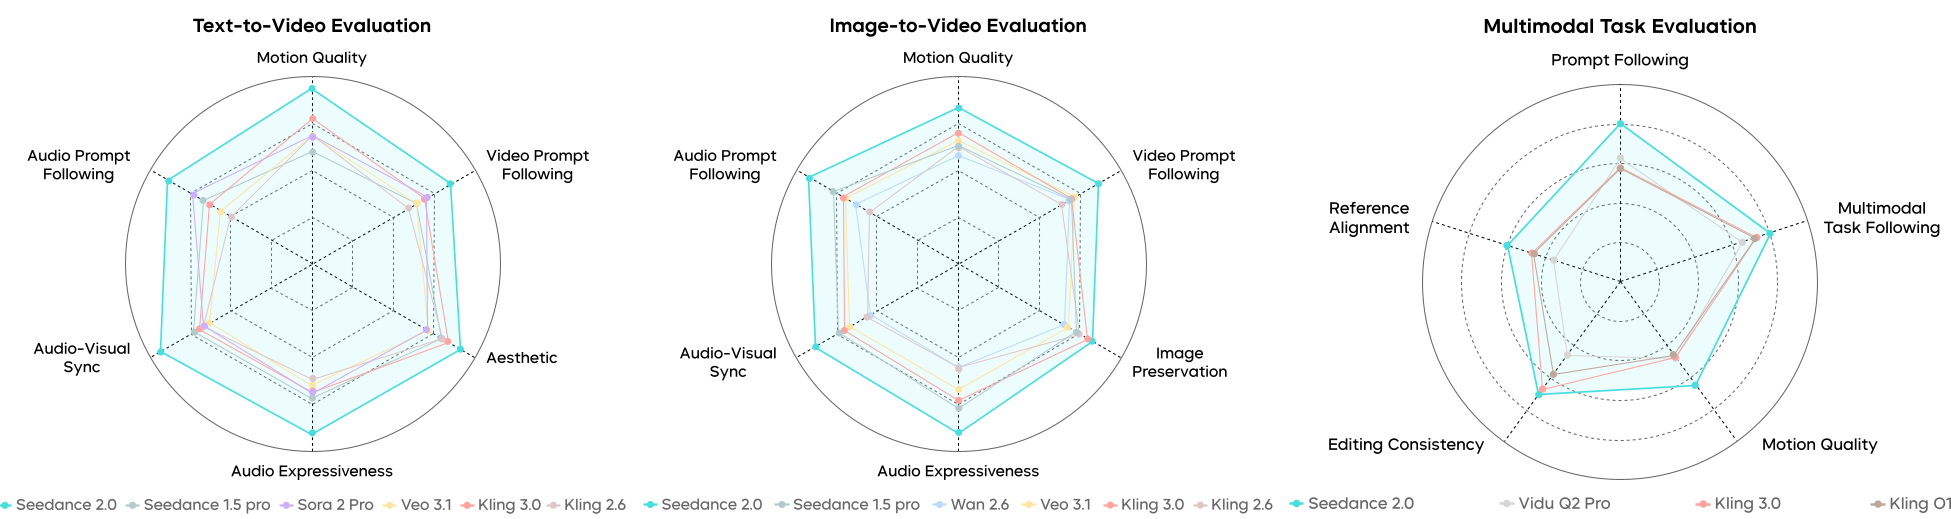
模型整体表现对比 图 1:Seedance 2.0 在 T2V、I2V、R2V 三大核心任务上相比竞争对手展现出的全方位领先。


3. 实验结果:竞技场上的“统治力”分析

Arena.AI 盲测领先

在 Arena.AI 的 Elo 排行榜上,Seedance 2.0 以显赫的 1450 分位居榜首,领先于 Google 的 Veo 3.1 约 79 分,领先 OpenAI Sora 2 Pro 约 86 分。

动作质量与物理模拟

在 SeedVideoBench 2.0 的压力测试中,Seedance 2.0 在“激烈运动(Intense Sports Motion)”和“实体交互(Entity Interaction)”维度提升尤为巨大。
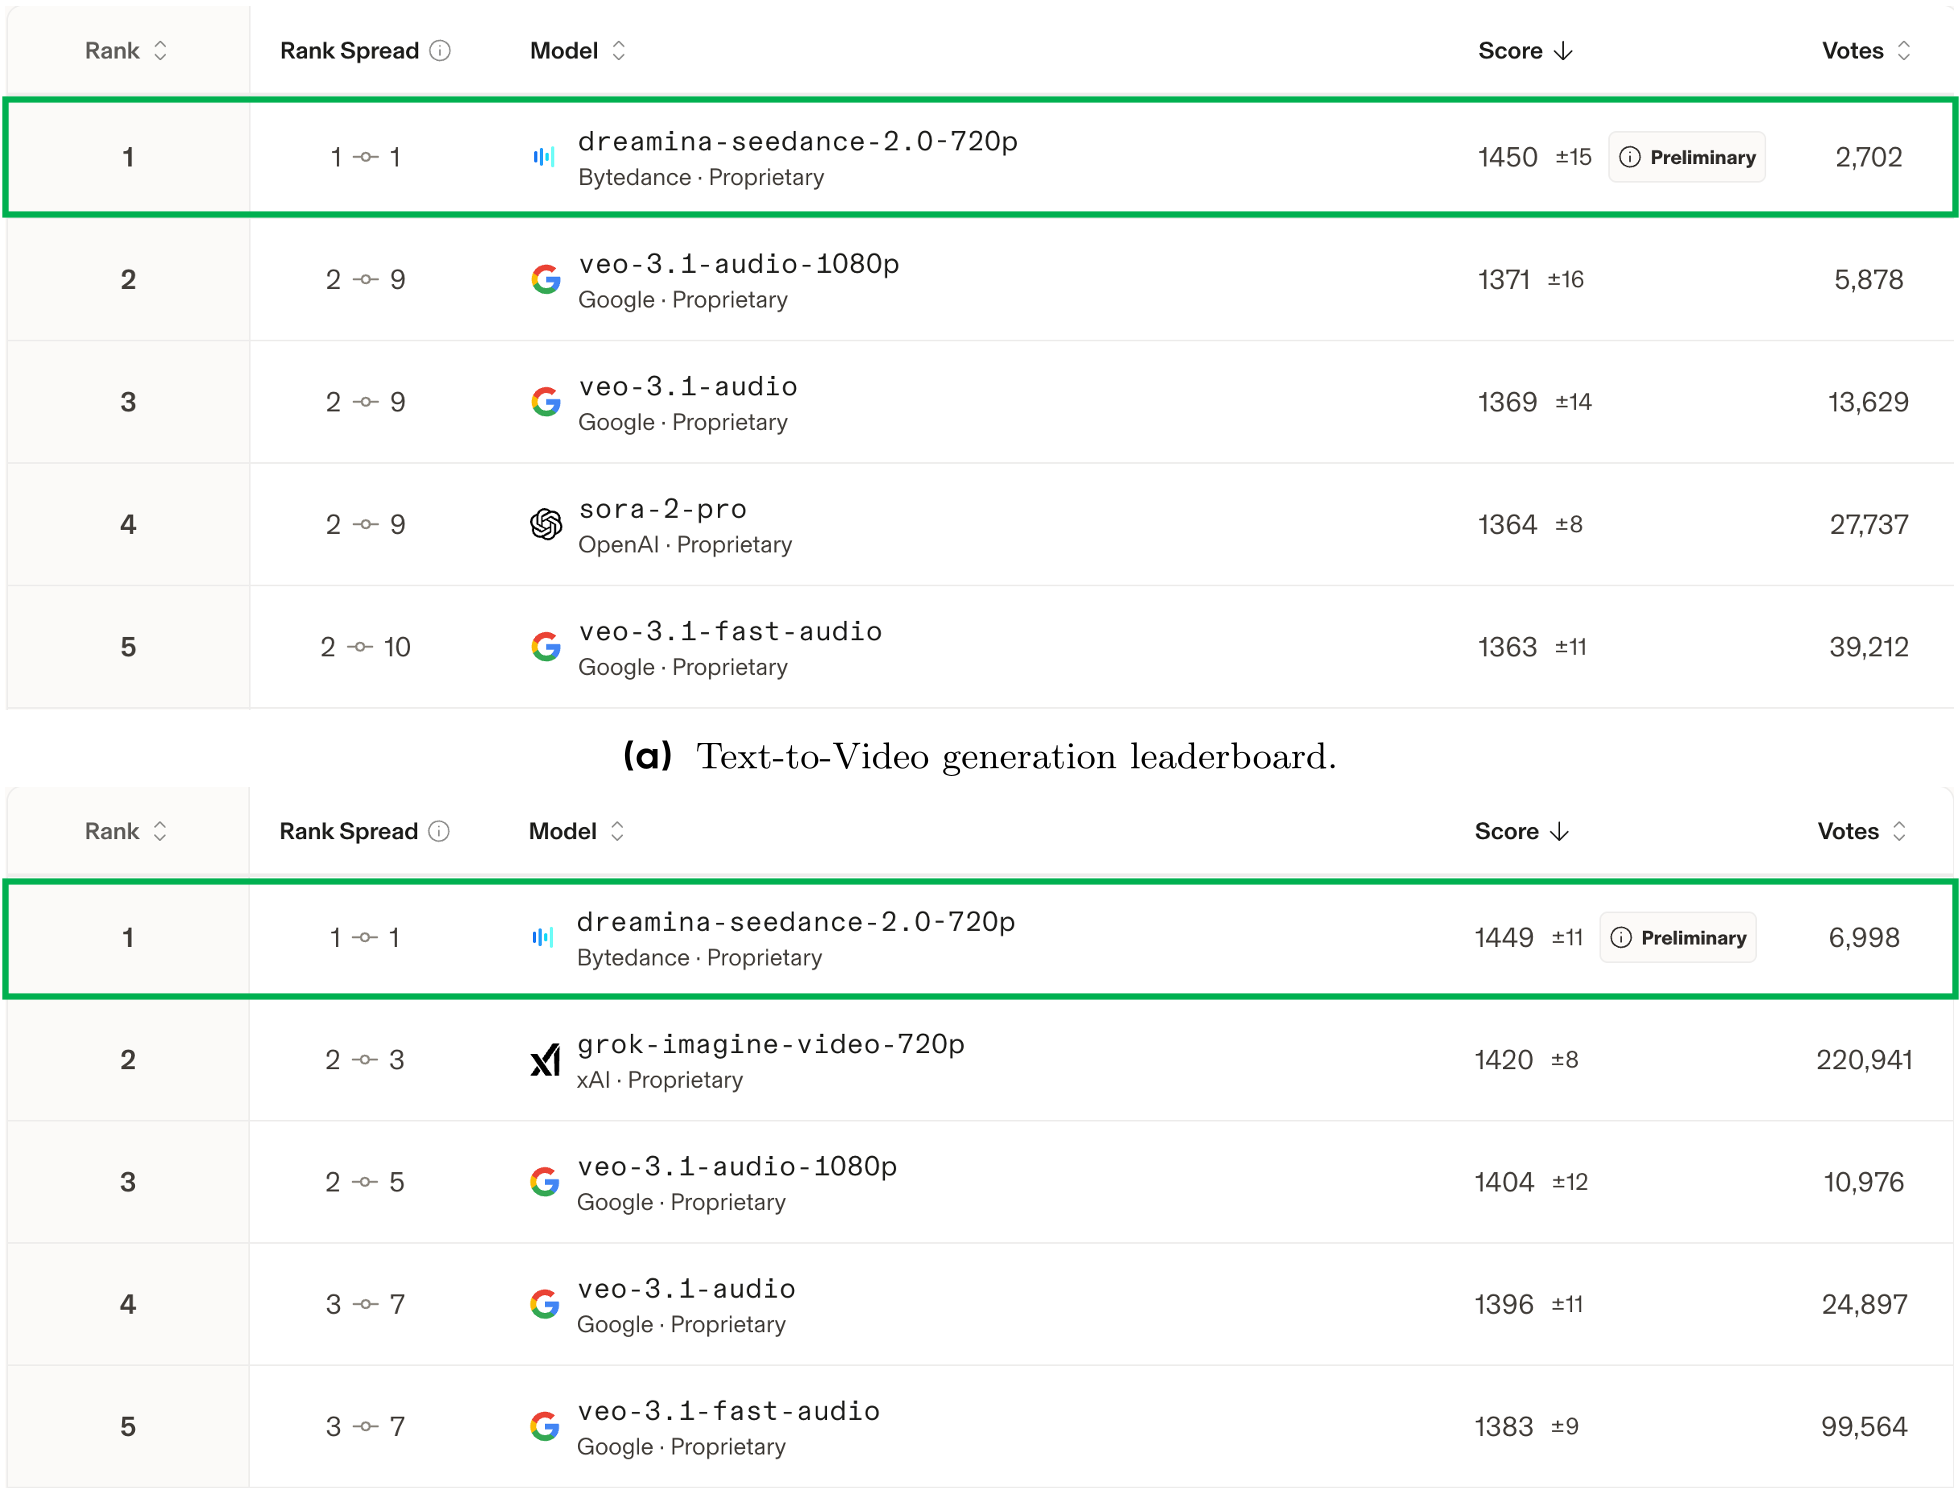
性能详细对比表 表 1:Arena.AI T2V 与 I2V 榜单排名。


4. 专项突破:中文语境的多模态深度理解

作为由字节跳动打造的模型,Seedance 2.0 在多语言能力,特别是中文垂直领域具有天然优势:

  • 方言与戏曲:模型能精准预测川剧、粤剧等特定艺术形式的音视频关联。
  • 文本渲染(Text Overlay):在视频中精准渲染中英文字幕,避免了生成式模型中常见的文字扭曲(Mangled Text)。

5. 深度洞察:生产力场景的“最后一公里”

Seedance 2.0 的 R2V(Reference-to-Video)能力不仅是科研上的指标,更是为了服务于生产力场景。

  • 视频延续(Continuation):它支持在原有视频后顺滑地生成符合逻辑的下一幕。
  • 风格迁移与特效精准控制:支持各种复杂风格(如油画、中国工笔画、毛毡风),且保证动态效果与风格笔触的有机结合。
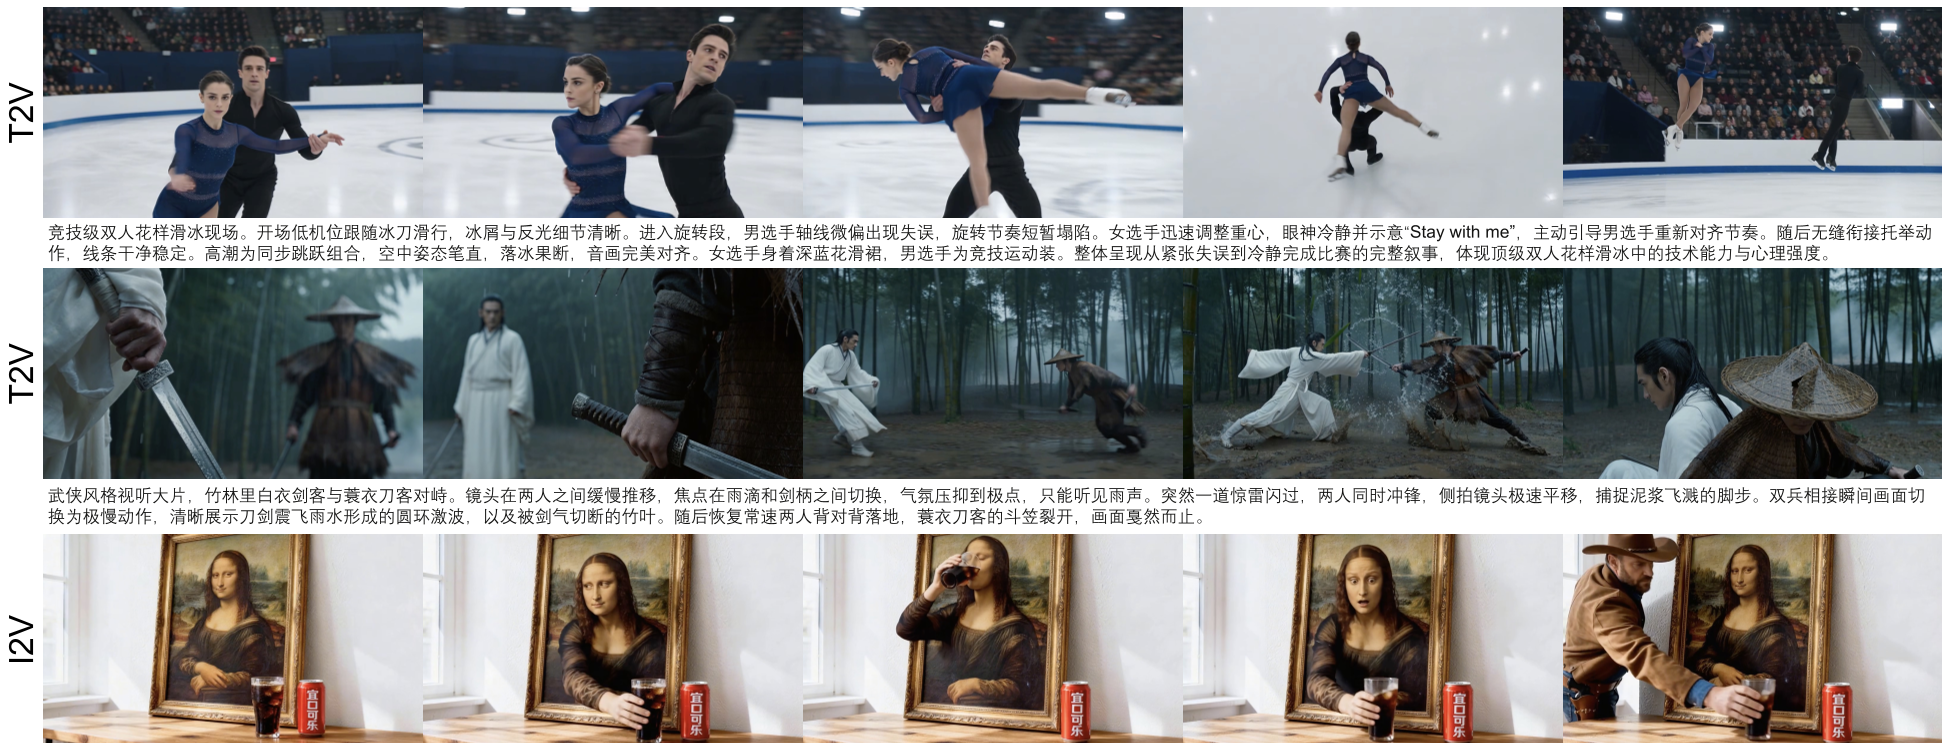
具体应用场景展示 图 2:生成的复杂交互场景:从画框中伸出手喝可乐,展示了极致的语义遵循与动态遮挡处理能力。


6. 总结与未来展望

Seedance 2.0 的出现,标志着视频大模型从“单点生成”步入了“全链路创作协作”的新时代。

  • 贡献:确立了音视频原生联合生成的行业基准。
  • 局限:在极端边缘案例(Edge Cases)下,偶尔仍存在微小的动作失真或多角色声音混淆。
  • 启示:未来的视觉模型必须具备更强的逻辑推理和物理常识理解能力,而不仅仅是简单的像素重建。

作者注:Seedance 2.0 的强大不仅体现在画面,更在于其“听觉与视觉的同频共振”。对于创作者而言,这不仅是一个生成器,更是一个能够理解电影摄影语言的 AI 合作伙伴。

发现相似论文

试试这些示例

  • 查找最近其他采用统一架构进行音视频联合生成(Joint Audio-Visual Generation)的最新 SOTA 论文。
  • 分析多模态参考(Multimodal Reference)在视频编辑任务中如何解决主体一致性(Subject Consistency)的理论基础。
  • 调研字节跳动 Seed 团队在论文中提到的 SeedVideoBench 2.0 评估标准与常用的 VBench 等指标的差异点。
目录
Seedance 2.0:字节跳动的物理世界模拟器,音视频原生对齐的新范式
1. TL;DR
2. 核心速览:为何 Seedance 2.0 是行业转折点?
3. 1. 痛点深挖:生成模型的“恐怖谷”与“失语症”
4. 2. 架构解析:原生音视频联合生成
4.1. 核心组件:
5. 3. 实验结果:竞技场上的“统治力”分析
5.1. Arena.AI 盲测领先
5.2. 动作质量与物理模拟
6. 4. 专项突破:中文语境的多模态深度理解
7. 5. 深度洞察:生产力场景的“最后一公里”
8. 6. 总结与未来展望