
SeedVR:以 Diffusion Transformer 开启无限分辨率与长度的通用视频修复新纪元
SeedVR: Seeding Infinity in Diffusion Transformer Towards Generic Video Restoration
本文提出了 SeedVR,一种基于 Diffusion Transformer (DiT) 的通用视频修复模型。通过引入 3D 偏移窗口注意力机制 (Shifted Window Attention) 和因果视频自编码器 (Causal Video VAE),该方法实现了对任意长度和分辨率视频的高效修复,并在多个 SOTA 基准上取得了领先的感知质量。
核心速览
TL;DR:SeedVR 是字节跳动与南洋理工大学联合推出的一种新型视频修复架构。它彻底抛弃了传统 U-Net 依赖全注意力(Full Attention)的局限,通过 Swin-MMDiT(偏移窗口多模态扩散 Transformer)和 Causal Video VAE,解决了视频修复中“高分辨率算不动”和“长视频不连续”的双重痛点。
背景定位:该工作是较早尝试将大规模可扩展的 Diffusion Transformer 应用于通用视频修复(VR)的探索,标志着视频修复技术从“小模型精修”向“大模型通用生成”的架构范式转移。
痛点深挖:为什么以前的扩散修复模型“又慢又卡”?
目前的 SOTA 视频修复方法(如 VEnhancer, Upscale-A-Video)大多基于预训练的扩散模型。然而,它们面临两个核心瓶颈:
- 全注意力的复杂度负担:Transformer 的全注意力计算量随分辨率呈平方增长。为了处理高分辨率,前人不得不采用 Patch-based Sampling(分块采样),块与块之间需要高达 50% 的重叠才能掩盖接缝,这导致处理一段 3秒的视频往往需要好几分钟。
- 分辨率固着:传统模型对训练时的分辨率有强依赖,换个比例或尺寸,修复质量就会显著下降(Inductive Bias 消失)。
方法论详解:Swin-MMDiT 与 3D 相对位置编码
SeedVR 的核心直觉是:利用大尺寸窗口注意力在降低计算复杂度的同时,保持足够的感受野进行语义对齐。
1. Swin-MMDiT 架构
作者将 SD3 中的 MMDiT 块改造为支持偏移窗口的版本。
- 超大窗口:不同于早期低级视觉任务中微小的 8x8 窗口,SeedVR 在 8 倍压缩的隐空间中使用 64x64 的巨大窗口。
- 3D RoPE:由于偏移窗口在视频边界会导致窗口尺寸不一,作者引入了 3D 旋转位置编码(3D RoPE),确保模型能够感知变长窗口内的时空位置,从而支持任意比例的输入。
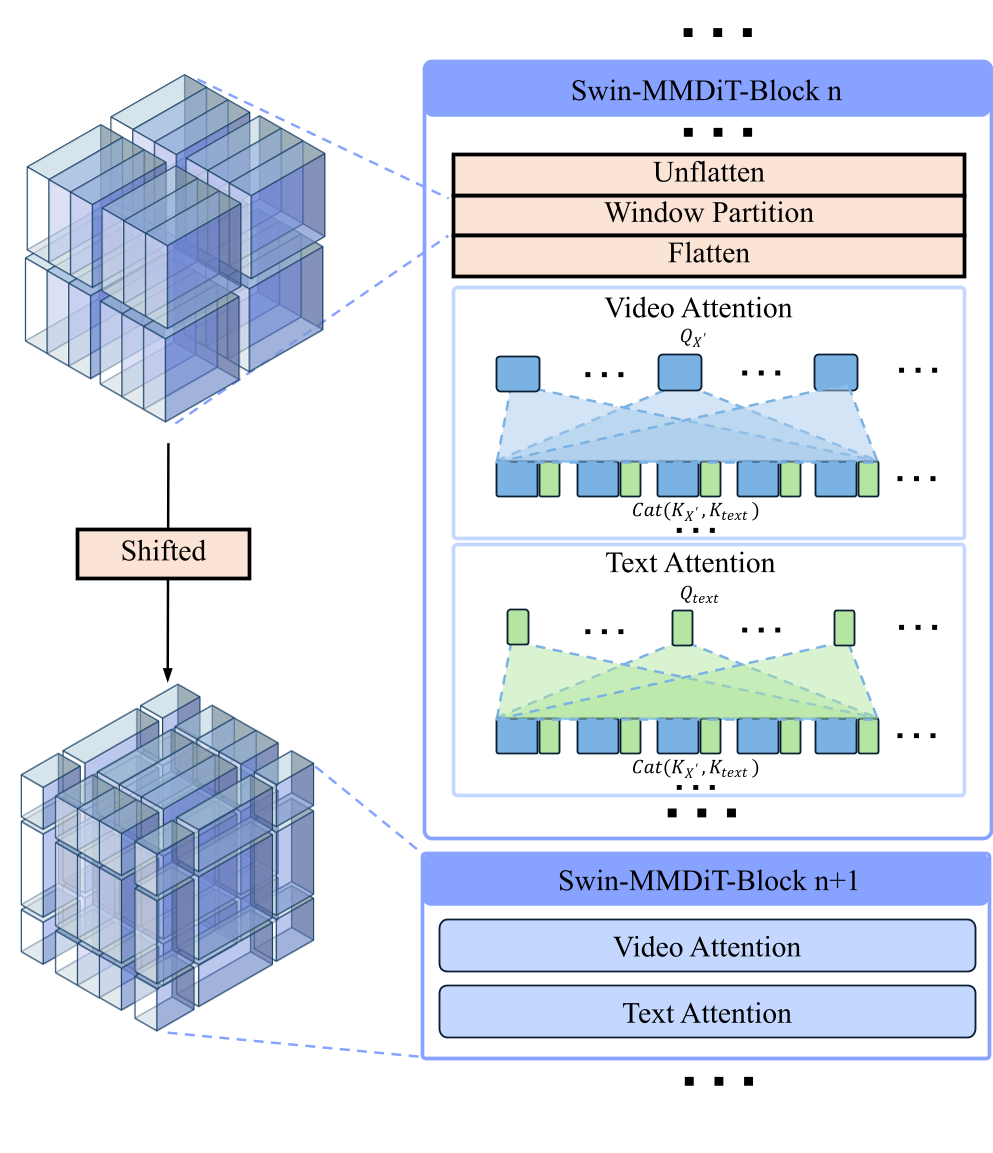 (上图展示了 Swin-MMDiT 的详细设计,注意其如何处理视频特征与文本特征的交互)
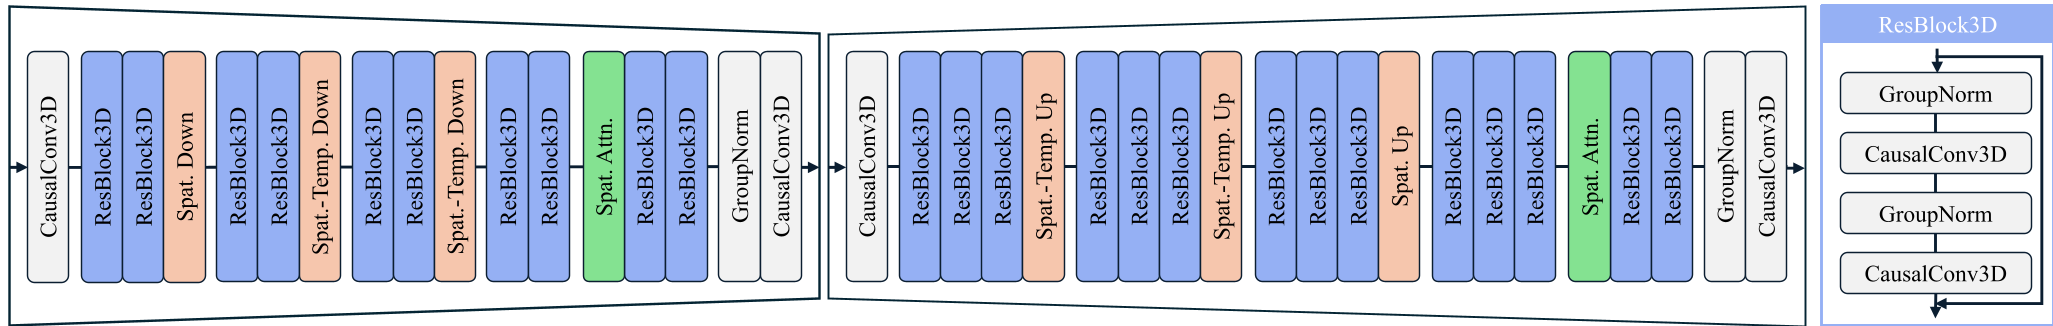
2. 因果视频 VAE (Causal Video VAE)
为了进一步提速,SeedVR 自研了一个强大的 VAE 架构:
- 时间压缩:实现了 4 倍时间维度的压缩,远超传统逐帧编码的效率。
- 因果卷积:支持将长视频切分为片段进行流式处理,保证了长视频修复的时序一致性。
- 高容量: latent channel 提升至 16 层,相比 SD 2.1 的 4 层,重建细节的能力大幅增强。
实验与结果
在实验对比中,SeedVR 表现出了惊人的纹理生成能力。在处理 AIGC 生成的视频(如熊猫、兵马俑细节)时,SeedVR 能够精准恢复鼻头、须发等极细微特征,而对比方法往往会出现“糊成一片”的现象。
性能战绩:
- 推理速度:尽管 SeedVR 拥有 2.48B 参数(是 Upscale-A-Video 的 3.5 倍以上),但推理速度却快了 2 倍,完全得益于窗口注意力对全意力的替代。
- 指标表现:在 YouHQ40 这种高质量视频超分基准上,感知质量指标(DOVER, LPIPS)刷新了记录。
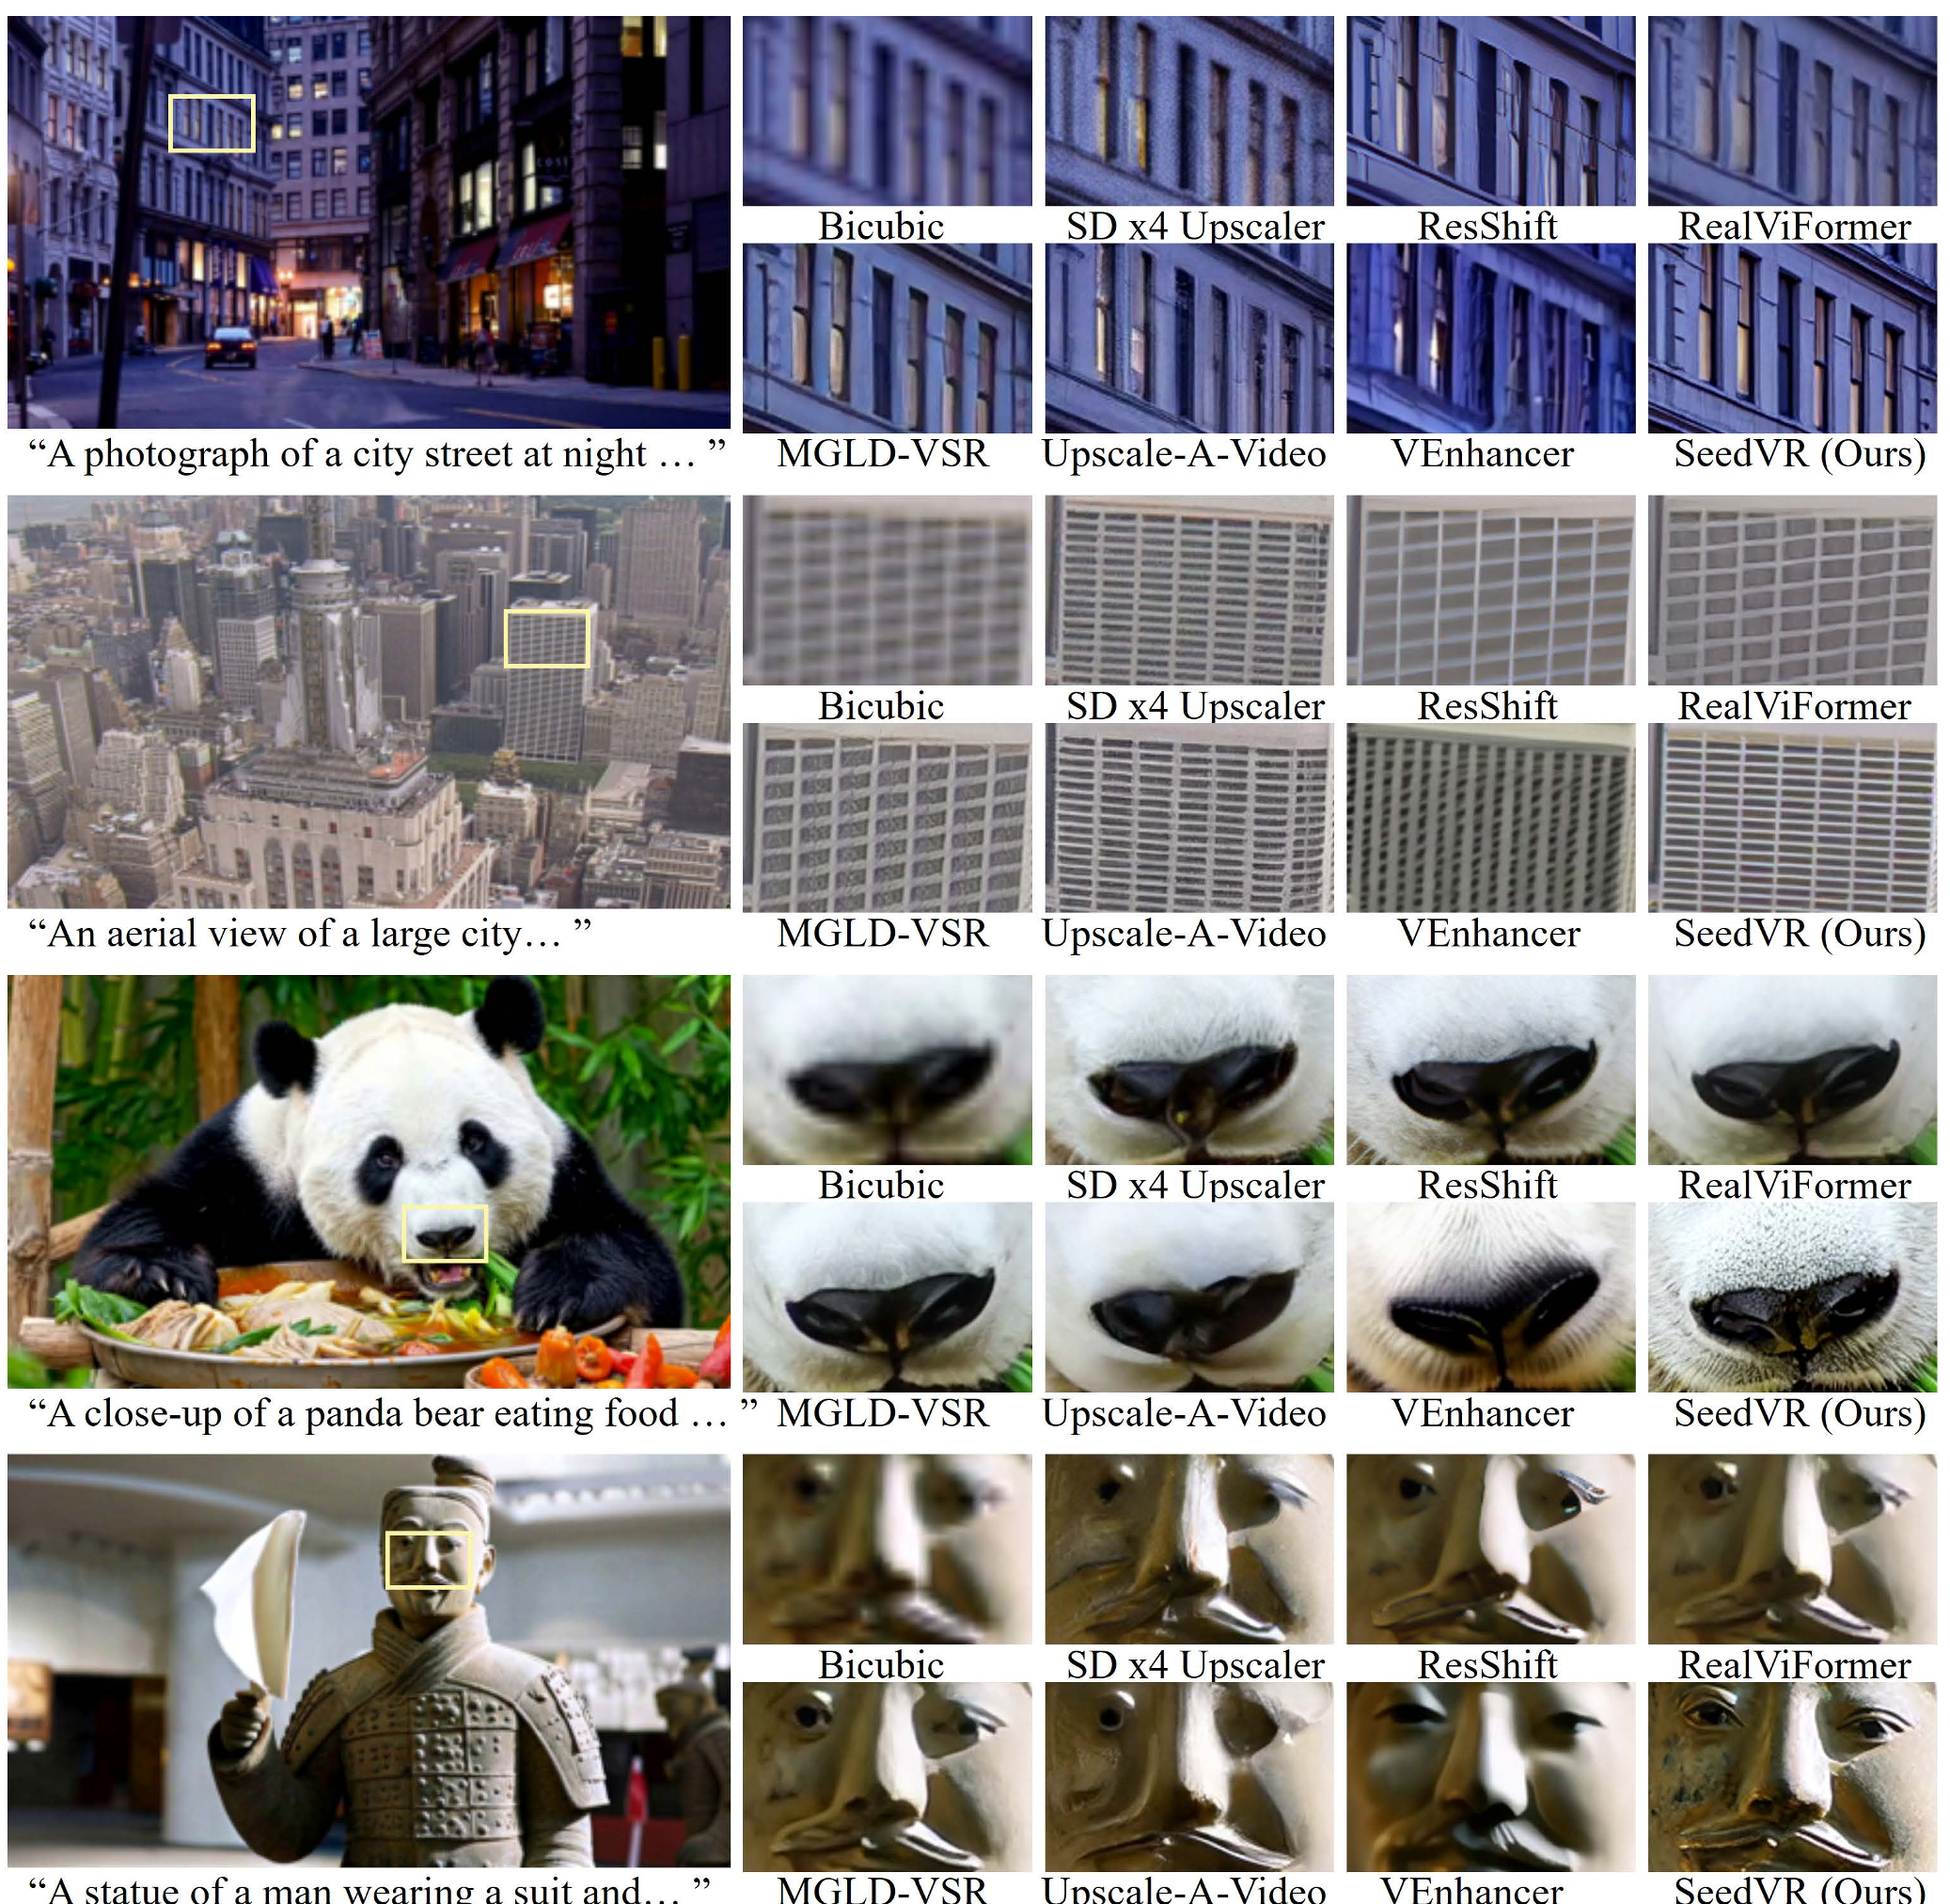 (上图展示了 SeedVR 在处理真实世界退化视频时的纹理恢复优势)
深度洞察与总结
Takeaway:SeedVR 的成功在于通过“窗口化”解决了 DiT 的可扩展性问题。它告诉我们,在底层的视频修复任务中,我们并不一定要追求全局的注意力对齐,局部但足够大的窗口配合强有力的隐空间压缩(VAE),足以应对极其复杂的退化问题。
局限性:虽然生成能力极强,但这也带来了一定的风险——过度生成的细节可能偏离原始真实情况(Fidelity-Realism Trade-off)。未来如何在保持高效率的同时,进一步提升对极端运动场景的鲁棒性,将是该领域值得关注的方向。