
PRISM:看穿大脑——利用结构化文本空间实现高精度 fMRI 视觉重建
Seeing Through the Brain: New Insights from Decoding Visual Stimuli with fMRI
本文提出了 PRISM,一种将 fMRI 信号解码为视觉图像的新型框架。核心方法是利用语言模型的文本空间作为中间表征,并通过对象中心(Object-centric)的扩散模型和属性/关系搜索模块,实现了 SOTA 级别的图像重建性能。
TL;DR
重建人类在大脑中“看到”的画面一直是神经科学与 AI 交叉领域的圣杯。本文提出的 PRISM 模型打破了“视觉重建必须依赖视觉表征”的思维定势。作者发现:fMRI 信号与语言模型的文本空间(Text Space)对齐度最高。通过将 fMRI 映射到结构化的文本描述,并配合对象中心化的扩散模型,PRISM 显著提升了重建图像的语义准确性,LPIPS 降低了 6%。
痛点深挖:为什么你的 AI 会“指猫为虎”?
当前的 fMRI 到图像重建方法主要面临两大瓶颈:
- 潜空间对齐偏差:以往研究多采用 CLIP 的图像嵌入或视觉模型特征。然而,人类对图像的感知往往是高层语义驱动的,而非像素级驱动。
- 属性绑定错误 (Attribute Binding Error):传统的生成模型在解码复杂场景时,常把 A 对象的属性安插在 B 对象身上,或者丢失关键对象。例如,看到“木凳子上的虎斑猫”,模型可能只抓住了“条纹”和“猫科动物”的特征,最后生成了一只“老虎”。
核心洞察:大脑更像是一个“作家”而非“相机”
作者首先进行了一项严谨的对齐实验,使用 CKA(Centered Kernel Alignment)等指标测量 fMRI 与各种模型空间的相似度。结果令人震惊:fMRI 与文本表征(如 T5, LLaMA3)的对齐度显著优于视觉表征(如 ResNet, LDM)。
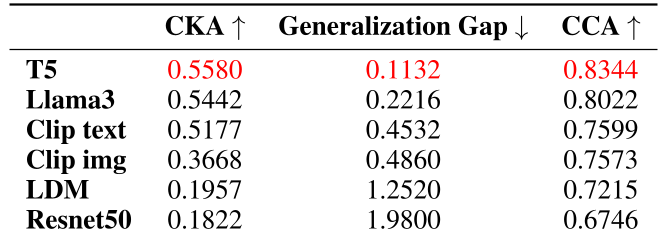
这意味着,与其强制让大脑信号去匹配复杂的像素特征,不如先让大脑信号“说出”它看到了什么。
方法论:PRISM 的结构化解码方案
PRISM 框架由两个核心创新模块组成:
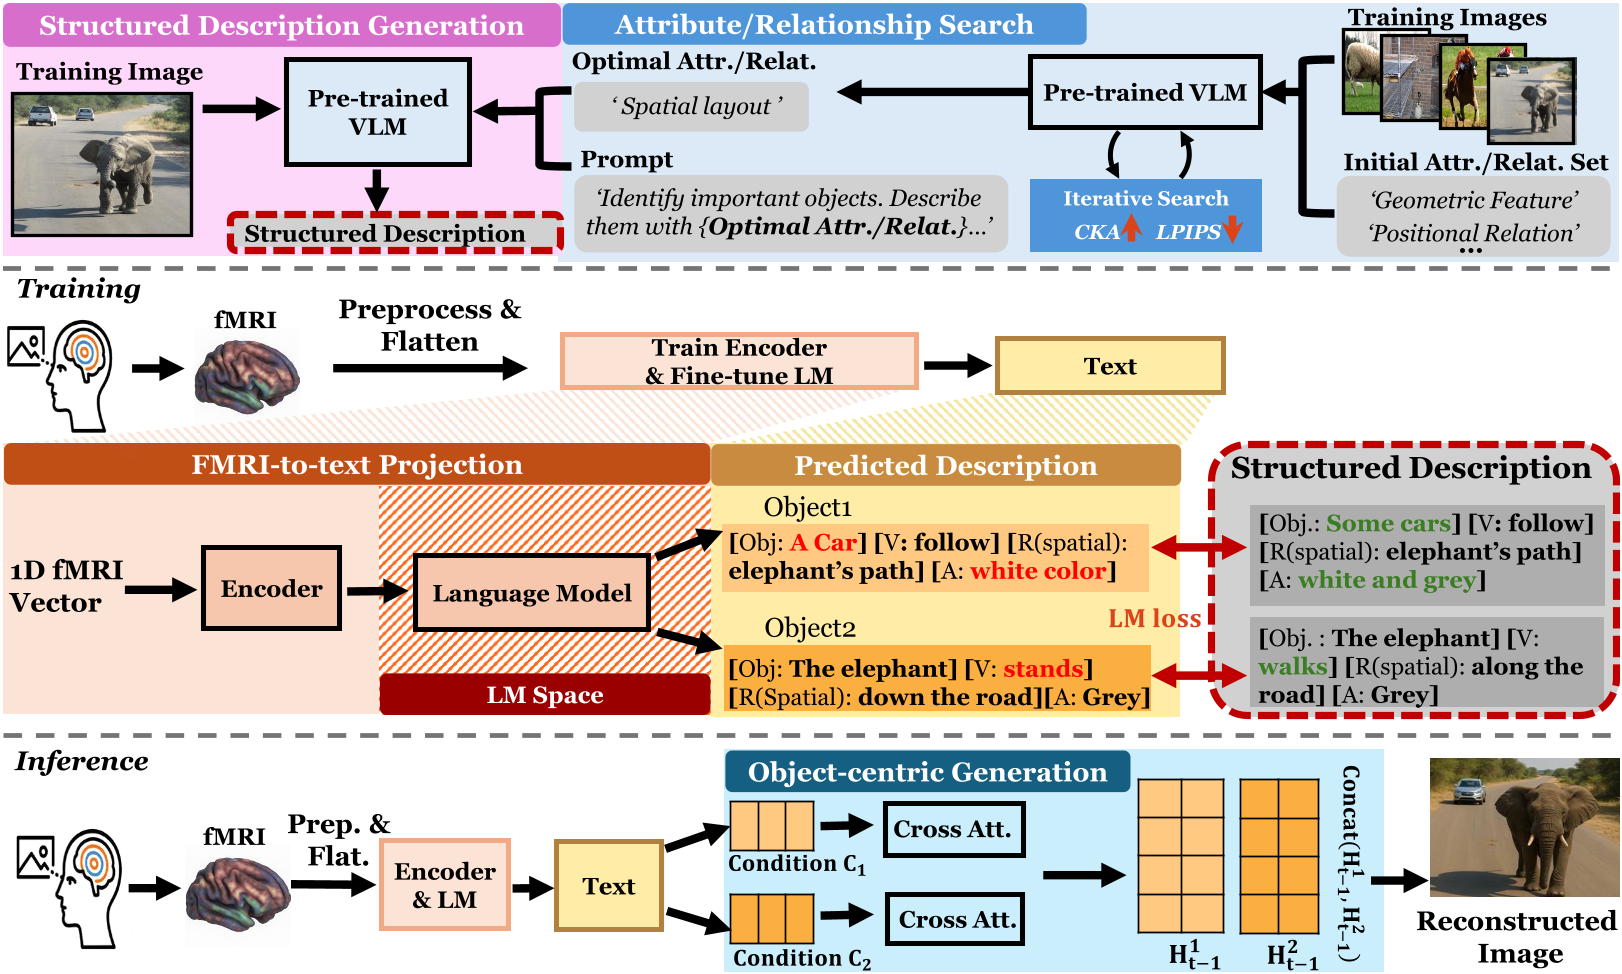
1. 属性/关系搜索模块 (Attribute/Relationship Search)
为了找到最能激发大脑反应的描述方式,作者设计了一个基于 ε-greedy 策略的优化算法。实验发现,**“空间布局”(Spatial Layout)和“相对位置”**是最优的关键词。这意味着人类大脑在处理视觉信息时,对物体在哪、如何排列极为敏感。
2. 对象中心扩散模块 (Object-centric Diffusion)
在推理阶段,PRISM 不再是一次性生成整幅画,而是:
- 从 fMRI 解码出多个对象及其位置(如:左边有一辆车,右边有一头大象)。
- 利用 Cross-Attention 独立生成每个对象的表征。
- 按照预测的空间位置(Spatial Concatenation)进行缝合。
实验战绩:重建质量的新高度
在权威的 NSD 数据集上,PRISM 在所有指标上均碾压了包括 Mindeye2 在内的强力基线。
- 感知损失 (LPIPS):相比最强基线降低了约 6%。
- 语义一致性:重建出的图像甚至能直接喂给大模型(如 Qwen2.5-VL)并准确回答关于图中物体关系的问题,准确率达 60.54%。
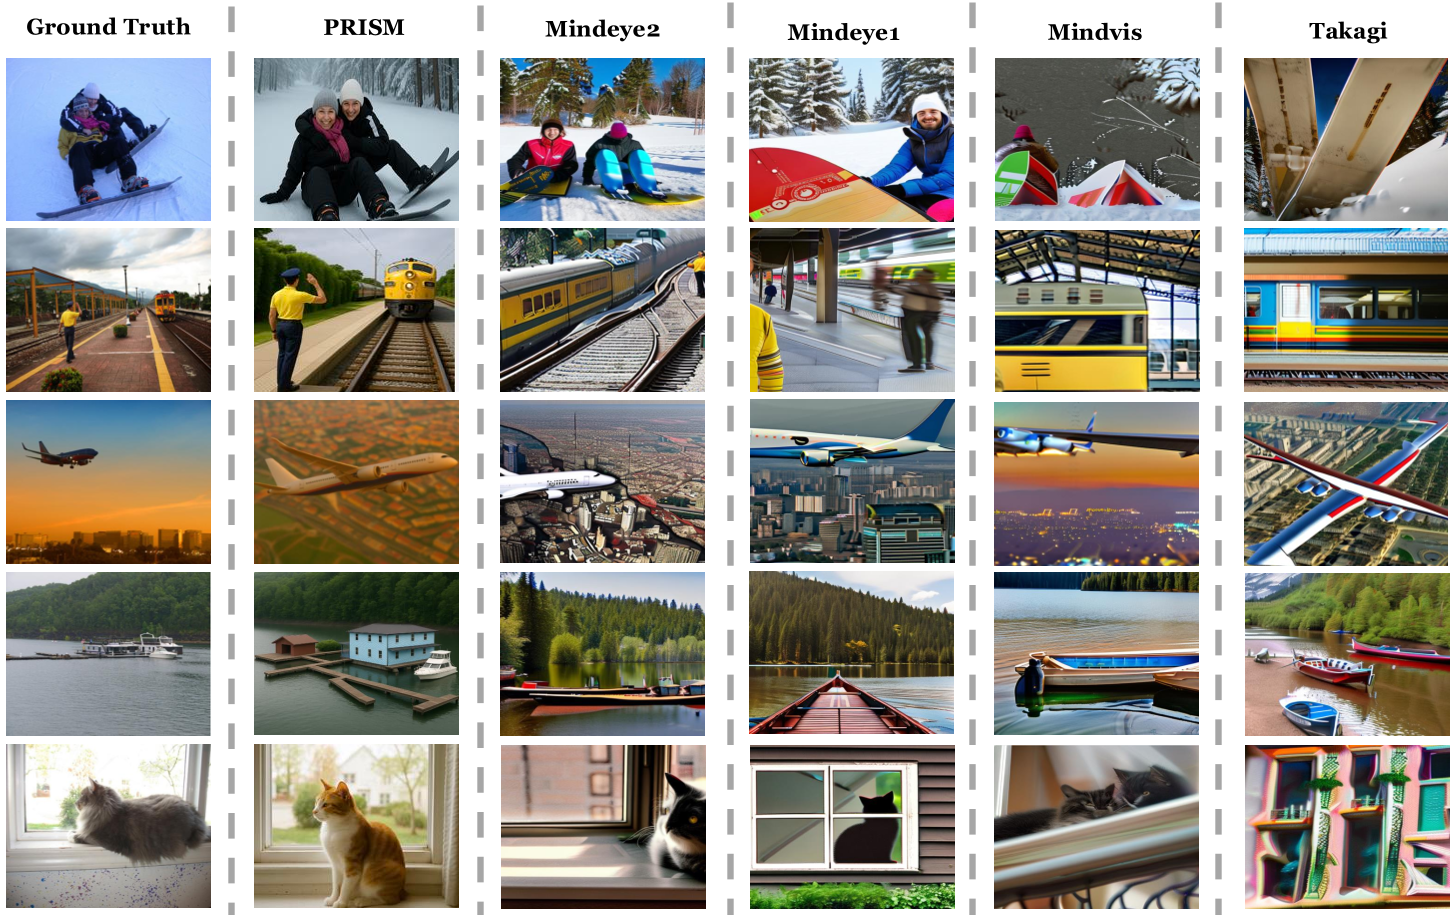
从上图可以看出,PRISM 重建出的物体(如足球运动员、冲浪者)在数量和空间关系上与原图保持了惊人的一致性,而其他方法往往会出现对象缺失或逻辑混乱。
深度思考与总结
PRISM 的成功不仅是工程上的胜利,更是对“大脑如何编码视觉”的一次深刻揭示。它告诉我们,大脑在观察世界时,会自动进行结构化抽象。
局限性:目前模型将每张图的对象数量固定为 2,这在处理极度复杂的场景时(如闹市区)可能会丢失细节。未来的研究可能会引入更加动态的对象计数与描述机制。
总结 (Takeaway):视觉重建的未来可能不在于更强的视觉编码器,而在于如何更好地利用大语言模型的结构化先验来桥接神经活动。