
SeekerGym:当 AI Agent 遇到“我不知道我不知道” —— 检索完整性的深度度量
SeekerGym: A Benchmark for Reliable Information Seeking
本文推出了 SeekerGym,这是一个专门用于评估 AI Agent 信息检索“完整性”(Completeness)和“不确定性量化”(Uncertainty Quantification)能力的基准测试。研究涵盖了 Wikipedia 和 ML Surveys 两个大规模语料库,通过模拟受控的文档检索任务,量化 Agent 在有限查询预算内挖掘所有相关信息的能力。
TL;DR
在 Agent 辅助研究(Deep Research)风靡的今天,我们往往关注 Agent 给出的答案是否准确,却很少问:它找全了吗? 宾夕法尼亚大学与 Google DeepMind 的近期研究提出了 SeekerGym,这是一个揭露 AI Agent 检索“完整性”短板的基准。实验表明,即便是最强的推理模型,在专业文献中也只能找回不到 30% 的核心信息,且普遍对自己的工作进度过度乐观。
背景:被忽视的“静默失败”
假如你让一个调研 Agent 搜索某种药物的副作用。Agent 找到了三篇支持其安全性的文章并回复了你。你可能会觉得任务圆满完成,但如果 Agent 漏掉 了两篇关于严重过敏反应的临床报告呢?
这种信息的缺失并不会触发传统的“幻觉”检测,因为它提供的信息都是真实的,只是不完整。现有的基准测试(如 HotpotQA)侧重于找到那颗“针”,而 SeekerGym 关注的是找回整个“稻草堆”。
核心机制:将文档视为迷宫
SeekerGym 的巧妙之处在于它将“完整性”转化为一个可量化的 POMDP 任务:
- 目标(Ground Truth):选定一篇高质量文档(如 Wikipedia 条目或机器学习综述)。
- 任务:Agent 仅能看到文档的摘要,必须通过生成查询(Queries)来利用向量检索(Embedding Retrieval)“解锁”该文档的所有段落。
- 信念状态(Belief State):系统会记录 Agent 已经看到了哪些部分。
三种“信念”表示法的博弈
研究者探讨了 Agent 应该如何记忆它的探索历史:
- Raw Trajectory(原始轨迹):保留所有搜索历史。实验证明这最糟糕,冗长的上下文会让模型陷入分心,查询多样性迅速下降。
- Deduplicated Trajectory(去重轨迹):仅保留唯一的已检索段落。这种方式更简洁,效果显著提升。
- Oracle Belief(上帝视角):告诉模型还有哪些位置(如第 N 段)是缺失的。这表现最好,证明了结构化信息对引导探索至关重要。
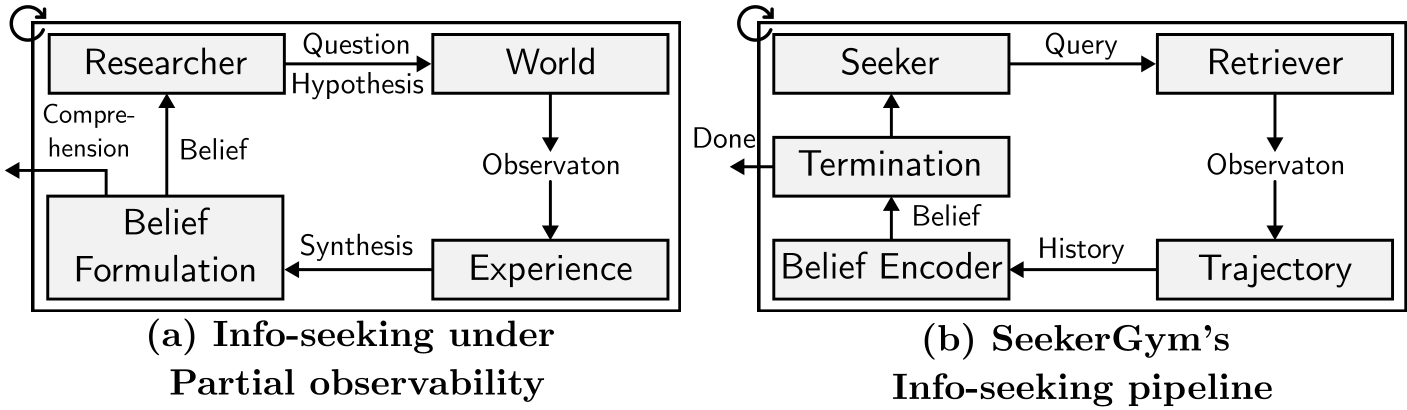 图 1:SeekerGym 的核心反馈环:查询、检索、更新嵌入式信念、判断是否继续。
实验洞察:模型真的知道自己找全了吗?
研究对比了 GPT-4o-mini、Gemini 2.0 Flash 以及多种开源推理模型。
1. 性能上限极低
在维基百科任务中,最优配置的平均完整率不到 43%。这意味着现有的 Agent 在复杂检索任务中极易产生方向性的疲软。
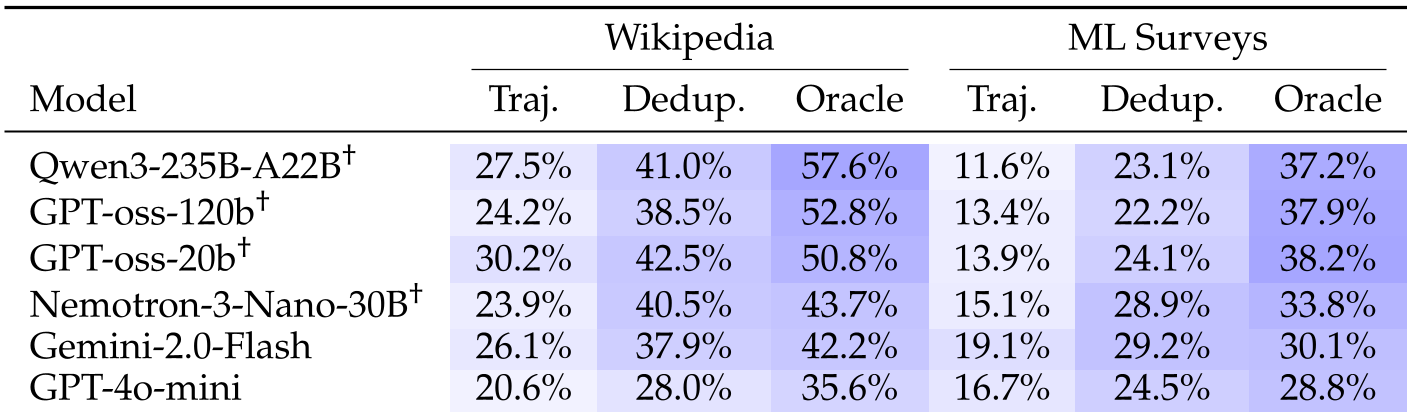 表 1:不同模型在两种数据集下的性能。可以看到模型在专业性极强的 ML Surveys 上表现更差。
2. 蜜性自信(Optimism Bias)
研究者让模型预测自己的“检索进度(0.0-1.0)”。结果很有趣:大多数模型在刚开始检索时,都会大幅高估自己的覆盖率。为了解决这个问题,作者引入了 共形预测(Conformal Prediction),将模型的主观分数转化为具有统计保障的置信区间,从而提供准确的“停机信号”。
深度诊断:为什么 Agent 会停滞不前?
通过消融实验,作者发现:
- 文档特性决定难度:某些主题(如中国历史或生物医学)天生更难被检索,这与文档内部的语义密度有关。
- 去重是刚需:Agent 容易在已知的知识点上打转。如果不对上下文进行去重,模型会因为“见过太多重复信息”而误以为检索已经饱和。
- 推理深度的价值:GPT-oss-20b 虽然参数小,但由于其生成的思维链(CoT)更长,在某些任务上反而超过了 120B 的模型。
结论与启示
SeekerGym 的出现为“深度研究代理解(Deep Research Agents)”指明了方向:
- 别光堆模型规模:优化 Agent 对已检索信息的整理方式(Belief Encoding)比升级模型更有性价比。
- 引入结构化反馈:如果 Agent 能意识到文档的“结构缺口”,其检索效率将迎来质变。
- 外部校准是信任的基石:不能寄希望于 LLM 的主观自信,必须引入像共形预测这样的外部数学框架来约束 Agent 的行为。
总结: 下一代 AI Agent 不仅要会“搜索”,更要学会如何成为一个审慎的“侦探”,时刻审视自己视线外的阴影。