
Seg-Zero:当强化学习遇见图像分割,推理能力的“零样本”涌现
Seg-zero: Reasoning-chain guided segmentation via cognitive reinforcement
本文提出了 Seg-Zero,一种由认知强化驱动的推理分割(Reasoning Segmentation)框架。该框架将推理模型与分割模型解耦,通过纯强化学习(Reward-driven RL)激活了多模态大模型的思维链(CoT)推理能力,在 ReasonSeg 零样本(Zero-shot)测试中比 LISA-7B 提升了 18%。
TL;DR
推理分割(Reasoning Segmentation)要求模型不仅能看清物体,还要能“理解”复杂的指令。传统的监督微调(SFT)虽然有效,但容易让模型变“傻”(遗忘通用能力)且泛化性差。近日,来自香港中文大学和贾佳亚团队的研究者提出了 Seg-Zero,通过纯强化学习(RL)激活了模型的思维链(CoT)推理,不仅在零样本性能上碾压前作,更让视觉分割具备了类似 OpenAI o1 的思考过程。
痛点深挖:为什么 SFT 不是最优解?
在 Reasoning Segmentation 任务中,我们经常会遇到这样的指令:“请分割出图中能提供持续能量的食物”。这需要模型经历:识别物体 -> 检索知识(哪些食物提供慢消化碳水)-> 指令对齐 -> 精确分割。
以往的做法(如 LISA)是喂给模型大量的“指令-掩码”对进行微调。但作者发现,这种 SFT 范式存在两个致命缺陷:
- 由于过度拟合训练集,模型在面对未见过(OOD)的复杂推理场景时,性能会断崖式下跌。
- 微调过程中,LLM 原有的强大视觉问答(VQA)能力会因为参数偏移而迅速衰减(灾难性遗忘)。
方法论详解:解耦架构与认知强化
Seg-Zero 并没有试图在一个模型里解决所有问题,而是采用了推理模型 + 分割模型的解耦方案。
1. 架构解析
- 推理模型 (Reasoning Model):基于 Qwen2.5-VL。通过强化学习,它学会了先在
<think>标签内进行自我纠错和逻辑推导,最后输出目标的 Bounding Box (Bbox) 以及两个关键采样点 (Points)。 - 分割模型 (Segmentation Model):使用冻结的 SAM2。它只负责执行,接收来自推理模型的几何 Prompt,生成高精度的像素掩码。
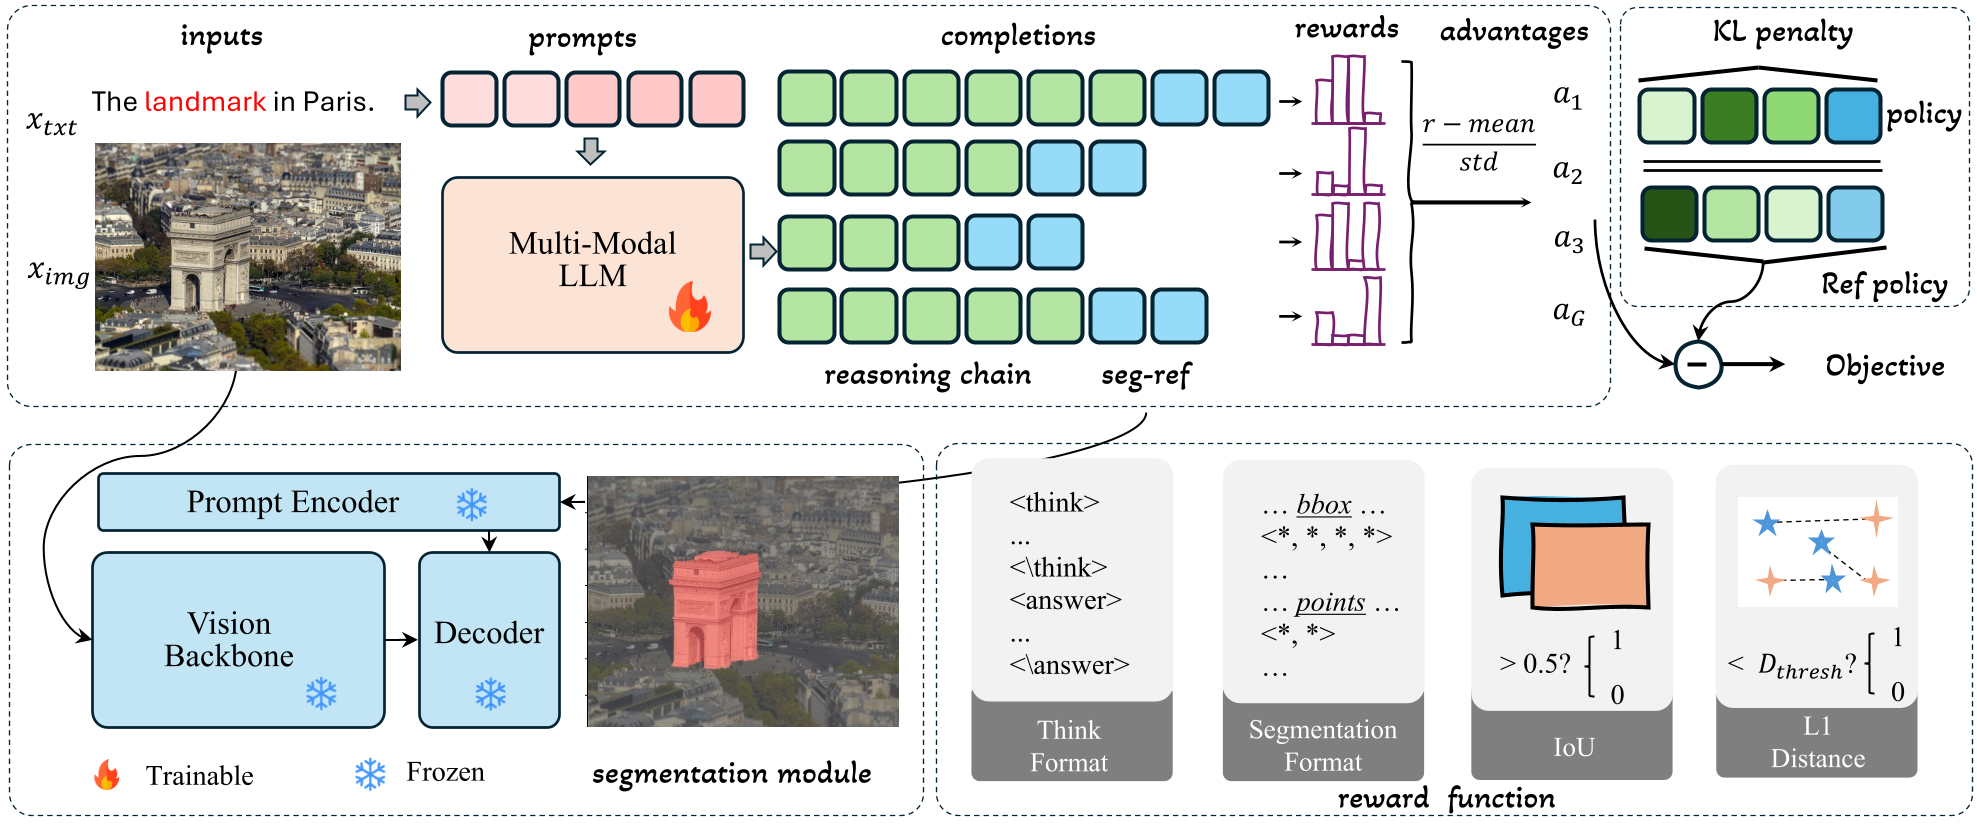 图注:Seg-Zero 的双阶段设计,将复杂的逻辑推导交给了 MLLM,而将精细的像素操作留给成熟的专家模型。
2. 纯 RL 驱动的“自进化”
Seg-Zero 最大的亮点在于其训练不依赖任何标注好的推理过程数据。通过 GRPO (Group Relative Policy Optimization) 算法,团队设计了一套精密的奖励机制:
- 格式奖励:强迫模型必须输出由
<think>和<answer>包裹的内容。 - 精度奖励:根据预测的 Bbox 与真实标签的 IoU 分数、L1 距离来打分。
这种“胡萝卜加大棒”的机制,强制模型在没有任何模板参考的情况下,自发学会了如何拆解复杂问题。
实验与结果:全方位的跨越
实验结果显示,Seg-Zero 在多个维度上展现了压倒性优势。
1. SOTA 性能对比
在 ReasonSeg 这一专门测试推理分割的基准上,Seg-Zero-7B 实现了 57.5 gIoU,远超之前的标杆 LISA-7B。即便与 13B 规模的模型相比,它也展现出了极强的竞争力。
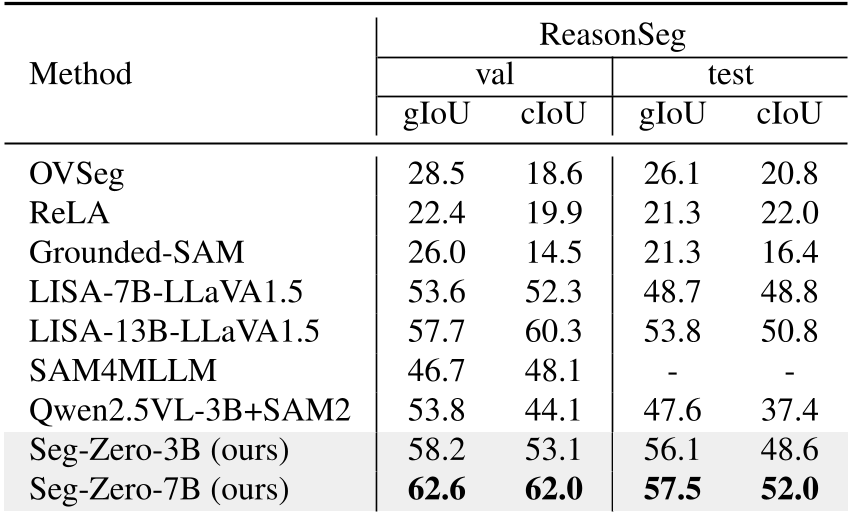
2. SFT vs RL 的本质区别
通过消融实验(Ablation Study),可以看到 SFT 模型在测试 OOD 数据时性能下降明显,而 RL 模型不仅在分割精度上持续提升,还完美保留了 VQA 能力。
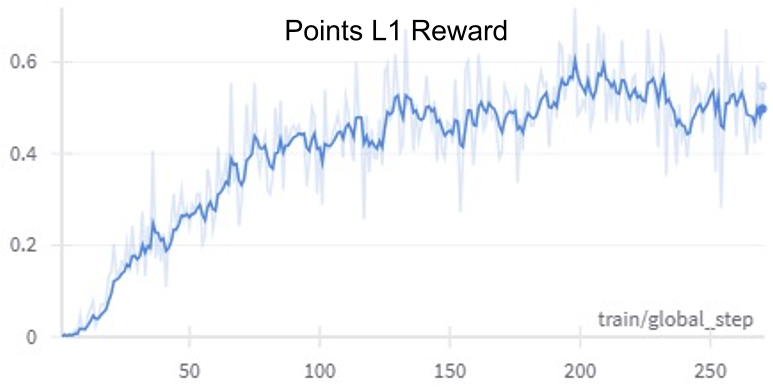 图注:随着训练步数的增加,模型的 Thinking(推理)长度逐渐增加,这证明了模型正在学习如何通过更深入的思考来获得更高奖励。
深度洞察:为什么推理链对分割很重要?
在定性分析中(见下图),当用户问“在公路上行驶且适合睡觉的车”时,Seg-Zero 会在推理链中分析:“房车(RV)有可见的床位,而卡车主要用于货运”。 这种显式化语义冲突消解的能力,是传统端到端分割模型通过像素回归极难习得的。
总结与局限性
Seg-Zero 的成功标志着视觉推理进入了“系统 2”时代——即从直觉式的快速响应转向有思考过程的慢思考。
- Takeaway: 通过纯 RL 唤醒 MLLM 的推理能力,是解决感知任务复杂泛化问题的有效路径。
- 局限性: 目前 Seg-Zero 主要针对单目标推理。对于多目标、实例级推理分割,系统复杂度和奖励设计将面临更大挑战。这正是该领域下一个激动人心的前沿。