
OPSD:让 LLM 成为自己的“名师”——高效推理自蒸馏新范式
Self-Distilled Reasoner: On-Policy Self-Distillation for Large Language Models
本文提出了 On-Policy Self-Distillation (OPSD),一种让单一语言模型同时充当教师和学生角色的自蒸馏算法。该方法通过在教师端引入标准答案(Ground-Truth)作为特权信息(Privileged Information),对学生端生成的推理轨迹进行 Token 级的密集监督,在数学推理任务上达到了与 GRPO 相当的 SOTA 性能。
TL;DR
在大型语言模型(LLM)的后训练阶段,强化学习(RL)虽然强大但采样极其昂贵,而监督微调(SFT)又容易陷入泛化差的泥潭。本文提出的 On-Policy Self-Distillation (OPSD) 另辟蹊径:它让模型在回答问题时,模仿“已经看过标准答案”的那个更聪明的自己。这种方法不仅在数学推理任务上超越了 SFT,还以极高的 Token 效率(1/8 的采样开销)匹配了 GRPO 等主流强化学习算法的效果。
痛点深挖:为什么 RL 和 SFT 还不够好?
在提升模型推理能力(Reasoning)的战场上,目前的“主流玩家”各有短板:
- GRPO (强化学习):虽然能有效利用验证信号,但它是“结果导向”的。如果模型生成的几个方案全错了,梯度信号就会消失;且奖励是序列级的,模型不知道具体哪一步写错了。
- SFT (监督微调):属于 Off-policy 学习,模型只是在死记硬背专家轨迹。当推理时遇到从未见过的偏离路径(Exposure Bias),模型就会崩掉。
- 知识蒸馏:通常需要一个更贵的教师模型(如用 GPT-4o 蒸馏 Llama-3),成本高昂且依然面临分布偏移。
核心机制:OPSD 的“学生-教师”二元性
OPSD 的物理直觉非常接近人类学习:当我们做错题时,看一眼标准答案,然后回过头来思考“如果我当时知道这个答案,我会如何推导”。
1. 特权上下文 (Privileged Context)
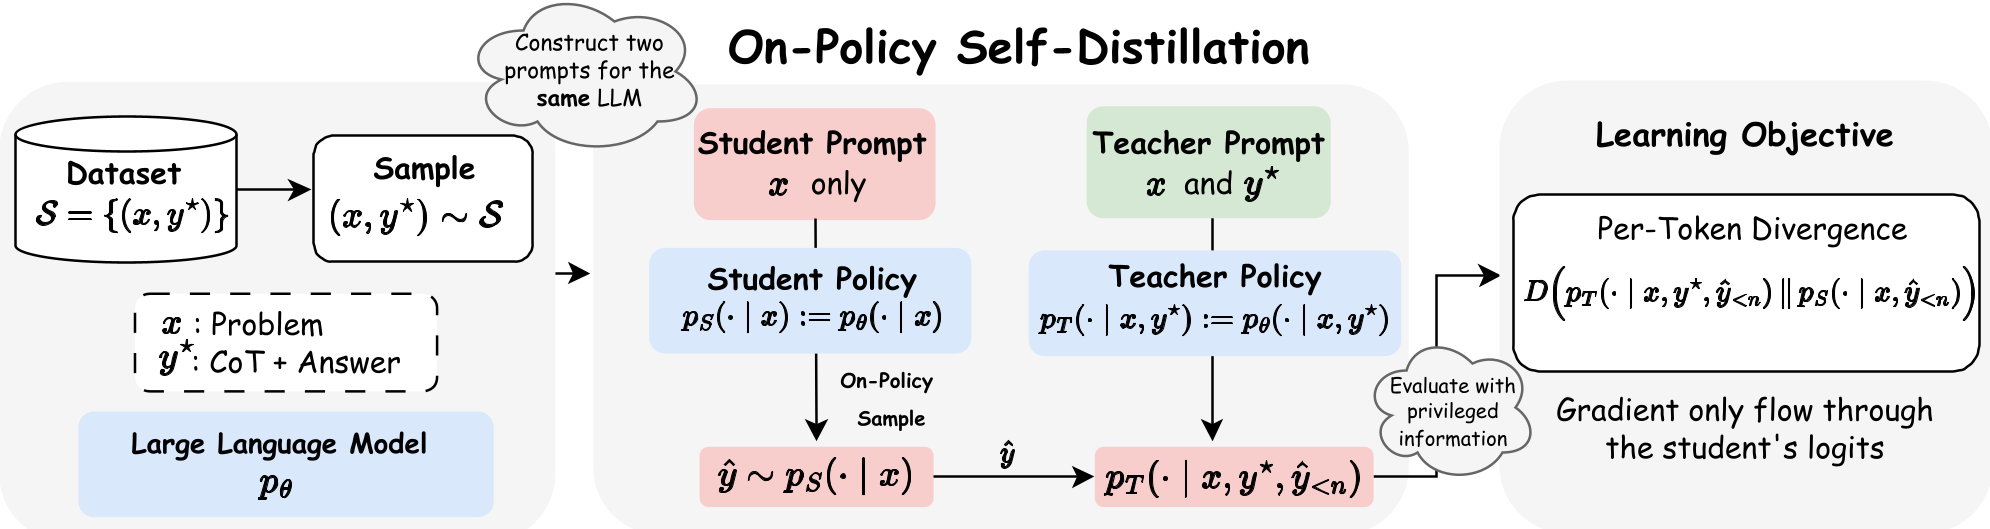
OPSD 并不需要外部模型。它通过 Prompt 工程在同一个模型中分化出两个角色:
- 学生策略 (Student):输入只有问题 。
- 教师策略 (Teacher):输入包括问题 + 标准答案 (作为特权信息)。
2. 在线蒸馏 (On-Policy Distillation)
模型先以“学生”身份生成一段推理轨迹 。然后,利用“教师”身份对这段轨迹中的每一个 Token 进行评估,计算两者的概率分布差异(KL 散度),并以此更新模型参数。
3. 点向 KL 裁剪:过滤“废话”干扰
作者发现一个有趣的现象:在蒸馏过程中,诸如 "However", "So" 之类的语气词(Style Tokens)产生的 KL 散度往往比核心数学逻辑(Math Tokens)大得多。这会干扰模型学习。为此,OPSD 引入了点向 KL 裁剪 (Pointwise KL Clipping),给这些“干扰信号”设限,确保模型聚焦在真正的知识蒸馏上。
实验与结果:小模型也能逆袭
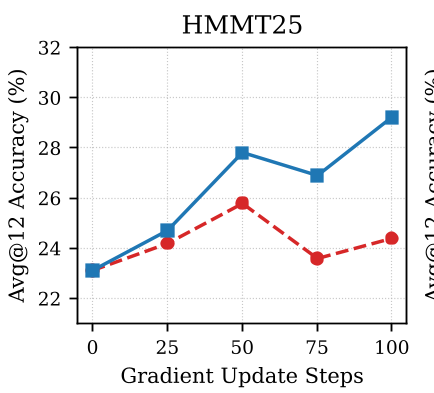
研究人员在 Qwen3 系列模型上进行了广泛实验。结果显示,OPSD 在 AIME 24、AIME 25 等高难度数学竞赛题上表现卓越。
关键洞察:
- 效率极高:OPSD 仅需 100 步训练即可收敛。相比 GRPO 需要 8 个副本并行采用,OPSD 仅需 1 个学生采样,极大地节省了算力。
- 超越 SFT:SFT 有时会导致性能下降(由于答案由于过于精简导致推理量萎缩),而 OPSD 通过 On-policy 采样保持了模型原本的长链推理能力。
深度洞察:为什么这种自蒸馏有效?
OPSD 的成功证明了一个深刻的观点:评估(Evaluation)比生成(Generation)更容易。即使一个模型无法直接解出难题,但给它答案后,它“理性化”(Rationalize)该答案并发现自己推理错误的能力是依然存在的。
通过将这种“后见之明”转化为 Token 级的密集监督信号,模型实际上是在学习一种更稳健的条件概率分布。它消除了强化学习中“稀疏奖励”带来的死角。
总结与展望
OPSD 为 LLM 的高效后训练提供了一条新路径。它不需要复杂的奖励模型(RM),也不需要昂贵的老师,只需要“答案”。
局限性:如果题目难到连带答案的老师也理解不了,这种方法就会失效。因此,未来的方向可能是课程学习(Curriculum Learning)——先从简单题开始自蒸馏,随着模型变强,再挑战更难的题目。
Takeaway: 如果你有带答案的标注数据,别只做 SFT。试试 OPSD,让模型在自己的推理路径上,向带答案的“高手分身”学习。