
SIFT:用成对裁判与 Bradley–Terry 排名压缩自改进编码智能体的搜索成本
Self Improvement via Fast Tree-search
本文提出 SIFT,用成对 LLM 裁判、Bradley–Terry 全局排名和解耦树搜索替代昂贵的逐候选 benchmark 评测。它在 Polyglot 上以 o3-mini 达到 35.1%,同时把单次运行 CPU 小时降到数十到数百量级,并显示发现出的 coding agent harness 可跨模型迁移。
核心速览
SIFT 解决的是一个非常具体的系统瓶颈:递归自改进编码智能体每生成一个候选补丁,传统方法都要重跑一批 benchmark 任务来估计它的效果,而 benchmark 运行时间成为 wall clock 和 API 成本的主要来源。作者引入一个更便宜的中间信号:让裁判模型只比较两个候选 harness 的代码实现,记录成对胜负,再用正则化 Bradley–Terry 模型把这些零散比较聚合成全局强度排名,最后用排名而不是原始分数来采样父节点、决定评测队列优先级。论文在 Polyglot 全量评测上报告 o3-mini 基座达到 35.1%,超过 DGM 在更多节点预算下的 30.7%;在 TerminalBench 上,gpt-5.4-high 裁判帮助搜索找到 36.7% 的全量成绩,而无裁判消融停留在初始 29.2% 附近。
这项工作不是第一个提出 Gödel-machine 风格自改进编码智能体的系统,也不是纯粹刷榜;它的定位更准确说是“样本效率与计算效率修补”。论文建立在 DGM harness 上,核心贡献是把 self-improvement 搜索中的“验证”环节从昂贵 benchmark 拆出来,让 LLM 裁判成为树搜索早期的排序 oracle,再用少量高成本评测做最终确认。
问题与动机
在 DGM、SICA、HGM 这类系统中,循环通常是:编码模型执行下游任务,自我改进模型读取失败日志和代码状态,生成一个 patch,子 agent 再跑评测集,评测结果反馈给下一轮搜索。这个回路看起来自然,但它的信号成本结构很糟糕。完整 benchmark 很可靠,却极其昂贵;论文 intro 提到,已有进化式评测甚至可高达 $22,000 级别,并消耗数千 CPU 小时。小样本评测便宜很多,却因为任务抽样随机性而噪声很大:HGM 动态随机抽样任务时,论文正文观察到拿到更容易任务的节点可能仅凭运气获得高分,导致最终准确率估计失真。
SIFT 的关键直觉是:我们不必在每个节点都问“它现在到底能解决多少题”,而是先问一个更便宜、更可排序的问题:“这个候选 harness 是否比当前已知的强节点更像一个好改动?”这背后的物理含义是,代码质量、工具链稳定性、错误恢复路径等属性往往可以从实现本身被另一个模型相对判断出来。裁判不能替代 benchmark 的最终认证,但可以作为树搜索前的低开销筛选器,把昂贵算力留给少数有希望的分支。
核心机制:把昂贵验证拆成排序与认证两层
昂贵反馈回路的成本结构
先看清 SIFT 想省掉的到底是什么。Table 1 报告了默认设置下每个模块的开销,self-improve expansion 一次约 0.044、0.0042 CPU 小时;而一次 Polyglot-50 full eval 约 $6.0、2.6 CPU 小时。
| 模块 | 模型 | 单次成本(USD) | 单次耗时(CPU 小时) |
|---|---|---|---|
| Self-Improve expansion | gpt-5-mini | 0.12 | 0.186 |
| LLM judge pairwise call | gpt-5.4 | 0.044 | 0.0042 |
| Polyglot-50 full eval | o3-mini | 6.0 | 2.6 |
Table 1 的解读不是“裁判完全免费”,而是裁判与 benchmark 处于两个量级。即便一个节点要做最多 K = 10 次 pairwise 比较,其裁判成本也明显低于一次完整 Polyglot-50 评测。这决定了 SIFT 的设计边界:裁判适合作为频繁调用的相对排序信号,不适合作为最终性能认证。若把所有节点都送进 full eval,搜索树会迅速被 CPU 小时和 API 费用压垮;若完全不评测,又无法知道真实任务表现。因此论文选择了“便宜排序指导扩展、昂贵评测保留给候选前沿”的分层策略。
成对裁判、Bradley–Terry 聚合与 rank-based 采样
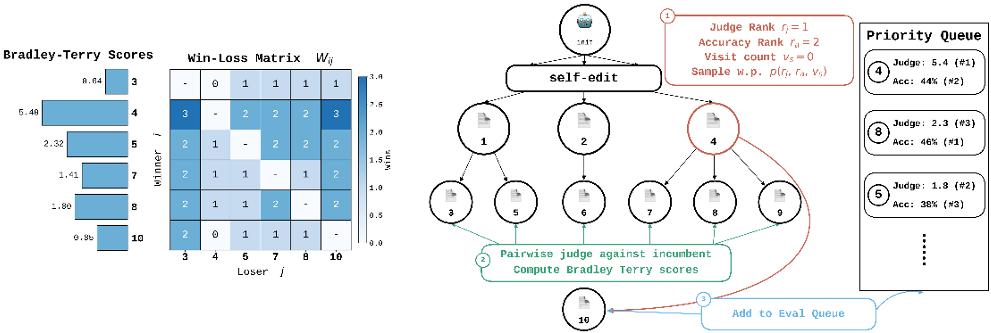
SIFT 的裁判从不看具体 benchmark 任务,也不看任务结果,而是比较两个候选 agent harness。每次比较只产出一个胜或负。论文采用 Bradley–Terry 模型把这些胜负记录变成全局强度参数。每个节点 i 有潜在正强度 ,节点 i 胜过节点 j 的概率写作:
其中 表示裁判把节点 i 偏好到节点 j 的次数, 是需要从这些次数中拟合出来的潜在强度, 是成对偏好概率。相比简单统计“每个节点赢了多少场”,Bradley–Terry 的优势在于它把所有胜负联合解释成一套全局强度:一个新节点即使只和 top 10 强节点比较,也能通过“它战胜谁、输给谁、对手又战胜谁”的传递结构获得排名位置。若把 视为常数,式子会退化成单节点胜率;但真实树搜索中新节点比较稀疏、旧节点胜负不一致,单独胜率会不稳定。正则化和归一化让新节点不会因为只赢了几次就获得无限高分,也避免了绝对尺度影响后续采样。
在得到 BT score 后,SIFT 不直接使用分数,而是使用 rank。父节点采样规则是:
这里 是节点 i 按 BT strength 的排名, 是节点 i 按评测准确率的排名, 是节点 i 被选为父节点的访问次数,、、 分别控制裁判排名、准确率排名和探索惩罚的权重。相比只按 accuracy rank 贪心扩展,这个式子把“看起来好的代码”和“已经跑出来的分数”合在一起;相比只按 BT rank 扩展,它又保留了 benchmark 信号。若 ,访问次数惩罚消失,树容易反复扩展同一条高分谱系,论文附录 B.1 报告这会把 o3-mini Polyglot 结果从 35.1% 降到 30.1%。反过来,如果 或 很大,搜索会过度偏向单种信号,容易在噪声排名或噪声准确率上押注。SIFT 的关键不是发明复杂采样器,而是把相对排序放进指数衰减里:排名靠前获得强偏置,但访问次数会温和压制重复分支。
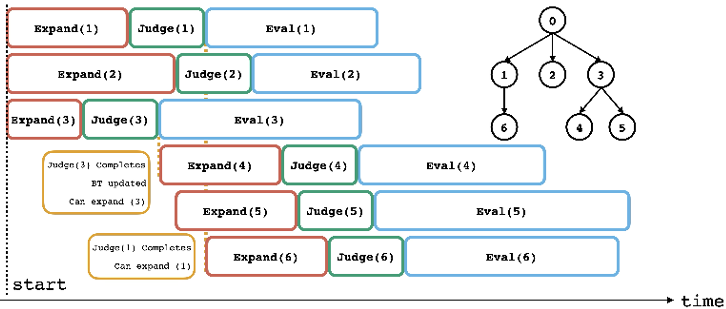
解耦流水线进一步把采样公式变成实际工程收益。Algorithm 1 与 Figure 2 说明:master loop 非阻塞地收集已完成的 expansion,先跑容易 gate 过滤坏补丁,再选择 top K 强节点进行 pairwise judge,重拟合 BT score,然后按 把节点放入评测优先队列。未评测节点暂时继承父节点 accuracy,这样裁判可以立即影响下一步扩展,而不必等待 Polyglot-50 或 TerminalBench 跑完。这里的本质设计是 speculative exploration:用便宜但带噪声的相对信号提前押注分支,用昂贵但可靠的 benchmark 做后续校正。
理论依据:稀疏比较下为什么 BT rank 仍可指导搜索
论文附录 B.4 给出三类支撑。第一类是 well-posedness。由于每个新节点只与少量 incumbent 比较,比较图很稀疏;若一个节点只有胜没有负,未正则化的 BT 可能给出不稳定或过大的强度。SIFT 使用平滑目标:
其中 是节点 i 的对数强度, 是为每一对节点添加的伪计数, 是实际胜负计数, 是正则化对数似然。相比标准极大似然,这个目标给每对节点都加入少量双向虚拟胜负,从而防止稀疏比较图导致极端估计。若 ,新节点只和少数强节点比较时,可能因为几场胜利被推到不可靠高位;若 过大,则真实胜负会被 prior 压平,裁判排名变弱。论文没有给出 的具体消融值,这是一个明显证据缺口。
第二类是 top-K recovery 的直觉。论文引用随机设计下的 top-K ranking 结果,说明当比较图足够连通、观测误差足够小、真实 top-K 边界存在间隔时,BT 估计能把真正最强的节点集合排在前面。其核心条件是:
其中 是真实排序中第 K 名与第 K 加 1 名之间的强度间隔, 是候选节点数, 是比较图连通概率, 是每条边的比较次数, 是随强度范围变化的常数。这个式子说明裁判不需要绝对校准,只需要足够可靠的相对区分能力:如果强节点和弱节点之间的质量差距大于统计误差,BT rank 就能恢复 frontier。论文正文也强调,SIFT 只使用 ranks,而不是 raw scores,这降低了对绝对尺度敏感的噪声。
第三类是 rank-based parent sampling 的放大效应。若 archive 中排名 最好,采样概率为 ,则 top M 节点获得的总概率为:
相比均匀采样给 top M 的概率 ,指数 rank 采样会把搜索压力集中到裁判认为最强的少数节点上。访问次数项不会允许永久 starve 其他节点,因为论文 Proposition 2 证明固定 archive 下所有节点仍会被无限次采样;它只是让高分节点不会无限制霸占预算。这个机制与 bandit 思路类似:排名负责 exploitation,访问次数负责 exploration。
实验与证据
Polyglot 主结果:更少扩展步数换来更高准确率
原文 Polyglot 全量评测主结果表报告了多组方法。论文正文 intro 将该主结果指向 Table 2,但 Markdown 中表号存在 OCR 错位;以下数字直接取自原文表。
| 方法 | 编码模型 | 裁判模型 | Polyglot 准确率 |
|---|---|---|---|
| Base Agent | Qwen3-Coder-30B | None | 20.0% |
| SICA | Qwen3-Coder-30B | None | 25.1% |
| DGM | Qwen3-Coder-30B | None | 27.1% |
| HGM | Qwen3-Coder-30B | None | 30.5% |
| SIFT | Qwen3-Coder-30B | Qwen3-Coder-480B | 31.1% |
| SIFT | Qwen3-Coder-30B | gpt-5.4 | 32.0% |
| Base Agent | o3-mini | None | 14.2% |
| DGM | o3-mini | None | 30.7% |
| SIFT without judge | o3-mini | None | 29.8% |
| SIFT | o3-mini | gpt-5.4 | 35.1% |
| SIFT | o3-mini | gpt-5-mini | 31.6% |
这张表最关键的对照是 o3-mini 配置:DGM 在 80 个节点的搜索后得到 30.7%,而 SIFT 的 20 或 30 步搜索达到 35.1%。论文同时报告 o3-mini 重复三次落在 [32.0%, 35.6%],说明提升不是单次运气。Qwen3 路线上,SIFT 使用 gpt-5.4 裁判达到 32.0%,超过 HGM 的 30.5% 和 DGM 的 27.1%。值得注意的是,no-judge SIFT 用 o3-mini 只有 29.8%,低于完整 SIFT 的 35.1%,也接近 DGM 水平;这提示速度优势主要来自 disaggregation,而性能增益主要来自裁判排序与采样策略的结合。
论文资源表报告三种 SIFT 配置的单次运行成本:
| 配置 | Expansion steps | API cost | 其中裁判成本 | CPU hours | Wall clock |
|---|---|---|---|---|---|
| Qwen3-30B / Qwen3-480B judge | 30 | $34.3 | $4.1 | 224 | 6.7 h |
| Qwen3-30B / gpt-5.4 judge | 30 | $33.7 | $9.7 | 188 | 6.8 h |
| o3-mini / gpt-5.4 judge | 20 | $86.8 | $15.7 | 59 | 2.1 h |
资源表的含义是:SIFT 不是简单地用便宜裁判换最终质量,而是在扩展预算很小(20 或 30 步)的前提下完成更强搜索。论文正文称 Qwen3 路线约 224 CPU hours,并强调这约为 DGM baseline 的十分之一;HGM 异步树搜索则报告 347 CPU hours 达到 30.5%。o3-mini 配置存在一处原文不一致:intro 文本称低于 50 CPU hours、约 5 小时,而资源表给出 59 CPU hours、2.1 小时、$86.8 API cost。这不影响“显著节省”的方向性判断,但说明论文的某些 headline 数字可能来自不同 run 或不同 budget 设置。
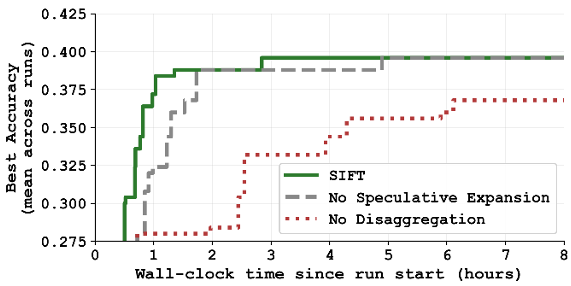
Figure 6 支持了系统层面的归因:异步 pipeline 是速度收益的主要来源,而允许裁判驱动 speculative expansion 则在并行化之上进一步提升了单位时间内达到的准确率。也就是说,SIFT 的加速不是只来自“少评测”,还来自“不让慢评测阻塞搜索树生长”。
TerminalBench:裁判更像排序 oracle,而不是准确率代理
TerminalBench 实验揭示了裁判信号的真正角色。Table 4 报告搜索集分数和三次全量重复平均分:初始 agent 在 50-task search subset 上是 14/50,全量 89-task repeated mean 为 26.0/89,即 29.2%;SIFT judge rank 1 节点搜索集只有 18/50,但全量 repeated mean 达到 32.7/89,即 36.7%;SIFT accuracy rank 1 搜索集为 19/50,但全量 repeated mean 只有 25.0/89,即 28.1%;no-judge ablation 的 accuracy rank 1 搜索集也是 19/50,全量 repeated mean 为 26.0/89,即 29.2%。
这组数字非常反直觉:搜索阶段最高 accuracy 的节点并不是最终最好节点,甚至低于初始 agent;而裁判排名第一的节点虽然搜索集分数更低,却在全量重复评测中最强。Table 5 的裁判诊断进一步解释了这个现象:
| 裁判 | Best agent found | Gain | Recall@5 | Spearman rho | Pairwise top-5 agreement |
|---|---|---|---|---|---|
| gpt-5.4-high | 36.7% | +7.5 | 4/5 | +0.72 | 1.00 |
| gpt-5 | 34.5% | +5.3 | 3/5 | +0.71 | 0.50 |
| None | 29.2% | +0.0 | — | — | — |
Table 5 表明,即使换成更弱的 gpt-5 裁判,BT rank 与全量 benchmark score 的总体相关性仍接近 gpt-5.4-high,Spearman rho 分别为 +0.72 和 +0.71;但在 top-5 内部,弱裁判与真实顺序的一致性只有 0.50,强裁判为 1.00。这个差异说明:裁判的早期价值在于把搜索推向有希望区域,而最终“哪个才是最强”的选择仍然需要强裁判或更多验证。论文也承认,裁判最有用的是 ranking signal,不是 benchmark accuracy surrogate。
裁判输入格式:full files 比 diff chain 更值得付钱
Table 6 对裁判输入做了消融。这里的相关性是 BT judge score 与 realized Polyglot accuracy 之间的 Pearson 和 Spearman 相关,来自 Qwen3-Coder-30B 树搜索中的 50 个非 root 节点。
| 裁判输入变体 | Pearson r | Spearman rho | 每次比较成本 |
|---|---|---|---|
| Diffs | +0.14 | +0.40 | $0.0076 |
| Diffs + swap-order | +0.11 | +0.43 | $0.014 |
| Full files | +0.45 | +0.68 | $0.011 |
| Full files + swap-order | +0.37 | +0.67 | $0.021 |
这张表的设计意义很大。SIFT 不用绝对分数,而用 rank,因此校准不重要,排序相关性才重要。Diff 形式便宜但弱,Spearman 约 +0.40;full files 将相关提升到 +0.68,而成本 $0.011 仍远低于一次 full eval。swap-order 只能略微改善对称性,full files + swap-order 的相关性几乎没有提升却成本翻倍,所以论文最终选择 full files 不加 swap。这背后的判断是:裁判更需要看见补丁完成后的最终可运行代码,而不是从一系列 diff 重建 agent 行为。这个结论对工程实践很有用:很多 agent 优化 pipeline 会习惯性只传 diff,但 Table 6 显示这会牺牲相当一部分 ranking signal。
证据质量与局限
论文的主要结论是在严格预算下成立的:Polyglot 搜索使用 DGM 协议中的 50-task subset 作为中间信号,full 225-task 只用于 held-out final evaluation;扩展步数限制在 20 或 30;DGM 和 HGM baseline 按 Wang et al. 的 800 evaluation 预算约束比较。证据并不单薄,因为作者使用了多模型、多 benchmark:Polyglot 有 Qwen3-30B 和 o3-mini 两条路线,TerminalBench 有 judge、no-judge 和不同裁判强度比较,SWE-60 appendix 也有 Table 7 的重复评测,judge rank 1 节点达到 53.3% search eval、50.4% repeated mean,judge rank 2 节点为 55.0% search eval、53.8% repeated mean,无裁判最好节点为 51.7% search eval、44.6% repeated mean。
不过,SIFT 的可靠性边界也很清楚。第一,最终 agent 仍需 benchmark validation,裁判只是排序器;论文用 TerminalBench Table 5 显示裁判与全量分数正相关,但没有提供跨任务领域的足够多证据。第二,最强实验的裁判模型比 coding backbone 更强,例如 gpt-5.4-high 或 gpt-5.4 用于比较,而 coding model 可能是 gpt-5-mini 或 o3-mini;论文自己在 limitations 中也承认这不是纯粹的 self-judging。第三,BT 把每个节点压成一个标量强度,可能掩盖任务特异性 tradeoff,一个改善长程调试的 patch 可能伤害语法修复类任务。第四,、、top 10 comparison target selection 等关键超参在论文中未做充分敏感性分析,尤其 只被描述为伪计数,没有表格化消融。
深度洞察与总结
SIFT 最值得记住的不是“它跑了多少步”或“多少 CPU hours”,而是它对递归自改进回路的一个重新定义:生成候选补丁不是瓶颈,决定哪个补丁值得继续投资才是瓶颈。传统 benchmark 评测是绝对量尺,昂贵且慢;pairwise LLM judge 是相对量尺,便宜且快。SIFT 把绝对评测推迟到关键节点,把相对判断前移到搜索内部,使树搜索能在评测运行完成前继续扩展。
从算法角度,Bradley–Terry + rank-based sampling 的选择很聪明。它绕开了 LLM 裁判绝对分数不稳定、rubric calibration 困难的问题,只要求裁判提供“谁更像更好实现”的相对偏好。排名本身具有抗尺度、抗分布漂移的性质,这也符合 agent harness 搜索这种动态 archive 场景。从系统角度,disaggregation 把扩展和评测从串行走廊变成异步流水线;从评测角度,full-file judge input 说明代码评审式比较如果只看 diff,会损失最终行为上下文。三者合起来,才把“便宜的信号”变成“能改变搜索路径的信号”。
这项工作对后续工程实践有明确启示:如果你正在做 self-improving agent、workflow search 或 agentic harness 优化,不要一上来就让每个候选都跑完整 benchmark。应先设计一个便宜、稳定、可排序的中间信号,并用它指导 tree search 的预算分配。SIFT 给出的答案是一层 pairwise judge、一层 BT aggregation、一层异步 pipeline。它不是完美解,尤其在最终选择仍需强裁判或重复评测时;但它显著降低了递归自改进进入研究和生产环境的门槛。