
别再为“数学噪声”买单:Semantic Recall 开启向量搜索效率新维度
Semantic Recall for Vector Search
本文提出了 Semantic Recall(语义召回率),这是一种评估近似最近邻搜索(ANNS)质量的新型度量标准。该方法通过引入 LLM 或人工评估,仅针对 ground truth 中具有语义相关性的项进行统计,在 MSMARCO 等数据集上证明了其比传统召回率更贴近用户真实体验。
TL;DR
在向量搜索(Vector Search)领域,我们长期信任的 Recall(召回率) 指标可能正在“欺骗”我们。传统的召回率强制算法去匹配数学上的最近邻,即使那些点完全是语义无关的噪声。本文介绍的 Semantic Recall 通过重新定义“什么是成功的检索”,不仅提升了评估的准确性,更通过跳出“精确噪音”的陷阱,实现了高达 35% 的计算成本优化。
背景定位:这是针对近似最近邻搜索(ANNS)评估体系的一次重要修补,属于工业界与学术界交叉的“评价标准重构”工作。
痛点深挖:召回率的“数学陷阱”
目前的 ANNS 算法(如 HNSW, ScaNN)通常以 Recall@k 作为金标准。只要算法没能找回 brute-force 算出的 top-k 邻居,就会被判定为性能下降。
然而,作者发现了一个深刻的直觉:向量空间中的距离最近并不等同于语义相关。
- 数学噪声:在大规模数据集中,许多向量由于量化误差或 embedding 模型本身的局限,挤在了查询向量周围,但它们与查询主题毫无关系。
- 代价昂贵:为了找回这些位置尴尬、分布密集的“噪声点”,ANNS 算法必须增加探测深度(probing),消耗大量的 CPU 和内存访问。
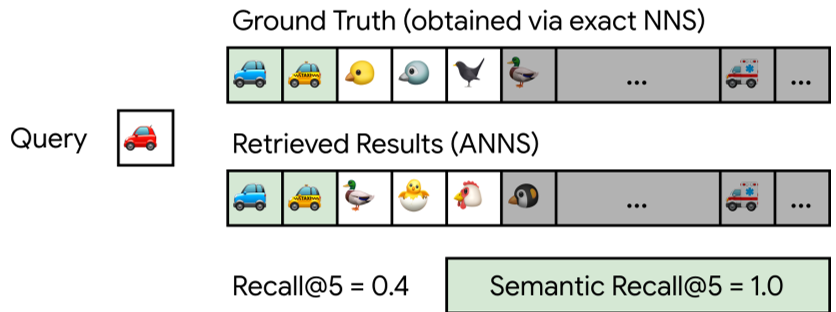 如图所示,传统的召回率会因为没搜到“救护车图标”左边的无关点而扣分,而 Semantic Recall 只关注那些真正相关的绿色点。
方法论:从硬匹配到语义对齐
作者提出了两套方案来解决评估失真的问题:
1. Semantic Recall (srecall)
核心公式:srecall = |R ∩ SN| / |SN|
其中 SN (Semantic Neighbors) 是 ground truth 中经过外部评判(如 Gemini 2.5 或人工)后确认相关的子集。
- Insight:与其让算法追逐 100 个数学近邻,不如只让它追逐其中那 20 个真正有意义的邻居。
2. Tolerant Recall (trecall)
如果每次评估都要调 LLM 太贵怎么办?作者提出了容差召回率。
- 逻辑:如果检索出的结果评分(Score)与 ground truth 中的点非常接近(例如在 1% 的容差内),就视其有效。这有效地宽容了由于向量量化(Quantization)导致的微小排序抖动。
实验战绩:更低成本,更高质量
作者在 MSMARCO(883万文档)和 MIRACL(泰语数据集)上进行了验证,结果令人振奋:
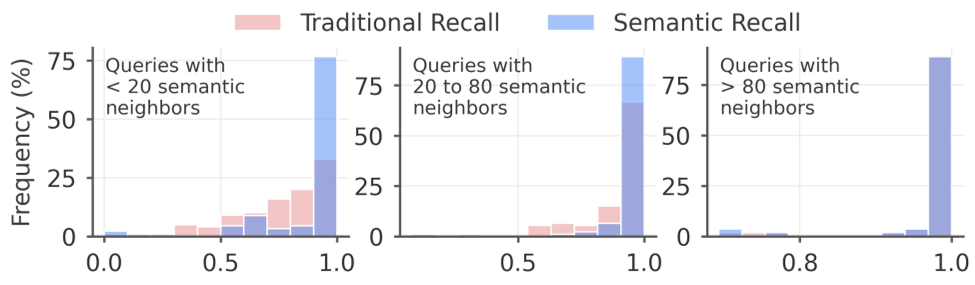
- 评估修正:在传统召回率看起来表现糟糕(约 0.76)的查询组中,Semantic Recall 显示其真实语义质量其实已经达到了 0.90 左右。
- 性能飞跃:当研究者使用变量优化工具(如 Google Vizier)以 Tolerant Recall 为目标重新调优 ScaNN 引擎时,在维持相同质量的前提下,搜索成本降低了 25%-35%。
 表 3 展示了在不同查询类型下,Semantic Recall 始终能提供更稳健、更符合逻辑的评估分值。
深度洞察:效率挖掘的新源泉
这篇论文给工业界传递了一个非常清晰的信号:过度优化传统 Recall 是边际效用极低的。
当 Recall 超过 95% 后,每一分钱的提升都需要翻倍的计算资源(见下图指数级上升的曲线)。过去我们认为这是“为了精确必须付出的代价”,而现在我们知道,这部分代价大半是花在了追逐“无意义的噪声”上。
 曲线图揭示了真相:在曲线的高端,通过切换到 Semantic/Tolerant 指标,我们可以往左“平移”一点,从而节省巨大的计算开销。
总结与局限
Semantic Recall 的价值在于它打破了向量搜索中“数学即一切”的教条。它承认了 Embedding 模型的局限性,并保护了 ANNS 算法不因模型的局限而受罚。
局限性:
- 依赖 Judge 质量:如果 LLM 判断失误,指标也会失真。
- 动态维护难:数据频繁更新时,重新计算 SN 子集需要持续的计算投入。
对于正在构建大规模 RAG(检索增强生成)系统的团队来说,这篇文章提供了极佳的降本增效思路:试着放低对数学 Recall 的执念,你的算力成本可能会有惊喜。