
Shadow in the Cache:揭秘 KV-cache 隐私风险与无损防御黑科技
Shadow in the Cache: Unveiling and Mitigating Privacy Risks of KV-cache in LLM Inference
本文揭示了 LLM 推理加速核心机制 KV-cache 的严重隐私漏洞,通过 Inversion、Collision 和 Injection 三种攻击手段实现了从明文缓存到用户输入的准确还原。为应对此威胁,作者提出了 KV-Cloak,一种基于可逆矩阵混淆与算子融合的轻量级防御方案,在保持 SOTA 性能的同时实现了近乎无损的模型精度。
TL;DR
在 LLM 推理加速的世界里,KV-cache 是不可或缺的性能功臣。然而,浙江大学与华为的研究团队最近在论文中投下了一枚重磅炸弹:明文存储的 KV-cache 正成为用户隐私的“泄露黑洞”。攻击者可以直接从缓存数据中逐字还原你的聊天记录。为此,研究者推出了 KV-Cloak——一种既能阻断黑客重构,又不影响推理速度(开销 < 1%)且精度无损的防御方案。
1. 痛点:被忽视的隐私“后门”
为了提升推理吞吐量,KV-cache 存储了 Attention 机制产生的中间计算结果。在当前的云端 MaaS 应用中,为了追求极致的端到端延迟,这些动辄 GB 级别的缓存数据往往在 GPU 内存或持久化存储中以明文形式存在。
为什么这很危险? KV-cache 中的 Key (K) 和 Value (V) 向量与输入 Token 存在直接的数学对应关系。尽管它们看似是一堆高维浮点数,但对于拥有模型权重的攻击者来说,这就是一张“藏宝图”。
2. 三种致命攻击:如何从“缓存”还原“真名”
作者展示了三种不同维度的攻击手段,证明了风险的普遍性:
- Inversion Attack (逆向攻击):利用矩阵求逆,直接从第一层 KV 向量反推出原始 Embedding。
- Collision Attack (碰撞攻击):这是最具威胁的手段。攻击者利用本地模型模拟所有可能的 Token,寻找与泄露缓存最接近的“碰撞点”。实验显示,即使是微调过的模型,也能被轻松还原。
- Injection Attack (注入攻击):利用大模型的指令遵循能力。攻击者在被窃取的缓存后拼接一句“重复上述内容”,诱导模型自己“交待”出缓存里的秘密。
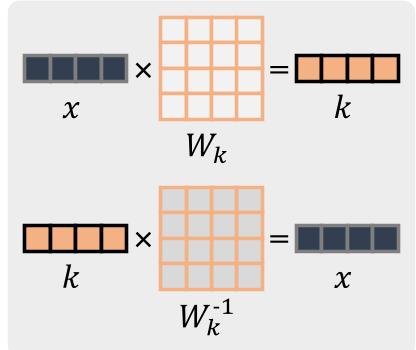
3. KV-Cloak:算法与架构的华丽共舞
面对这种威胁,传统的加密(太慢)和差分隐私(太笨,破坏精度)都失效了。KV-Cloak 采用了截然不同的思路:可逆混淆 + 算子融合。
动态“变脸”:OTP 块级置换
KV-Cloak 将 KV-cache 划分为 PagedAttention 块(如 16 个 Token 一组),并为每一块施加随机的、一次性的排列组合。这就像是在每一组数据存入前都打乱了顺序,让攻击者无法建立稳定的数学联系。
算子融合:将防御“焊”在模型里
最精妙的地方在于,KV-Cloak 并不在推理时进行耗时的动态加密,而是将混淆用的变换矩阵 在离线阶段直接融入到模型的 权重中。 这意味着,模型长出的“果实”(KV 向量)天然就是混淆过的。在线推理时,仅需极小的代价即可恢复计算所需的数学一致性。
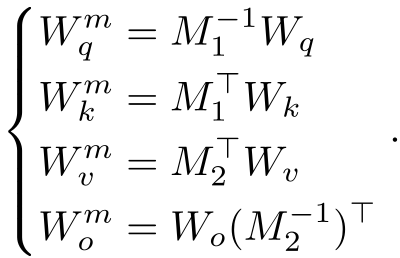
4. 实验战绩:安全与性能的“既要又要”
KV-Cloak 在 Llama 系列和 Qwen 模型上展现了统治级的防御力:
- 安全性:所有攻击手段的重构准确率降至 0。统计学上,攻击者拿到的数据与随机噪声无异。
- 性能开销:在 Llama-3.1-8B 上,其延迟仅增加了 0.45%,远低于 AES 加密(近 100% 的额外开销)。
- 精度表现:在 MMLU 和 SQuAD 任务中,KV-Cloak 实现了 0.0% 的精度损失。
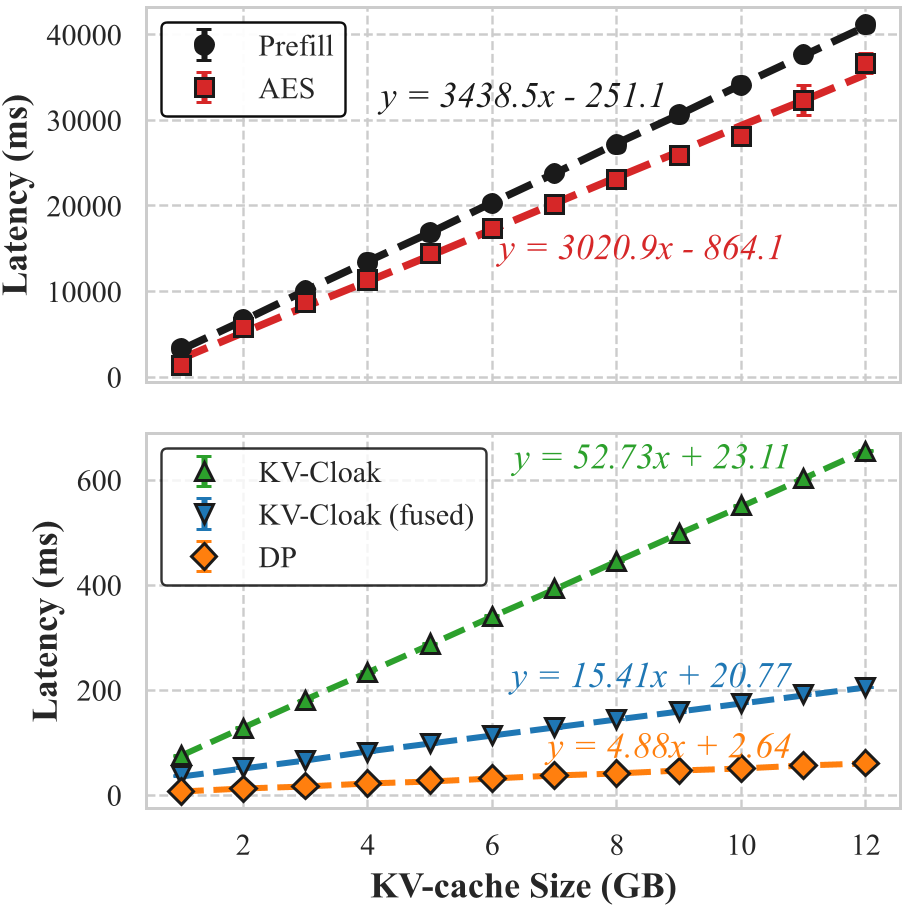
5. 深度洞察
KV-Cloak 的成功不仅在于它解决了一个具体的安全痛点,更在于它指明了一个方向:大模型的安全方案不能独立于模型架构之外。 只有深入理解 Transformer 的内部机理(如位置编码 RoPE 的交换律),才能在隐私保护、模型精度和系统吞吐量之间找到那个完美的平衡点。
对于未来的云端 AI 服务商而言,这种“默认安全”且“性能透明”的防御技术,将是构建可信 AI 服务的基石。