
模块化 Agent 技能流水线:攻克国会图书馆标题索引的“规则长城”
A Skill-Based AI Agentic Pipeline for Library of Congress Subject Indexing
本文提出了一种基于 AI Agent 的模块化技能流水线(Agentic Skill Pipeline),旨在自动完成国会图书馆标题索引(LCSH)任务。该系统通过将复杂的编目工作分解为概念分析、定量过滤、权威校验和 MARC 字段合成四个离散阶段,成功实现了与专业编目实践高度一致的自动化索引。
TL;DR
在图书馆学中,国会图书馆标题索引(LCSH)被公认为最耗时、最考验专业素养的任务。本文作者 Eric H. C. Chow 提出了一种创新的 Agent 技能流水线。不同于以往“一言不合就生成”的 AI 方案,该系统将编目专家数年的训练逻辑拆解为四个离散的 Agent 技能,不仅实现了高度的专业合规性,还完美适配了 2026 年即将实施的最新编目政策。
痛点深挖:为什么 LLM 在编目任务中经常“翻车”?
传统的自动索引尝试要么死于标签稀疏性(100多万个标签中,绝大多数在训练集中极少出现),要么死于规则漠视。
现有的 LLM 尝试(如 ChatGPT 直接生成 MARC 记录)虽然能抓住大概的主题,但在严谨的学术/图书馆环境下存在致命伤:
- 虚假标题:生成看似专业但并不在权威文件(Authority File)中的术语。
- 结构混乱:无法正确处理复杂的
$x(主题)、$z(地理)、$y(年代)细分顺序。 - 政策之后:无法主动适应图书馆政策的实时更新(如 LCSH 与 LCGFT 的角色置换)。
作者敏锐地察觉到:索引不是一个“翻译”任务,而是一个多阶段推理任务。
核心方法:像专家一样思考的四个技能
该系统的精髓在于其四阶段顺序流水线。它将外部的政策手册(SHM)直接转化为 Agent 的“行动指南”。
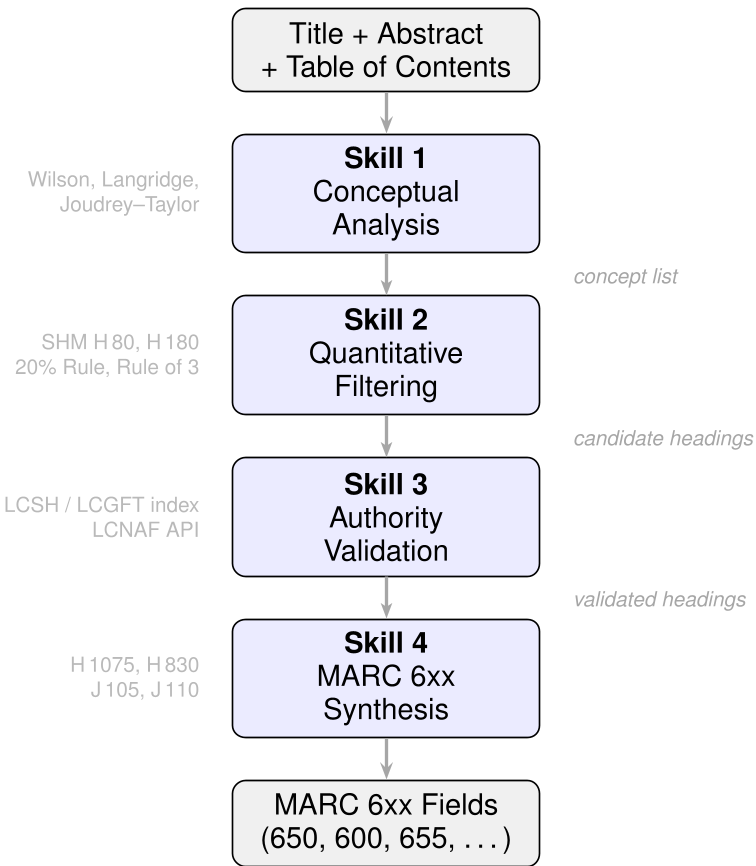
- 技能 1:概念分析 (Conceptual Analysis) 不急于给标题,而是先运用 Wilson 的四种主题判别法和 Langridge 的三个问题,从书名、摘要、目录中挖掘“它是关于什么的?”和“它是为了什么的?”。
- 技能 2:定量过滤 (Quantitative Filtering) 这是最硬核的部分。Agent 必须运行 SHM 的内部逻辑:如果一个主题不占全书 20%,除非是关键实体,否则剔除;如果并列了四个相似主题,则用上位词替换。
- 技能 3:权威校验 (Authority Validation) 这是 Agent 的“联网/查表”能力。通过 TF-IDF 索引本地 101 万条 LCSH 记录,并实时调用 API 验证名称(LCNAF)。
- 技能 4:MARC 字段合成 (MARC Synthesis)
最后的封装阶段。严格遵循
$a → $z → $x → $y的语法糖,确编码组数据能直接导入图书馆自动化系统(ILS)。
实验战绩:AI 竟然比历史人工“更懂新规”?
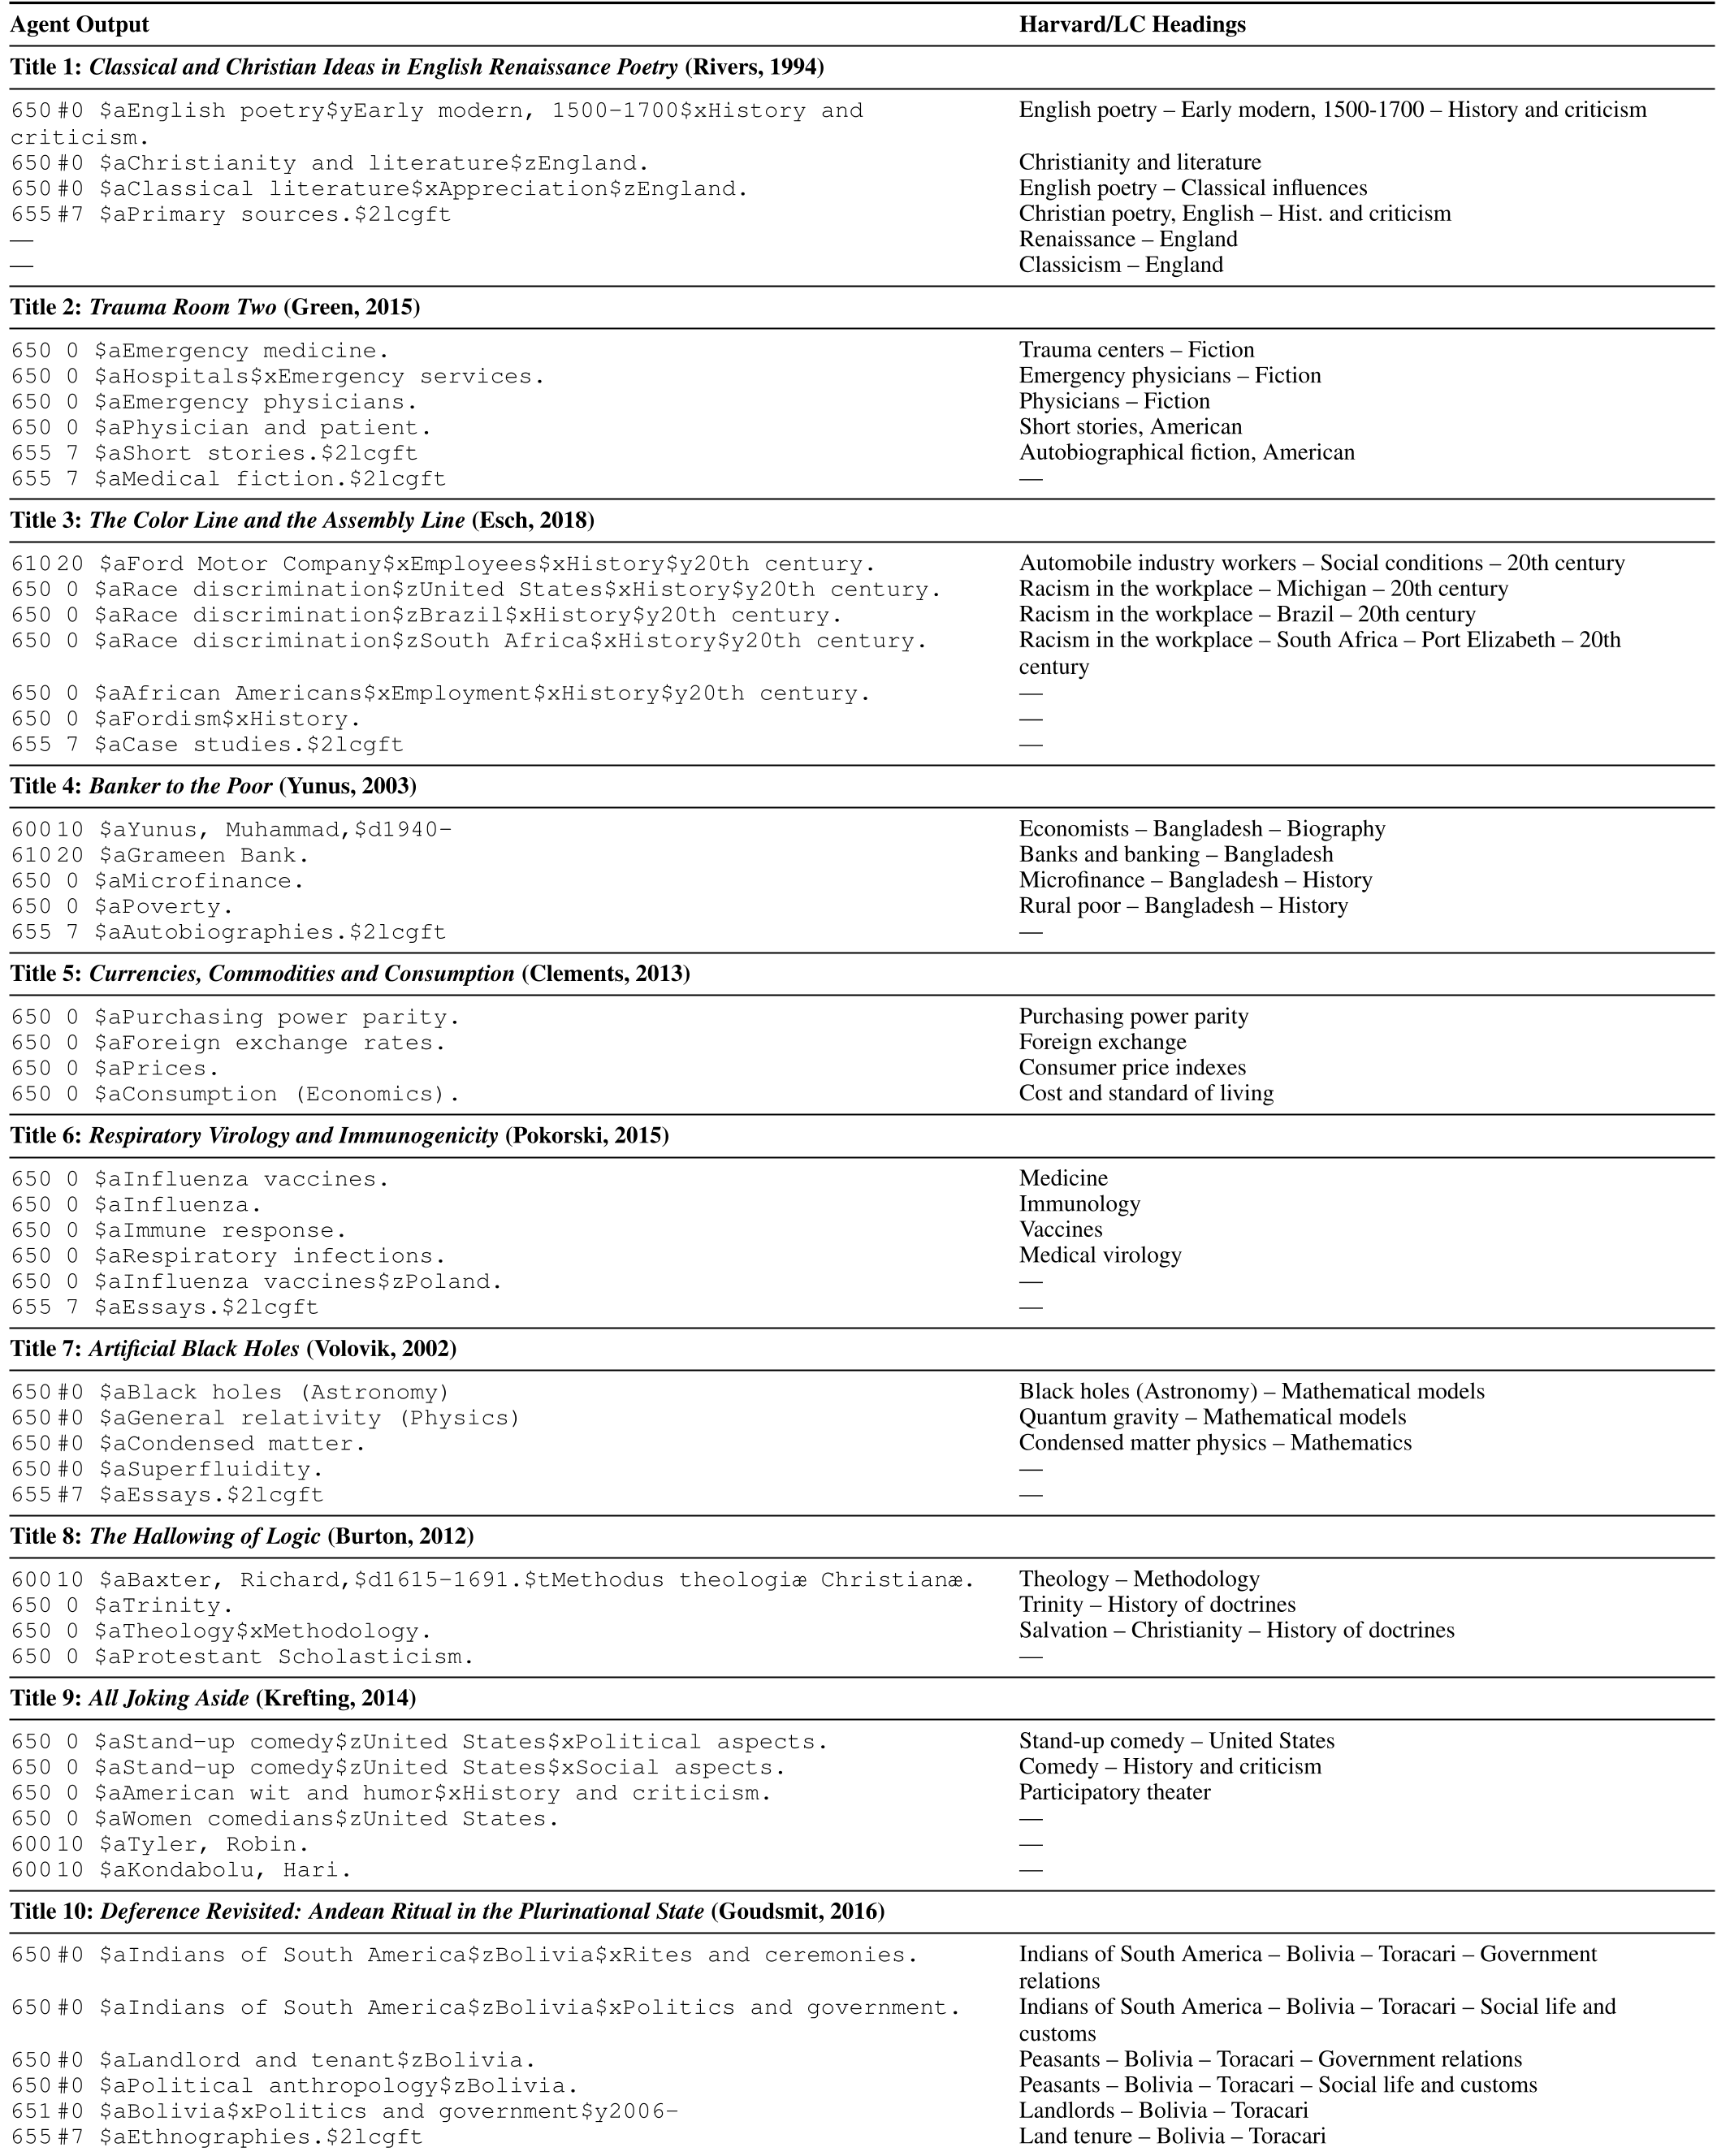
作者使用了哈佛大学图书馆的真实编目数据作为 Baseline。在 10 个跨领域的样本测试中,该流水线展现了令人惊讶的特性:
- 政策超前性:针对 2026 年即将施行的 $v 细分停用政策,AI 完美执行了将形式细分移动到 655 字段(LCGFT)的操作,而对比的哈佛历史记录仍采用旧制。
- 特指度更高:在《呼吸道病毒学》一书中,人工只给了“医学”、“免疫学”这种宽泛的大类标签,而 Agent 精准地提取了“流感疫苗”和“免疫反应”。
深度洞察:规则编码 vs. 模型微调
这篇论文提供了一个非常关键的学术启示:对于强规则约束的领域(如法律、医学、精密行政),与其追求更大的模型或更多的微调数据,不如追求更精细的 Agent 角色拆解。
这种“外部化推理”架构的优势在于:
- 可审计性 (Auditability):你可以清楚地看到某个错误标题是在过滤阶段被错留的,还是在合成阶段被拼错的。
- 可维护性 (Maintainability):法律或政策变了?只需要改写对应 SKILL.md 中的一段指令,而不需要重新训练模型。
局限性与展望
尽管表现出色,Agent 在处理深层次的地理细分(如精确到某个具体的山谷,而非仅仅是国家)时仍显不足。未来的研究可能会引入更加动态的检索增强机制(RAG)来弥补地理知识的短板。
总结: 这一研究不仅是图书馆领域的福音,更是展示了 AI Agent 如何在处理“高认知负载、低容错率”任务时,通过模仿专业人士的思维流水线来突破生成式 AI 的局限性。