
SkillHone:通过持久化决策历史,打造永续演化的智能体技能
SkillHone: A Harness for Continual Agent Skill Evolution Through Persistent Decision History
本文提出了 SkillHone,一种面向大语言模型智能体(Agent)技能持续演化的安全线架构。该方法通过维护持久化决策历史(Persistent Decision History),使智能体能够在跨会话的技能修订中保留先前的诊断、评估证据和决策逻辑,在 GAIA 榜单上取得了 64.6% 的 SOTA 战绩。
TL;DR
在 AI Agent 领域,"技能"(Skills)是扩展模型能力的各种脚本和流程。然而,现有的技能自动优化方法往往是“一锤子买卖”,优化完后只剩下一段冷冰冰的代码。SkillHone 打破了这一局限,它不仅保留改进后的代码,还记录了“为什么要这么改”的持续决策历史。实验证明,这种带有“记忆”的进化方式,让智能体在处理复杂的深度研究任务时,表现远超那些依赖商业搜索接口的闭源系统。
背景:被遗忘的“决策过程”是 Agent 进化的死穴
当前的智能体技能提升路径主要分为两类:
- 合成式构建 (Synthesis-style):根据任务描述生成技能包,直接交付。
- 反射式优化 (Reflective Optimization):如 Hermes-SE,通过迭代、评估、选择来刷榜。
痛点在于:这些方法都视改进过程为“有界运行”。一旦会话结束,关于“为什么拒绝了方案 B”、“方案 A 是针对哪个 API 报错修补的”等关键 Insight 就会丢失。当外部环境(如 Web 页面格式、API 限制)发生变化时,新的 Agent 会因为丧失上下文而陷入“原地打转”或“功能回退”的境地。
核心机制:角色隔离与持久化历史
SkillHone 并不是一个简单的 Prompt 优化器,而是一套分权治理的演进框架。
1. 角色分离 (Role-Separated Subagents)
为了防止 Agent 在优化过程中通过“作弊”(直接背诵评估集答案)来提升分数,SkillHone 强制执行了权限边界:
- 优化团队 (Optimization Team):负责读历史、下诊断、写代码,但严禁接触原始测试数据(Oracle Targets)和执行轨迹。
- 评估团队 (Evaluation Team):负责跑测试、看证据、出报告,但严禁修改技能代码库。它只能返回“脱敏后的报告”(Redacted Reports),告诉优化侧哪里坏了,而不告诉它正确答案是什么。
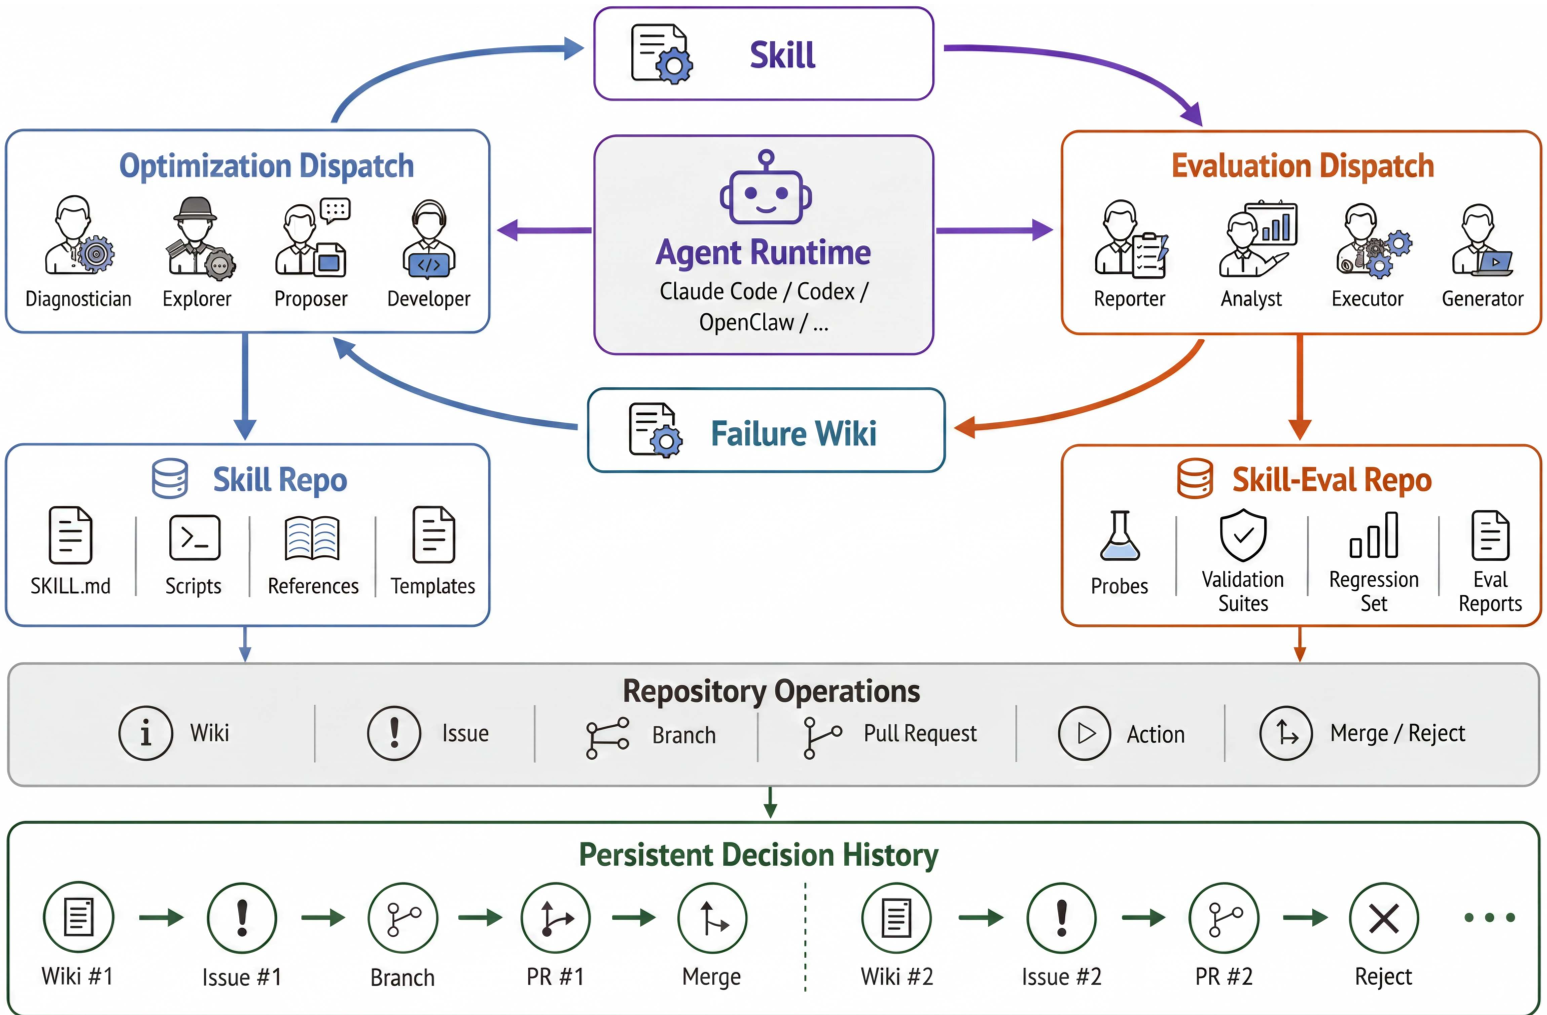 图 1:SkillHone 架构。通过调度器(Dispatcher)实现优化与评估侧的严格物理隔离,确保进化过程的真实性。
2. 持久化决策历史 (Persistent Decision History)
SkillHone 将每一步演进记录为四元组 :
- (Diagnosis): 对当前问题的诊断。
- (Revision): 提出的修订代码。
- (Evidence): 脱敏后的评估证据。
- (Outcome): 最终决定(采纳、拒绝或进一步修订)。
这种结构化的记录允许后续智能体进行“审计”。如果某次修改导致性能下降,Agent 可以追溯到具体的证据,只撤销错误部分,而不是粗暴地推倒重来。
实验战绩:不靠商用 API 也能吊打深研智能体
研究团队在 GAIA 和 WebWalkerQA-EN 两个极具挑战性的榜单上进行了测试。在“原始开放网络”设置下,Agent 只能使用自己维护的技能去爬虫、解析和检索。
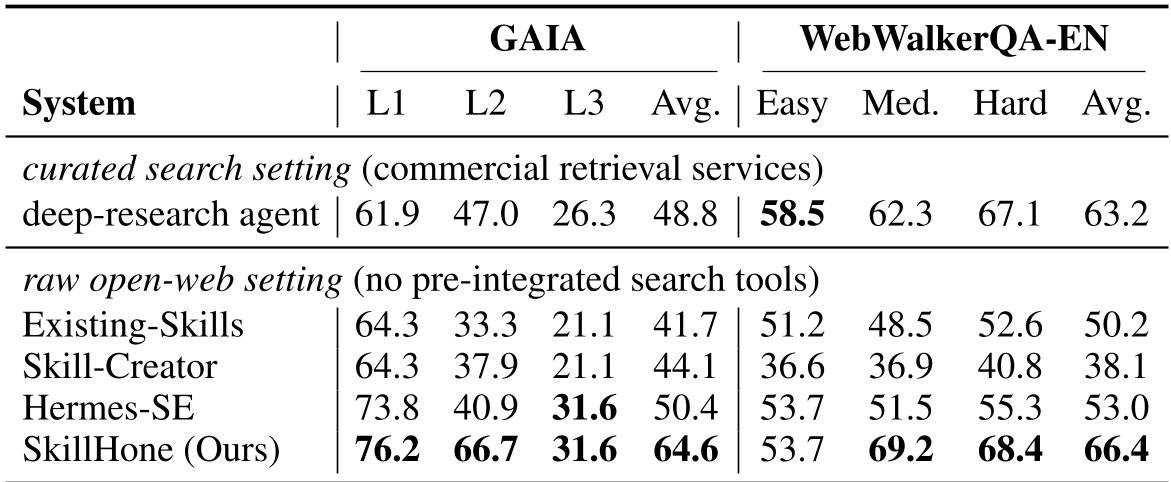 表 1:性能对比。SkillHone 即使在没有预集成搜索栈的情况下,也全面超越了基线。
关键结论:
- 超越商用方案:相比于使用昂贵商业检索服务的深研智能体,SkillHone 演化出的技能在 GAIA 上高出 15.8 分。
- 防止负优化:如图 3 所示,相比于只看最终得分的 Hermes-SE,SkillHone 能够从性能退化(Regression)中通过后续编辑快速恢复,而基线方法往往会陷入死循环。
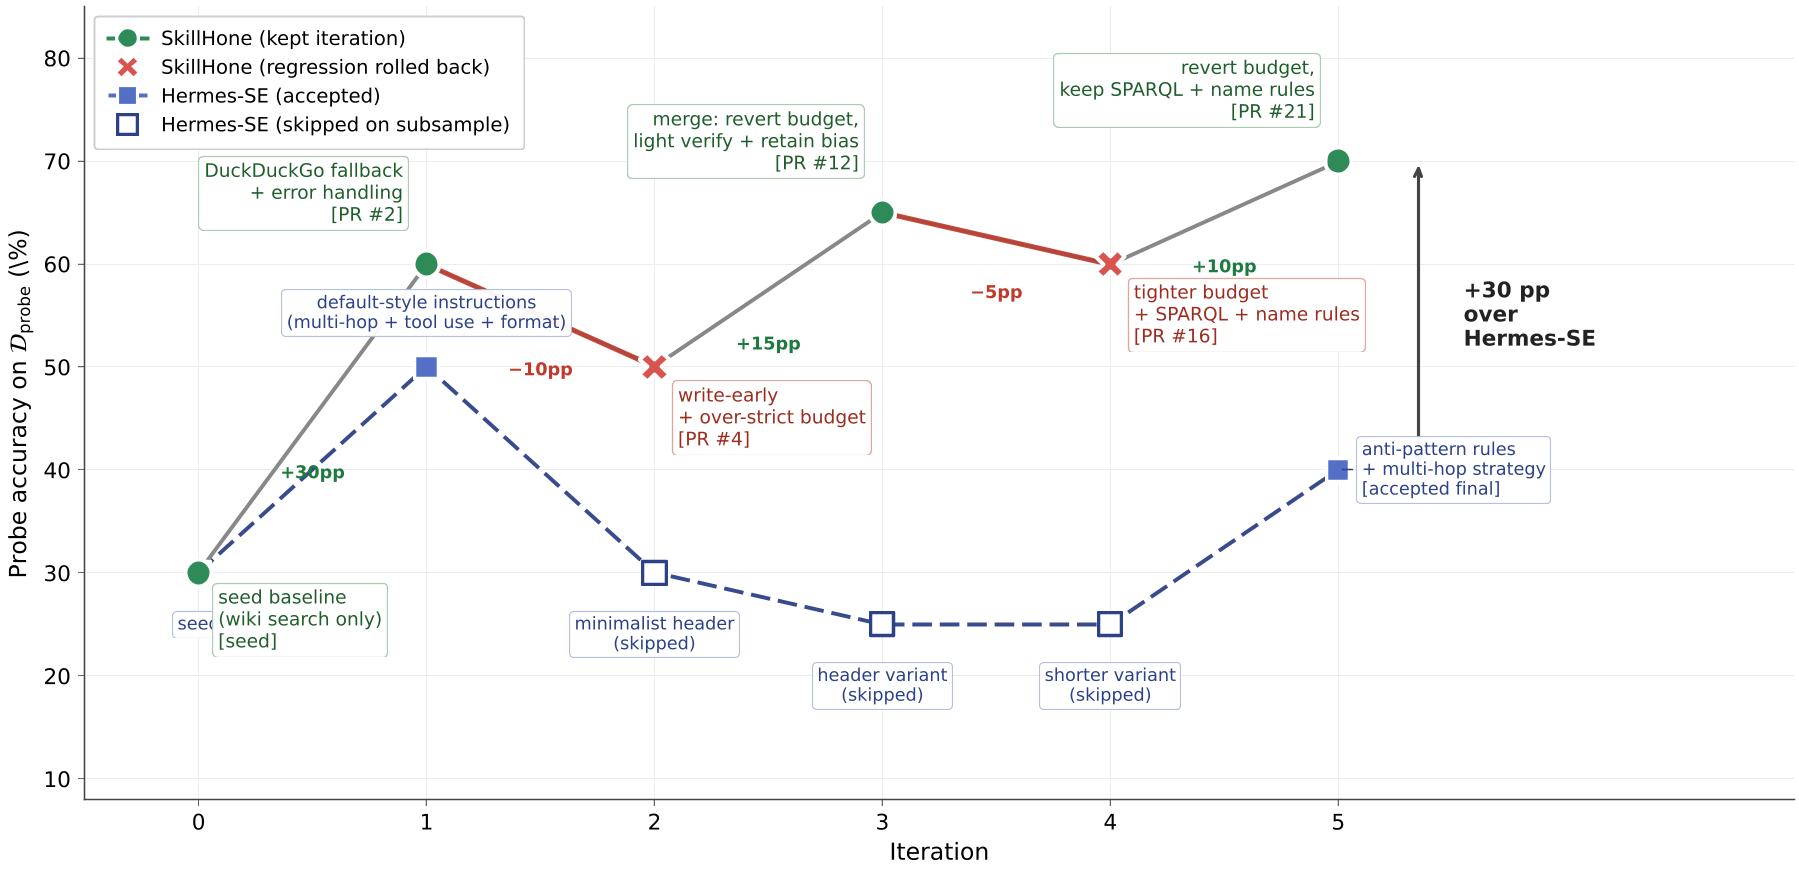 图 3:SkillHone 与 Hermes-SE 的优化轨迹对比。决策历史让 SkillHone 在面临性能下降时具备更强的弹性恢复能力。
深度洞察
SkillHone 的成功证明了一个深刻的直觉:智能体的自我进化不应只是“参数”或“指令”的搜索,而应该是“逻辑抽象”的积累。 在工业界,维护一个 Agent 的成本往往高于开发它。SkillHone 提供的这种“带注释的进化日志”,实际上是将人类软件工程中的版本控制(Git)与变更说明(Commit Message)理念引入了 AI 原生开发模型。
局限性与未来
尽管表现优异,SkillHone 目前主要针对单个技能的独立演化。在现实场景中,多个技能之间往往存在复杂的依赖关系。未来,如何处理技能间的交互演化,以及如何支持多语言环境,将是该技术走向大规模应用的关键。
Takeaway: 真正的 Agent 智能不在于它当前掌握了多少技能,而在于它是否拥有一个能够持续学习、纠错且不遗忘任何决策细节的“经验账本”。