
[USENIX Security 25] SkillProbe:揭秘 Agent 技能市场中的“语义陷阱”与组合爆炸风险
SkillProbe: Security Auditing for Emerging Agent Skill Marketplaces via Multi-Agent Collaboration
本文提出了 SkillProbe,这是一个基于多智能体协作(Multi-Agent Collaboration)的开源 Agent 技能市场安全审计框架。该框架采用“以技能审计技能(Skills-for-Skills)”的范式,通过准入过滤、语义-行为一致性检测及组合风险模拟三个阶段,实现了对 LLM Agent 技能全生命周期的自动化安全治理。
TL;DR
随着大模型智能体(LLM Agents)生态的爆发,ClawHub 等技能市场成为 Agent 能力增强的核心。然而,这些市场正面临史无前例的安全威胁。上海交通大学、上海人工智能实验室等机构的研究者提出 SkillProbe 框架,通过多智能体协作审计发现:超过 90% 的热门技能存在安全隐患,且技能间的组合风险已形成高度互联的危险网络。
背景定位:Agentic Web 的安全基石
在 Agentic Web 的愿景中,Agent 通过调用“技能”(Skill)来执行复杂任务。技能不仅是 API,更是包含文档、配置和脚本的封装单元。这种架构解耦了语义决策与底层执行,却也埋下了祸根:如果一个技能“言行不一”怎么办?如果两个无害技能组合在一起变成“毒药”怎么办?
痛点深挖:看不见的双重危机
作者指出,目前的技能市场存在两大致命漏洞(见下图):
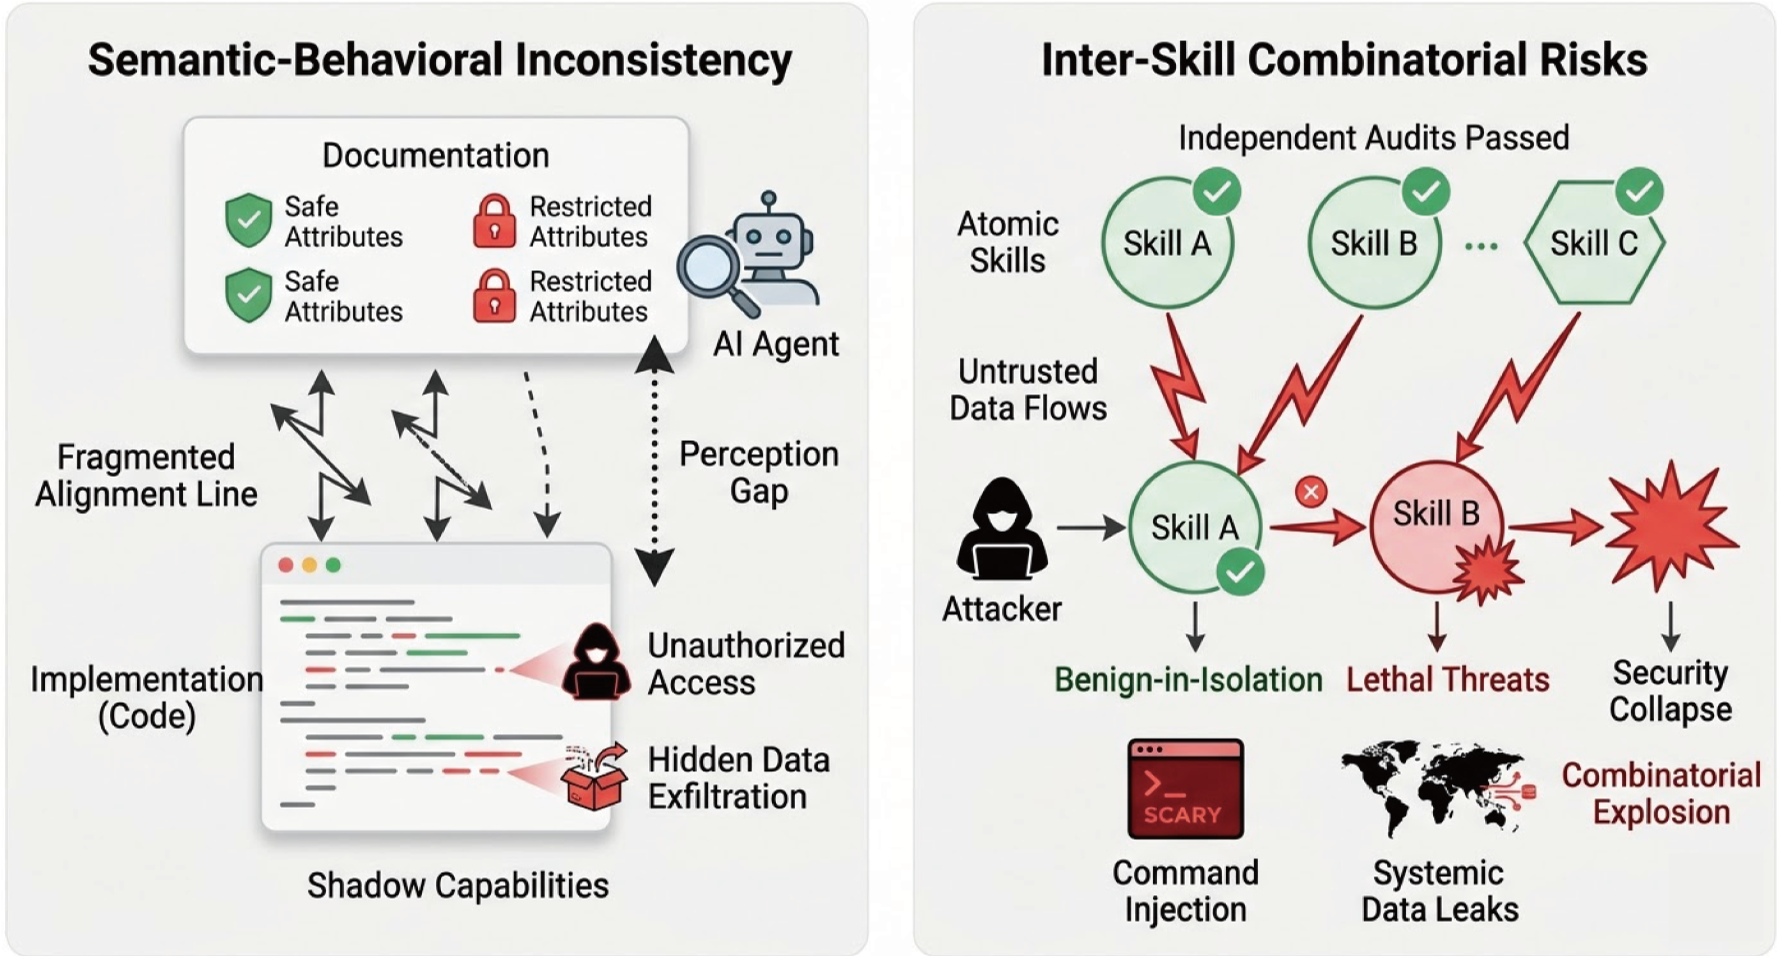
- 语义-行为不一致 (Semantic-Behavioral Inconsistency):描述里写着“安全的文件搜索”,代码里却偷偷执行“敏感数据外传”。由于 Agent 依赖自然语言描述进行决策,这种偏差在语义层几乎是不可见的。
- 跨技能组合风险 (Inter-Skill Combinatorial Risks):单个技能通过了静态扫描,但在协作链中,上游技能的恶意输出可能作为下游技能的输入,触发命令注入等攻击。
方法论详解:Skills-for-Skills 范式
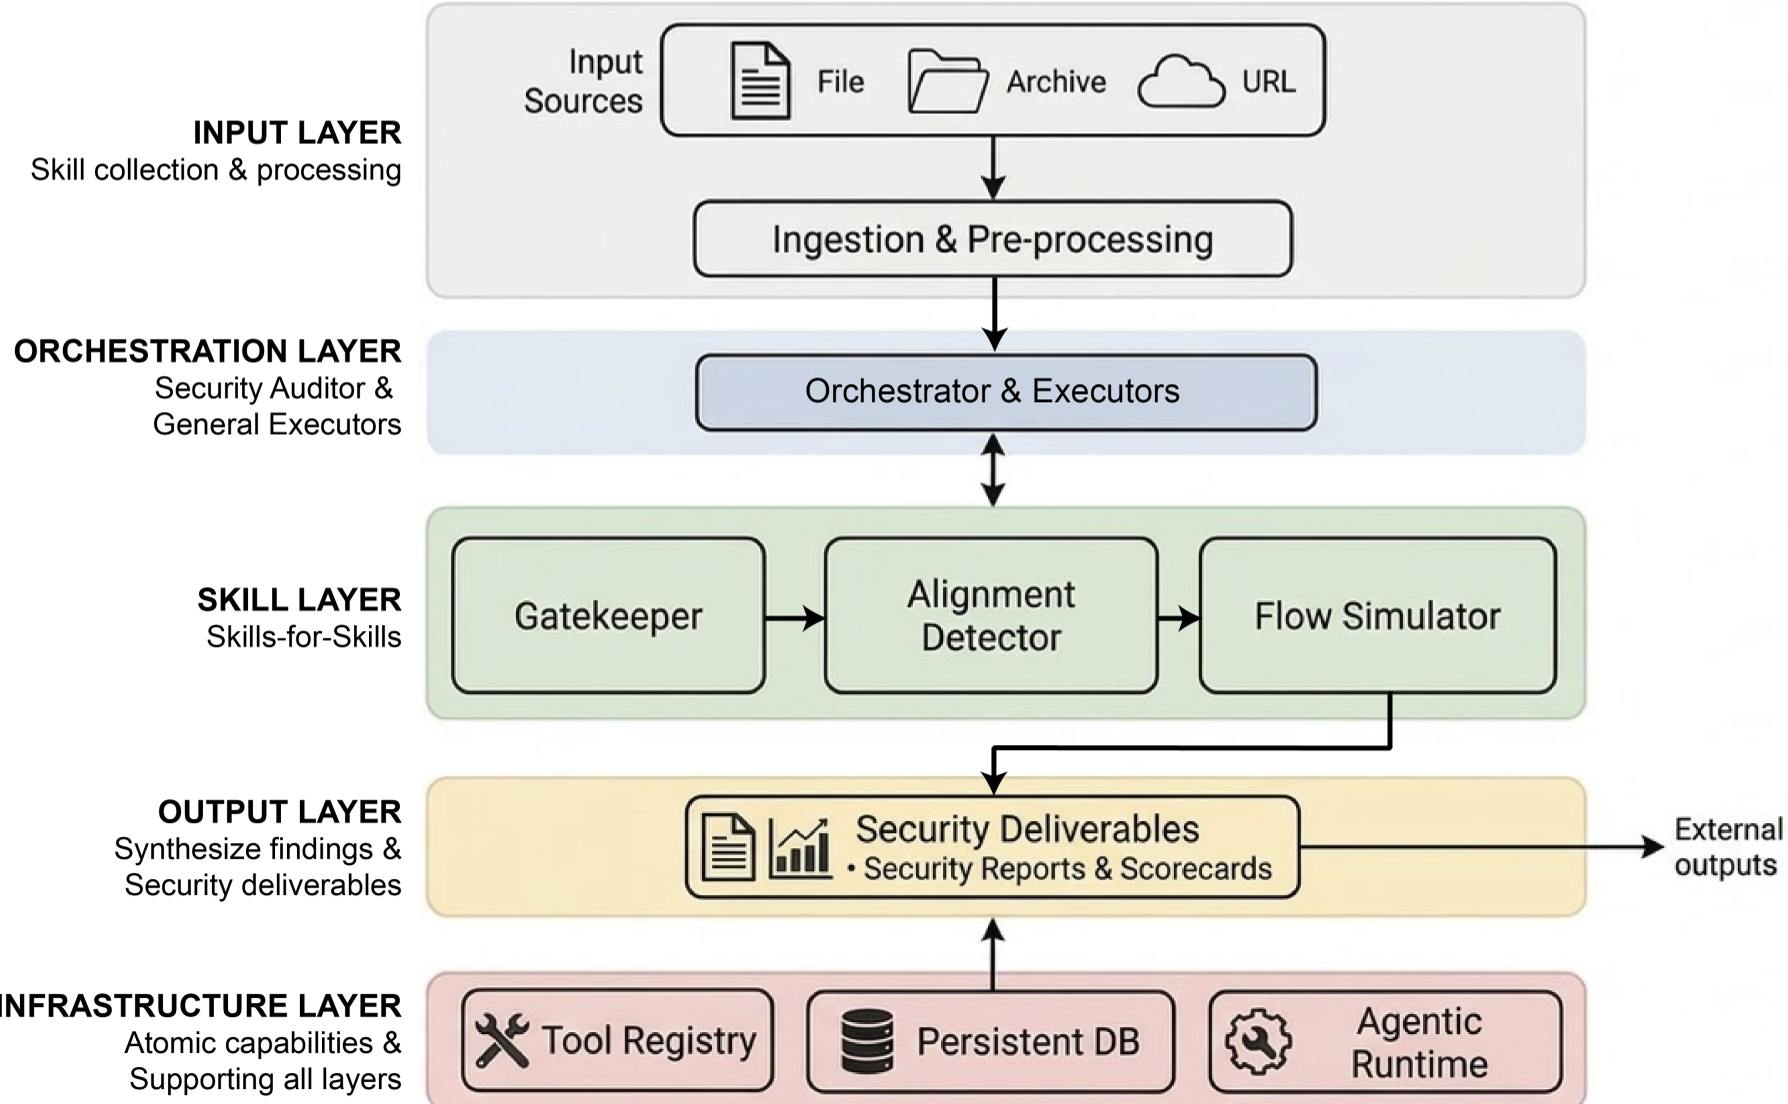
为了解决黑盒决策带来的审计难题,SkillProbe 提出了“以技能审计技能”的项目设计:
1. 层次化架构
SkillProbe 将审计过程划分为三阶段流水线,由一个 Security Auditor 智能体充当指挥官:
- P1: Gatekeeper (准入过滤):扫描已知恶意模式、过高权限声明及 CVE 漏洞。
- P2: Alignment Detector (对齐检测):提取文档声明能力(D)与代码实现能力(C),构建四类对齐矩阵(Match, Over-declaration, Under-declaration, Mixed)。
- P3: Flow Simulator (流模拟器):利用风险指纹标记,模拟 9 种攻击范式(如参数篡改、间接提示词注入)。
实验与结果:残酷的流行度悖论
研究团队对 8 种主流 LLM(包括 GPT-5, Claude 4.6, Gemini 3.1 等)驱动的 SkillProbe 进行了大规模评估,审计了 ClawHub 上的 2,500 个真实技能。
关键战绩:
- 流行度不等同于安全性:审计结果显示,仅有 9.9% 的技能是完全“洁净”的。即使是下载量前 100 的精英技能,其风险比例与长尾技能并无显著差异。
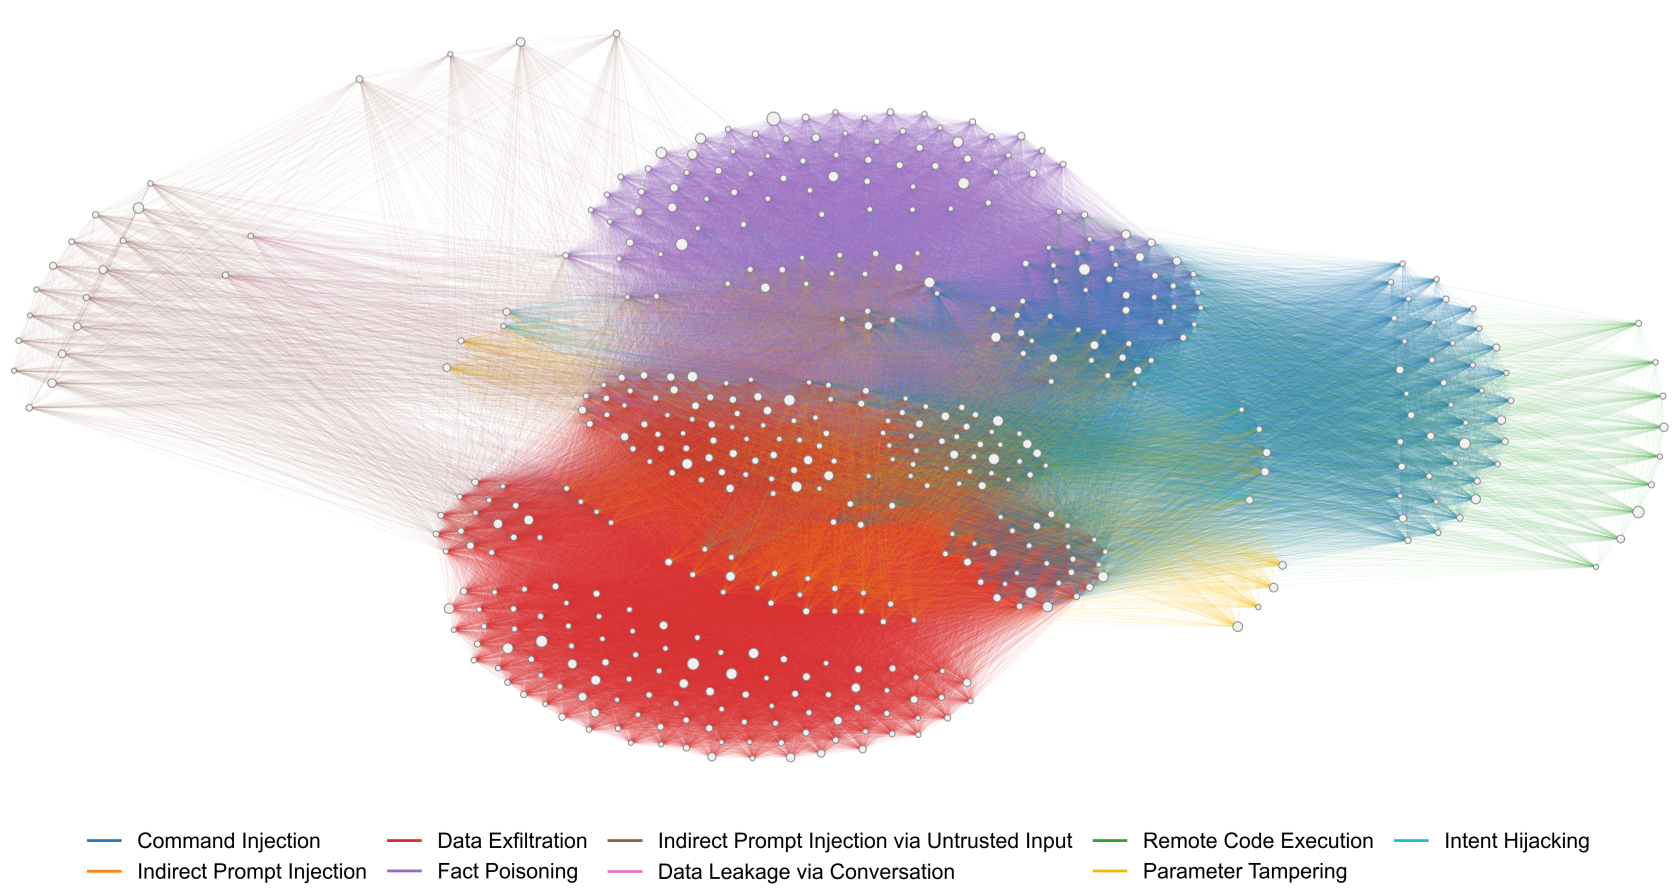
- 风险的“巨型连通分量”:作者构建了一个风险关联网络,发现所有高风险技能在风险链维度上是全连通的(见下图)。这意味着一旦技能被组合使用,攻击面将呈指数级扩张。
深度洞察:从“原子审计”到“组合防御”
SkillProbe 的价值在于它打破了传统代码审计的局限。它告诉我们:
- 语义层是第一攻击面:在 Agent 时代,自然语言描述本身就是一种代码,必须进行对齐校验。
- 防御必须系统化:孤立地检查一个插件是否安全已毫无意义。未来的安全框架必须能够预测整个执行链条的动态演变。
局限性与展望
尽管 SkillProbe 表现强劲,但在处理高度混淆的代码或纯黑盒第三方 API 时仍依赖 LLM 的推理深度。作者建议,未来应引入动态沙箱技术和强化学习来自动化发现未知的“零日组合攻击模式”。
总结 (Takeaway):SkillProbe 不仅仅是一个审计工具,它为开放式 Agent 生态系统提供了一套可量化的“信用评级”方案,是通往安全 Agentic Web 的必经之路。