
SoL-Pi:把 Agent Harness 变成可搜索对象,用递归 Auto-Research Loop 降低长程 Token 成本
SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
SoL-Pi 是一种面向 agent harness 的 RSI-inspired 自动研究系统。它通过 broad-to-deep 搜索和两道接受门发现四个可迁移 token 效率机制。在 EdgeBench 的 51 个公开任务上,完整堆栈相比 Pi 将记录 token 流量降低 44.7 到 49.0 个百分点,并减少约三分之一 API 成本,同时保持接近的任务分数。
核心速览
SoL-Pi 研究的问题不是如何让模型本身更便宜,而是如何让 coding agent 的外围 harness 更省 token、更省 API 成本。作者把 harness 看作一个可由 AI 反复阅读执行轨迹、提出改动、在隔离环境中验证的代码对象,并通过“开发搜索”和“留出验证”的单向隔离,筛选出能够迁移的机制。最终保留的四个机制分别处理动作执行、上下文压缩、观察结果投影和构建日志的委托阅读。论文报告,在 EdgeBench 的 51 个公开任务上,完整 SoL-Pi 堆栈相比 Pi 基线减少 44.7 到 49.0 的记录 token 流量,API 成本下降约三分之一,同时平均任务分数保持在接近水平。
这项工作的定位不是模型压缩、推理加速或廉价路由,而是 harness 层的自动工程搜索。它处在一个较新的交叉点上:一边是递归自我改进和自动代码优化,另一边是长程 agent 的真实成本结构。论文没有提出新的模型训练方法,也没有声称发现 scaling law;它最重要的贡献是组织了一场足够大、足够隔离的自动搜索,并把搜索中活下来的机制封装成可评测的 harness。
问题与动机
长程 coding agent 的 token 成本主要来自模型与环境的反复交互。一次多文件修改可能包含读取、编辑、测试、构建、失败重试、日志读取、上下文累积等大量步骤。若只在基础设施层降低单位 token 成本,例如使用更快 attention kernel、量化或路由到更便宜模型,收益仍然受制于 agent 到底发出了多少 token、重复搬运了多少观察结果。SoL-Pi 试图从另一个方向切入:减少不必要的模型往返和重复上下文。
现有 harness 优化的困难在于局部改动会改变全局成本结构。一个减少当前 prompt 长度的改动,可能破坏 prompt cache;一个更激进的上下文压缩,可能在后续诊断失败;一个自动合并动作的工具,可能让 agent 无法检查中间状态。论文在第 2 节指出,harness 开发通常需要人类阅读长执行轨迹、定位反复出现的失败模式,再翻译为代码改动,这个过程成本高且难以跨任务扩展。更关键的问题来自近期评测工作:如果候选 harness 在搜索阶段就能从最终任务获得反馈,它可能把留出集上的失败修补成任务专用解法,从而高估泛化能力。
SoL-Pi 的研究直觉是:把 harness 改进视为可复用机制的搜索,而不是某个 prompt 的局部调优。这个直觉不是纯粹工程尝试,而是被自动科研中的隔离验证要求所支持。论文明确把能力指标、容忍度和效率指标在实验前冻结,并禁止留出结果返回搜索循环。换言之,作者认为自动发现效率机制的瓶颈不只是“让 AI 提出好点子”,而是“让搜索过程本身不可被任务过拟合污染”。
核心章节:从基线开销到可迁移机制
出发点:harness 层的 token 效率需要同时约束成本与能力
论文把 token 效率定义为每单位聚合任务分数消耗的 API 成本。若 表示某个 harness 在固定模型、固定任务集上的美元成本, 表示平均任务分数,则可写成:
其中 是外部记录的真实计费成本,包含不同模型与缓存读写价格; 是任务完成质量。这个量在论文中的作用是把效率从单一 token 计数拉回到“省多少美元才换回多少分数”的联合目标。Table 1 和 Table 4 都把它作为关键列,说明作者并不是单纯追求 token 减少,而是要求质量下降控制在可接受范围内。若只看 而不看 ,agent 可以通过不完成任务来降低成本;若只看 而不看 ,长程推理又可能无限扩张上下文。SoL-Pi 的接受规则必须同时处理这两侧。
论文把基线 Pi 作为主要比较对象。Pi 是 coding agent toolkit,SoL-Pi 的四个机制都作为 Pi 扩展实现。这个选择很关键:如果起点是一个已经高度人工优化的复杂 harness,自动搜索的增量可能混入大量既有设计;如果起点过于简单,搜索可能只是在补基础功能。Pi 作为扩展宿主,使作者能够把“保留的机制”从“模型本身”中分离出来。
机制:宽浅漏斗、独立 lineage 与冻结验证边界
SoL-Pi 的核心组织方式是 broad-to-deep funnel。外层搜索覆盖大量假设,内层对选中假设反复实现、审阅、加固。论文第 2.2 节报告,外层包含 152 个 proposed directions,分成 context、progress、tools、delegation、prompt and policy、improvement and evaluation 六个 proposal families;搜索使用 535 个 executable environments,其中 495 个来自 GitHub issue 到 pull request 的真实仓库任务,40 个是 verifier-driven synthetic tasks。整个搜索大约包含 3,000 次运行和 60,000 次 agent-environment interactions。论文强调,这些数量描述搜索规模,并不构成 scaling law。
候选机制能否进入最终堆栈,取决于论文第 2.1 节定义的接受门。若把能力违规指标写成 ,容忍度写成 ,效率指标写成 ,则接受规则可形式化为:
其中 是候选 harness 改动, 表示论文冻结的能力退化量,任务失败、无效调用、分数下降等都可进入这一类; 在实验开始前固定,且不允许优化 agent 控制。 是效率量,论文中最直接的是记录 token 总量、token 成本或 token efficiency。相比普通自动代码生成,这个公式的作用不是“选最高分”,而是要求候选先守住能力底线,再至少改善一项效率指标;若多个候选同时通过,则保留非支配结果。若把 交给优化 agent 调节,搜索很容易通过降低任务要求来假装更高效;若把留出结果接入 ,候选就会针对最终评测集被修补。SoL-Pi 的做法是把开发轨迹用于发现和修订,而把 EdgeBench 的 40 个最终任务冻结在搜索之外。
每个独立 lineage 使用 disposable instance 和 shared skill template。模板只提供最小研究循环和操作说明;每个实验复制模板、设置参数、运行到结束,保留候选与证据,丢弃被修改的 orchestration code。这个设计看起来只是工程卫生,但它直接影响搜索可迁移性:失败方向不会把临时修复带入其它候选。论文在 Figure 3 后说明,repository-derived environments 使用 pre-fix repository state、隐藏 PR 和 regression test,并只保留“patch 前测试失败、patch 后测试通过”的环境;verifier-driven environments 则先生成 executable verifier,再构造任务环境,允许多条合法解决路径。这两类环境分别覆盖真实软件变更和开放式问题求解,同时保持 EdgeBench held out。
落地:四个被保留机制作用于不同开销节点
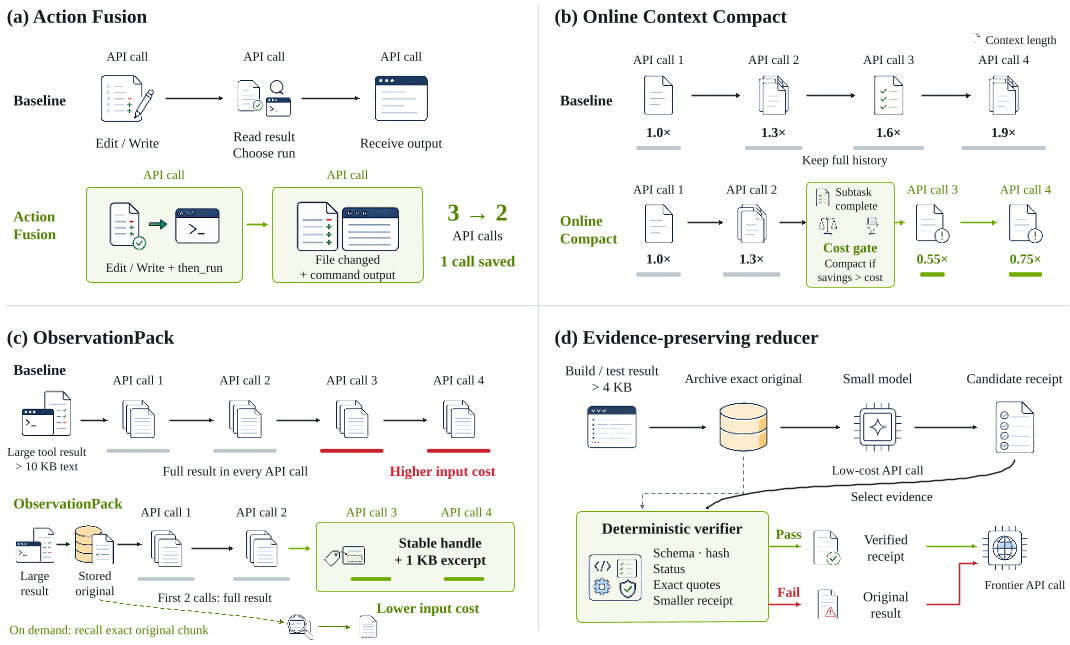
经过筛选后,SoL-Pi 保留四个机制:Action Fusion、Online Context Compact、ObservationPack 和 Evidence-Preserving Reducer。它们分别处理 action execution、context compaction、observation handling 和 delegated reading。论文第 2.4 节和 Figure 4 给出了它们的位置。
| 机制 | 触发位置 | 核心动作 | 关键阈值与保护 |
|---|---|---|---|
| Action Fusion | 文件编辑后紧跟测试或构建 | 合并 mutation 与 follow-up command 为一个 tool request,返回单一 observation | 需要检查中间结果的命令仍保持分离 |
| Online Context Compact | plan step 完成边界和接近 context window 限制 | 按观察到的请求增长估算剩余请求,并与 prompt cache 重写成本比较 | 只有 projected input savings 超过 rewrite cost 才压缩 |
| ObservationPack | 工具输出超过阈值 | 超过 10 KiB 的输出本地归档,先两次完整发送,第三次起替换为 handle、原大小和头尾摘要 | 可通过 handle 精确取回原始内容 |
| Evidence-Preserving Reducer | 至少 4 KiB 的 build 或 test log | 用较低成本模型提取 key evidence receipt | deterministic verifier 检查 schema、hash、exit status、quote 和 size,失败则回退原文 |
四个机制不是同一种压缩。Action Fusion 减少的是模型往返次数;Online Context Compact 管理的是历史上下文何时折叠;ObservationPack 解决的是大观察在后续请求中反复搬运;Evidence-Preserving Reducer 则把构建和测试日志中的关键证据抽取成可验证 receipt。Figure 4 显示它们作用在 agent-environment loop 的不同边界,并用颜色区分 baseline traffic、mechanism savings 和 verification failure。
ObservationPack 的规则可以用请求序号 简化表达:
其中 是第 次 provider request 中该条大观察的实际 payload, 是原始工具输出, 是 stable handle, 是原文第 2.4 节所述的简短头尾 excerpt。这个式子解释了两个关键边界:前两次仍发送完整内容,是为了避免过早破坏模型对刚生成结果的利用;从第三次开始才替换,是因为论文观察到这类大输出在后续请求中重复出现但相关性下降。若把第一次就替换,可能让 agent 丢失刚产生时的完整语义;若始终不替换,则 10 KiB 以上的文件搜索、diff、日志或长工具输出会不断随请求膨胀。Evidence-Preserving Reducer 与 ObservationPack 还有顺序关系:reducer 先处理 build/test logs,ObservationPack 会识别 receipt marker 并跳过已验证证据,避免再次投影破坏证据链。
实验与证据
论文主评测使用 EdgeBench。第 3.1 节说明,EdgeBench 当前公开 134 任务中的 51 个,其中 11 个用于冻结后单向接受检查,剩余 40 个用于最终泛化评测。Table 1 比较了 GPT-5.6 Sol 下的多个 harness:
| Harness | Backend | Token total | Cost | Avg score | Token eff |
|---|---|---|---|---|---|
| Codex | GPT-5.6 Sol | 3.0537B | 1,787 | 34.738 | 1.0086 |
| OpenSquilla | GPT-5.6 Sol | 1.3353B | 1,243 | 24.506 | 0.9945 |
| Oh-My-Pi | GPT-5.6 Sol | 2.2235B | 1,832 | 26.921 | 1.3347 |
| OpenCode | GPT-5.6 Sol | 2.5668B | 3,422 | 29.552 | 2.2704 |
| Oh-My-Opencode | GPT-5.6 Sol | 2.5825B | 2,678 | 38.523 | 1.3633 |
| Pi | GPT-5.6 Sol | 2.1538B | 1,339 | 44.833 | 0.5855 |
| SoL-Pi Efficiency | GPT-5.6 Sol | 1.0990B | 894 | 42.003 | 0.4174 |
| SoL-Pi Performance | GPT-5.6 Sol | 2.0224B | 1,271 | 47.208 | 0.5280 |
Table 1 显示,SoL-Pi Efficiency 的完整四机制堆栈使用 1.0990B token,相比 Pi 的 2.1538B 减少 49.0;成本从 1,339 美元降到 894 美元,下降 33.2;平均分数从 44.833 降到 42.003,保留约 93.7。这说明它的主要收益不是“更高分”,而是“接近分数下明显更便宜”。SoL-Pi Performance 则是另一个操作点:它在 GPT-5.6 Sol 下对应 ObservationPack 单机制配置,把平均分数从 44.833 提到 47.208,提升 5.3,token 流量仍减少 6.1,token efficiency 提升 9.8。论文把两个点都报告出来,而不是只展示一个最强数字,这有助于读者区分效率取向和质量取向。
正文称为 Table 2 的跨后端对比表测试了另一个关键问题:在 GPT-5.6 Sol 轨迹上发现的 SoL-Pi,能否不重新搜索地迁移到 Opus 5?
| 后端 | Harness | Token total | Cost | Avg score | Token eff |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Codex | 3.0537B | 1,787 | 34.738 | 1.0086 |
| GPT-5.6 Sol | Pi | 2.1538B | 1,339 | 44.833 | 0.5855 |
| GPT-5.6 Sol | SoL-Pi Efficiency | 1.0990B | 894 | 42.003 | 0.4174 |
| GPT-5.6 Sol | SoL-Pi Performance | 2.0224B | 1,271 | 47.208 | 0.5280 |
| Opus 5 | Claude Code | 2.0045B | 2,535 | 43.689 | 1.1377 |
| Opus 5 | Pi | 2.3697B | 1,741 | 44.756 | 0.7625 |
| Opus 5 | SoL-Pi Efficiency | 1.3101B | 1,158 | 42.224 | 0.5376 |
| Opus 5 | SoL-Pi Performance | 2.1016B | 1,605 | 50.482 | 0.6235 |
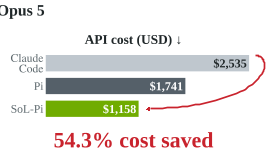
Opus 5 是 held-out backend。Table 2 显示,SoL-Pi Efficiency 的 token 总量为 1.3101B,相比 Pi 的 2.3697B 减少 44.7;成本从 1,741 降到 1,158,下降 33.5;平均分数从 44.756 到 42.224,保留约 94.3。相比 Claude Code 的 2,535 美元,SoL-Pi Efficiency 为 1,158 美元;相比 Codex 的 1,787 美元,SoL-Pi Efficiency 为 894 美元。论文的 50.0 与 54.3 成本节省即来自这里。若只看 Opus 5,SoL-Pi Performance 单机制反而把平均分推到 50.482,同时 token 总量仍低于 Pi,成本也低于 Pi,这说明某些单独发现的机制在跨后端时可能比完整效率堆栈更适合“分数优先”的配置。
论文还在 Terminal-Bench 4 和 IMO 2026 上测试泛化。Table 3 的 Terminal-Bench 4 使用 63 个 CPU-only tasks;IMO 评测使用 6 个需 Lean 4 验证的问题。
| 基准 | 指标 | Codex | Pi | SoL-Pi |
|---|---|---|---|---|
| Terminal-Bench 4 | 解决任务数 | 18 | 18 | 15 |
| Terminal-Bench 4 | 总成本 | 272.35 | 286.45 | 211.12 |
| Terminal-Bench 4 | 每解决任务成本 | 15.13 | 15.91 | 14.07 |
| IMO 2026 | 通过题数 | 5 | 3 | 3 |
| IMO 2026 | 总成本 | 114.47 | 75.95 | 62.69 |
| IMO 2026 | 每通过题成本 | 22.89 | 25.32 | 20.90 |
Terminal-Bench 4 中,SoL-Pi 解决任务数少于 Codex 和 Pi,但总成本为 211.12,每解决任务成本为 14.07,低于 Pi 的 15.91。IMO 2026 中,SoL-Pi 与 Pi 均通过 3 题,但总成本 62.69,低于 Codex 的 114.47 和 Pi 的 75.95;每通过题成本 20.90,也低于两者。论文没有声称 SoL-Pi 在所有基准上都解决更多任务,而是主张它在单位成功上的成本更低。这一表述与前面的 token efficiency 定义一致。
第 3.3 节的多智能体 kernel optimization 实验提供了另一个角度。三个配置各自运行两小时:单个 Codex agent、20 个 Pi baseline workers 的 Codex coordinator swarm、20 个 SoL-Pi workers 的 Codex coordinator swarm。起点需要 147,734 cycles。Figure 5(b) 显示,SoL-Pi swarm 达到 1,127 cycles,成本 60.11 美元;单 agent 为 1,333 cycles,成本 39.20 美元;Pi baseline swarm 为 1,366 cycles,成本 82.12 美元。SoL-Pi swarm 比 Pi baseline swarm 成本减少 26.8。最终候选都通过官方 correctness check;SoL-Pi swarm 和单 agent 通过全部八个速度阈值,Pi baseline swarm 只通过七个,未通过最后少于 1,363 cycles 的阈值。
拆解证据:机制组合是互补还是简单相加
Table 4 是论文最重要的拆解证据之一。它分别比较 Pi baseline、四个单机制变体和完整 SoL-Pi Efficiency 堆栈。GPT-5.6 Sol 部分如下:
| 配置 | Token total | Cost | Avg score | Token eff |
|---|---|---|---|---|
| Pi Baseline | 2.1538B | 1,339 | 44.833 | 0.5855 |
| Plus Action Fusion | 1.8968B | 1,235 | 46.664 | 0.5190 |
| Plus Online Context Compact | 1.2881B | 935 | 41.993 | 0.4365 |
| Plus Evidence-Preserving Reducer | 1.9375B | 1,200 | 44.630 | 0.5274 |
| Plus ObservationPack | 2.0224B | 1,271 | 47.208 | 0.5280 |
| SoL-Pi Efficiency | 1.0990B | 894 | 42.003 | 0.4174 |
Table 4 的每个单机制配置都降低了 token total,但分数变化不同。Online Context Compact 单独加入时 token 降到 1.2881B,成本降到 935,但平均分 41.993;ObservationPack 单独加入时平均分达到 47.208;Action Fusion 单独加入时 46.664。完整堆栈的 token 流量最低、成本最低,但平均分低于某些单机制点。这说明论文所谓 comparable performance 不是处处最高分,而是四机制组合在能力容忍门下保留足够质量的同时最大化效率。Opus 5 部分同样显示所有单机制降低 total tokens,Action Fusion 单独配置取得 50.482 平均分,完整堆栈得到 42.224 平均分但 1,158 美元成本。

Figures 6 和 7 进一步分析 activation。触发率是机制激活的任务比例,触发强度是每个激活任务上的平均触发次数。论文显示,在 Opus 5 上两个指标通常低于 GPT-5.6 Sol,这与 SoL-Pi 主要在 GPT-5.6 Sol 轨迹上被优化的事实一致。Figure 7 还比较单机制与完整堆栈:ObservationPack 在完整堆栈中变得更 selectivity,可能因为 Evidence-Preserving Reducer 已经在观察密集轨迹上先抽取了部分证据;每个机制在完整堆栈的 triggered-task subset 上都取得比单机制更大的 token efficiency gain。论文谨慎指出,这种比较只在各自触发子集上进行,并不能完全隔离交互效应。
证据质量需要分层看。主 EdgeBench 结果来自 51 个公开任务,且完整堆栈在 GPT-5.6 Sol 与 Opus 5 上保持相似的趋势,这是最强的跨模型证据。Terminal-Bench 4 和 IMO 2026 扩展到了 CPU-only terminal 和 formal proof,但任务数量分别是 63 与 6,规模较小。多智能体 swarm 结果证明 harness 效率可以在固定两小时预算下帮助更深的搜索,但它使用 simulated machine cycles,不能直接外推到所有生产系统。Action Fusion 的 27 iterations 案例则提供了机制来源证据:Figure 8 显示 oracle analysis 阶段测得 12.3 direct headroom,并投影出 11.5 token reduction under full triggering;baseline construction 阶段从 prompt-only triggering 转向扩展 tool schema,达到 87.7 usage 且 0 invalid calls。这个案例比单纯报告分数更有价值,因为它展示自动研究如何把观察变成稳定接口。
深度洞察与总结
SoL-Pi 的核心价值是把 harness 改进从人工经验转成了可审计的自动研究过程。它真正的贡献不是四个机制单独多巧妙,而是用一组严格约束让候选机制必须跨越开发环境、保留能力,再冻结后接受留出评测。Table 1 和 Table 2 的跨后端结果说明,这条流程至少没有在 GPT-5.6 Sol 到 Opus 5 的迁移中完全失败;Terminal-Bench 4 与 IMO 2026 的单位成功成本下降说明,效率收益不只在 EdgeBench 上成立。Action Fusion 的案例进一步显示,auto-research 可以发展 mechanism-specific intermediate metrics,例如 trigger rate,而不只是追逐 end-task score。
局限性也很具体。第一,SoL-Pi 的 harness 主要在 GPT-5.6 Sol 轨迹上搜索得到,论文没有报告在 Opus 5 上重新训练或重新选择超参;Opus 5 下触发率和触发强度更低,意味着部分机制的收益依赖于源模型行为。第二,论文明确说约 150 个方向、500 多个环境、3,000 多次运行的数字只描述搜索范围,不构成 scaling law;因此我们无法从这篇论文判断搜索宽度翻倍、环境数量翻倍是否还会稳定提升机制质量。第三,EdgeBench 当前公开 134 任务中的 51 个,最终泛化又只用其中 40 个,留出规模有限;11 个用于接受检查的任务也可能引入选择压力。第四,所有成本使用 2026 年 8 月 17 日的 API 价格,若价格或模型服务行为变化,token 成本比可能变化。
未来最值得检验的,是论文第 5.1 节提出的 pretraining the harness 和 recursive efficient improvement。前者要求把多个后端、多个任务族的轨迹当作预训练信号,而不是只在一个模型上优化 harness;后者要求把 SoL-Pi 本身作为下一轮 auto-research 的起点,用降低后的每次运行成本去覆盖更多环境和更多候选。若这两步能稳定成立,harness 就不再是手工配置,而会变成一个可版本化、可继承、可跨模型蒸馏的系统层;如果它们不能成立,SoL-Pi 的主要贡献则更接近一次严谨的自动研究流程设计,而不是普遍性的自我改进机制。