
SPAR:重塑学术搜索,像科学家一样在文献海洋中“深潜”
SPAR: Scholar Paper Retrieval with LLM-based Agents for Enhanced Academic Search
本文提出了 SPAR,一个基于大语言模型(LLM)多智能体协作的学术文献检索框架。通过引入引用链(RefChain)探索、查询演化和多源检索机制,SPAR 在 AutoScholar 和新提出的 SPARBench 基准测试上分别实现了 +56% 和 +23% 的 F1 分数提升,达到了 SOTA 水平。
TL;DR
传统的学术搜索正面临“意图鸿沟”:用户想要的是对某个特定技术演进的深度总结,而搜索引擎只给了关键词匹配。BAAI(智源研究院)提出的 SPAR (Scholar Paper Retrieval) 框架,通过模拟科研人员**“看综述 -> 追引用 -> 调方向”**的真实思维流程,利用多智能体协作实现了检索性能的跨越式提升。
背景:为什么学术检索不能只靠“搜关键词”?
每一个做过文献调研的研究员都知道,最核心的论文往往不是通过第一个搜素框找到的,而是通过论文末尾的 References 顺藤摸瓜发现的。然而,现有的 LLM 检索工具往往忽略了这种“引用链”(Reference Chain)的结构化价值。
此外,现有的方案(如 PaSa)往往需要通过繁琐的强化学习(RL)来训练模型控制搜索深度,这不仅成本高,且换一个学科领域(如从 AI 换到生物学)往往就会失效。
核心机制:SPAR 的多智能体协作之道
SPAR 抛弃了复杂的训练过程,转而采用一种“模块化、即插即用”的智能体架构。
1. 意图拆解与多源路由
Query Understanding Agent 不再直接拿着原始查询去搜,而是先判断:这是一个综述请求吗?有时间限制吗?接着,它将任务分发给 Google Scholar, OpenAlex, PubMed 等最合适的数据库。
2. RefChain:单层引用扩展
SPAR 引入了 RefChain 机制。为了在“全覆盖”和“噪音控制”之间取得平衡,SPAR 被设计为只向下追溯一层引用。这有效地解决了深度递归带来的语义漂移问题。
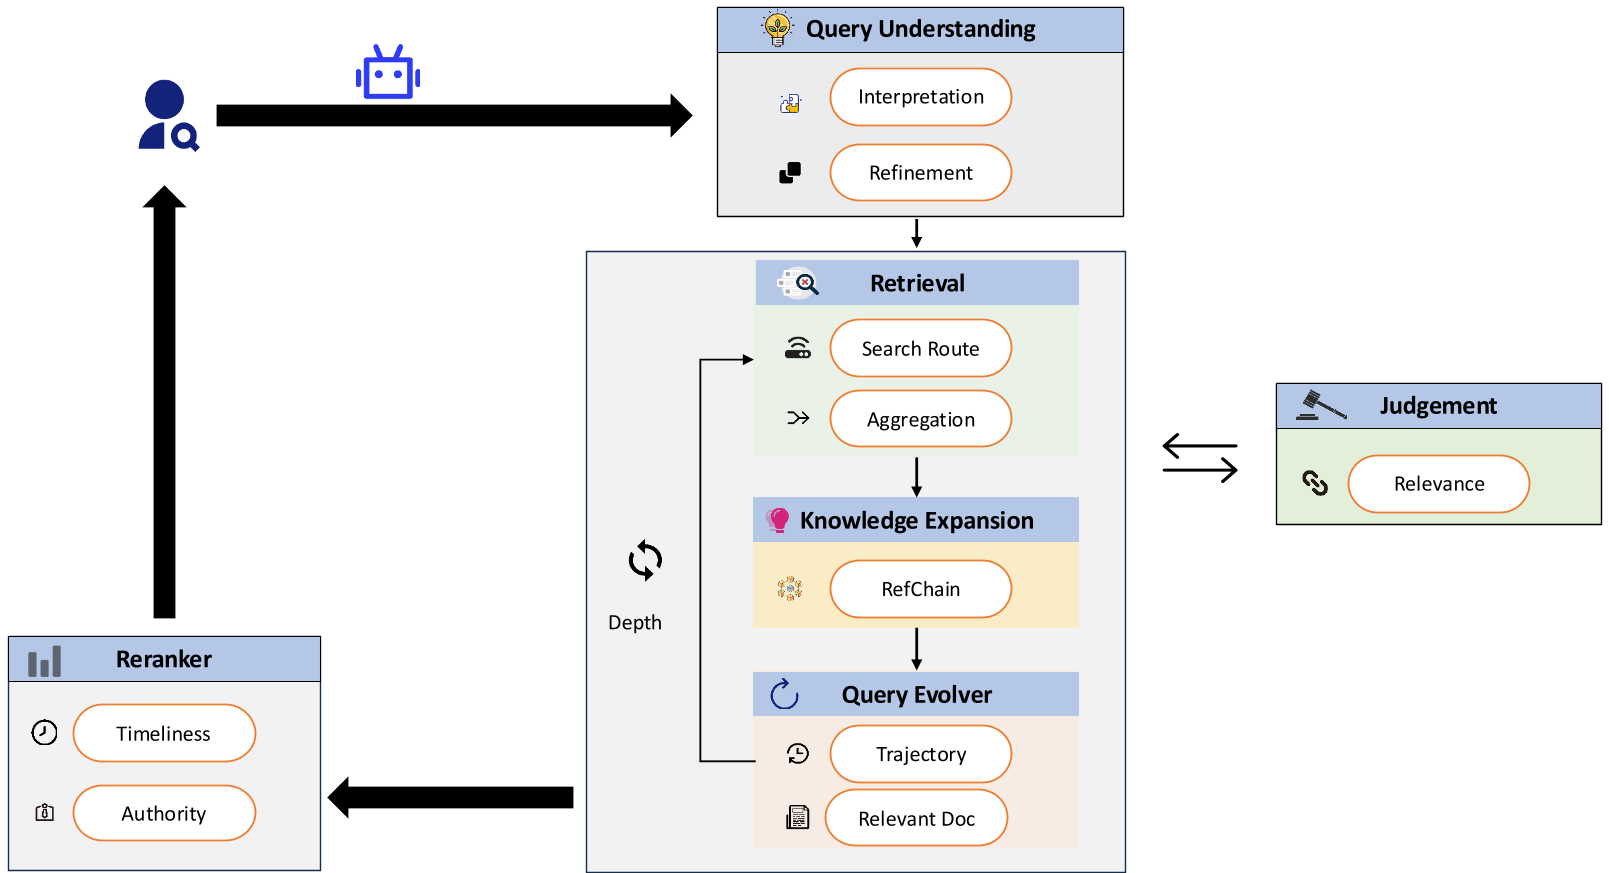 图 1:SPAR 框架概览,展示了从查询理解到迭代检索、再到重排序的完整生命周期。
3. Query Evolution:启发式搜索
这是 SPAR 最具“灵性”的设计。Query Evolver Agent 会分析当前搜到的高价值论文,自动生成三个新维度:
- 方法论对比:有没有替代算法?
- 应用场景:这东西在其他领域怎么用?
- 局限性分析:前人的研究坑在哪里? 这种动态演化确保了搜索轨迹能够随着发现的新知识而不断修正方向。
实验战绩:全方位的 SOTA
为了验证真实场景下的表现,作者不仅在合成数据集 AutoScholar 上刷出了新高度,还推出了 SPARBench——一个涵盖计算机科学和生物医学、由领域专家人工标注的极具挑战性的基准测试。
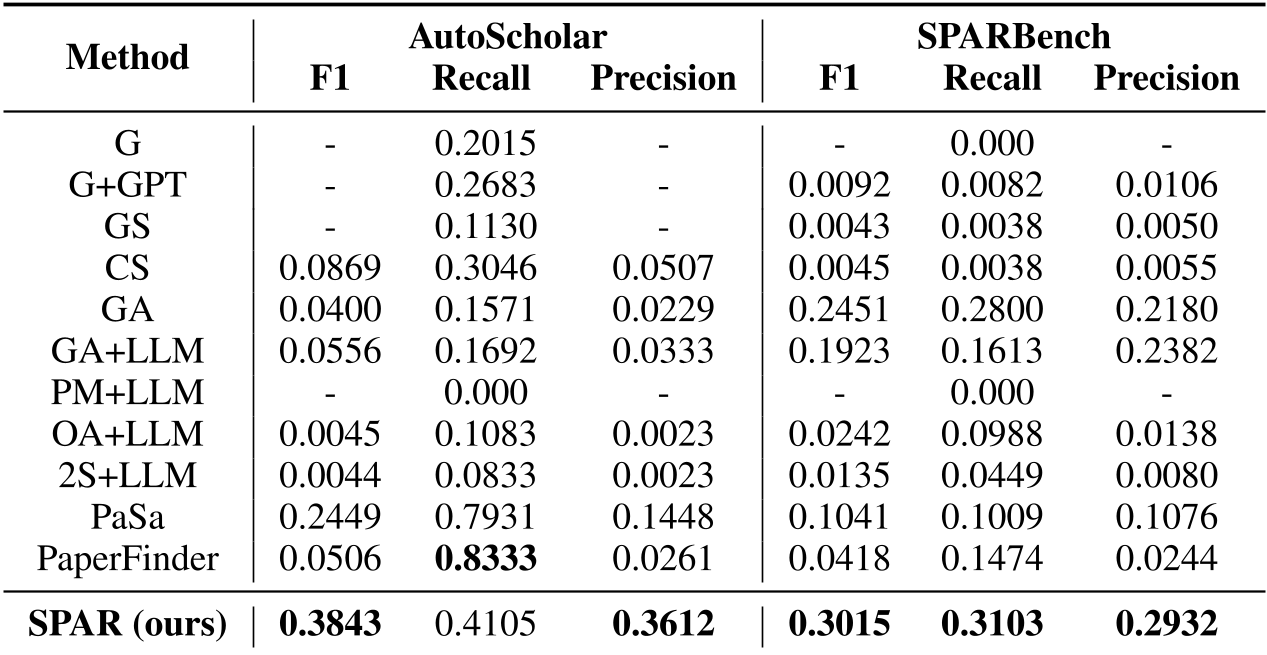 表 1:SPAR 与各大基线的对比。可以看到,传统 Google 搜索在复杂学术意图下 Recall 极低,而 PaperFinder 虽然 Recall 高但 Precision 惨不忍睹,SPAR 达成了完美的平衡。
关键发现
- Reranking 的价值:引入权威性(如 Venue 影响力)和时效性信号后,Recall@5 提升了 27.6%。
- 模型选择:实验发现 Qwen3-32B 在学术评判任务中表现出了优于许多更大规模模型的性价比。
深度洞察
SPAR 的成功揭示了一个 AI Agent 领域的重要趋势:Symbolic Planning(符号化规划,如 RefChain)与 LLM Reasoning 的结合优于端到端的黑盒模型。
科研场景需要的不是一个“猜你喜欢”的推荐系统,而是一个能够自圆其说、路径可追溯的“自动化助手”。尽管目前 SPAR 还受限于单层引用深度,但其模块化的设计为未来引入用户反馈和长程推理打下了坚实基础。
总结
SPAR 不仅是一个工具,它更定义了下一代学术搜索引擎的标准:多源集成、引用敏感、动态演化。对于身处信息爆炸时代的科研工作者而言,这或许就是通往“文献自由”的钥匙。