
STDF:摆脱光流束缚,开启压缩视频增强的高效新时代
Spatio-temporal deformable convolution for compressed video quality enhancement
本文提出了 STDF,一种用于压缩视频质量增强的高效时空可变形融合方案。该方法弃用了传统的显式光流估计,转而通过时空可变形卷积(STDC)在单一操作中聚合多帧互补信息,在 HEVC 压缩视频上达到了 SOTA 的增强效果。
TL;DR
针对视频压缩带来的“马赛克”和“模糊”痛点,本文提出了时空可变形融合(STDF)框架。它通过创新的时空可变形卷积(STDC),将传统复杂的“光流对齐+融合”流程简化为一步到位的采样偏移学习。实验结果显示,该方法在提升视频画质(PSNR +0.75dB)的同时,保持了极高的推理效率,是目前 VQE (Video Quality Enhancement) 领域的佼佼者。
核心痛点:光流在压缩伪影面前的“无力感”
在视频处理中,利用相邻帧(Reference Frames)来修复当前帧(Target Frame)是共识。但传统的做法(如 MFQE 1.0/2.0)通常分为两步:
- 显式对齐:通过光流法预测像素移动。
- 特征融合:基于对齐后的结果进行合并。
致命伤在哪?
- 伪影干扰:低比特率压缩会导致画面内容严重扭曲,像素间的对应关系被破坏,导致光流估计结果充满噪声。
- 效率低下:光流需要对每一对参考帧进行独立计算,极其耗时且无法兼顾长距离的时空上下文关系。
方法论详解:从“硬对齐”到“软采样”
STDF 的核心直觉是:既然光流对不准,为什么不让卷积核自己去找最有用的像素点?
1. 时空可变形卷积 (STDC)
不同于传统的 矩形采样,STDC 为每个采样点增加了一个学到的偏移量 。
- 空间维度:纠正物体在画面内的形变。
- 时间维度:跨越不同帧( 到 ),在三维空间中寻找最相关的上下文补丁。
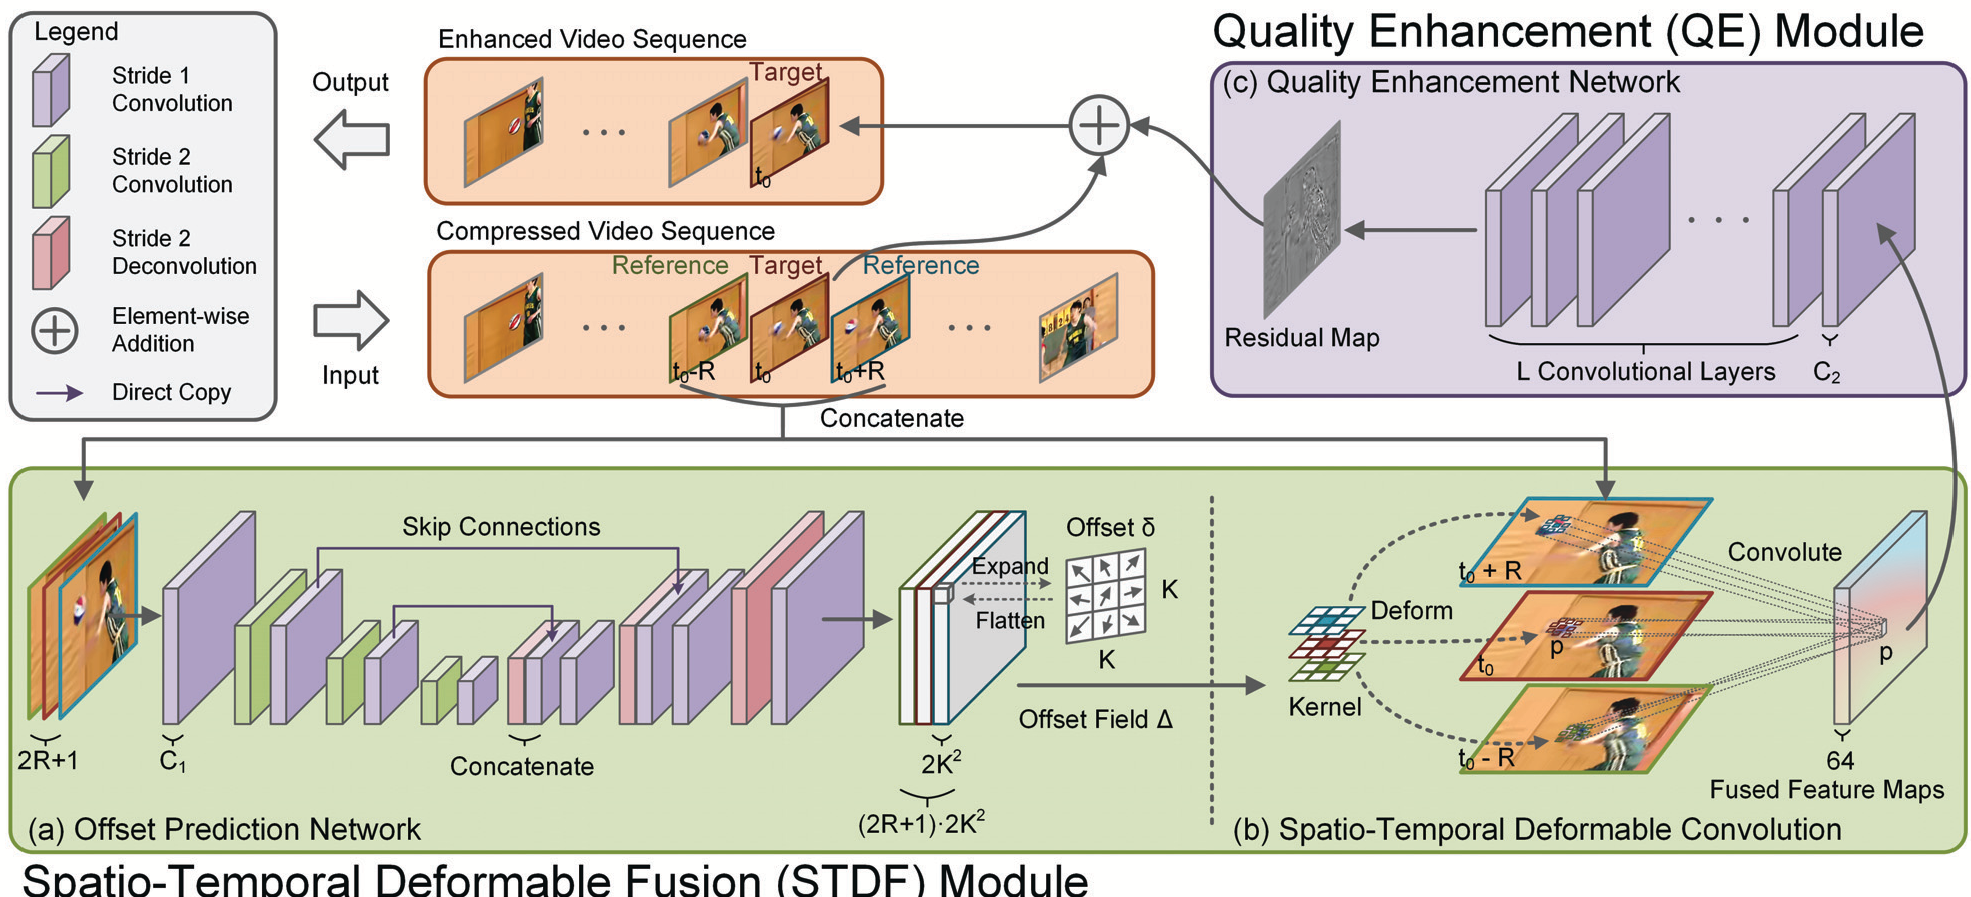 图 2:STDF 整体架构,包含偏移量预测、时空融合和质量增强三个模块。
2. 联合偏移量预测 (Joint Offset Prediction)
为了进一步提效,作者没用“逐对预测”,而是将整个视频片段(Clip)丢进一个基于 U-Net 的轻量化网络,一次性输出所有帧的偏移场。这种做法不仅考虑到了帧间的连续性(Inductive Bias),还大幅降低了计算量。
实验与结果:速度与质量的双重飞跃
SOTA 对比
在主流的 HEVC 压缩标准下,STDF 展现了极强的统治力:
- 精度:在 QP=37 时,STDF-R3 比 MFQE 2.0 的 ΔPSNR 提升了 34%。
- 视觉效果:从下图可以看出,对比 image-based 方法带来的过度平滑,STDF 能找回更多真实的纹理细节(如织物褶皱、面性特征)。
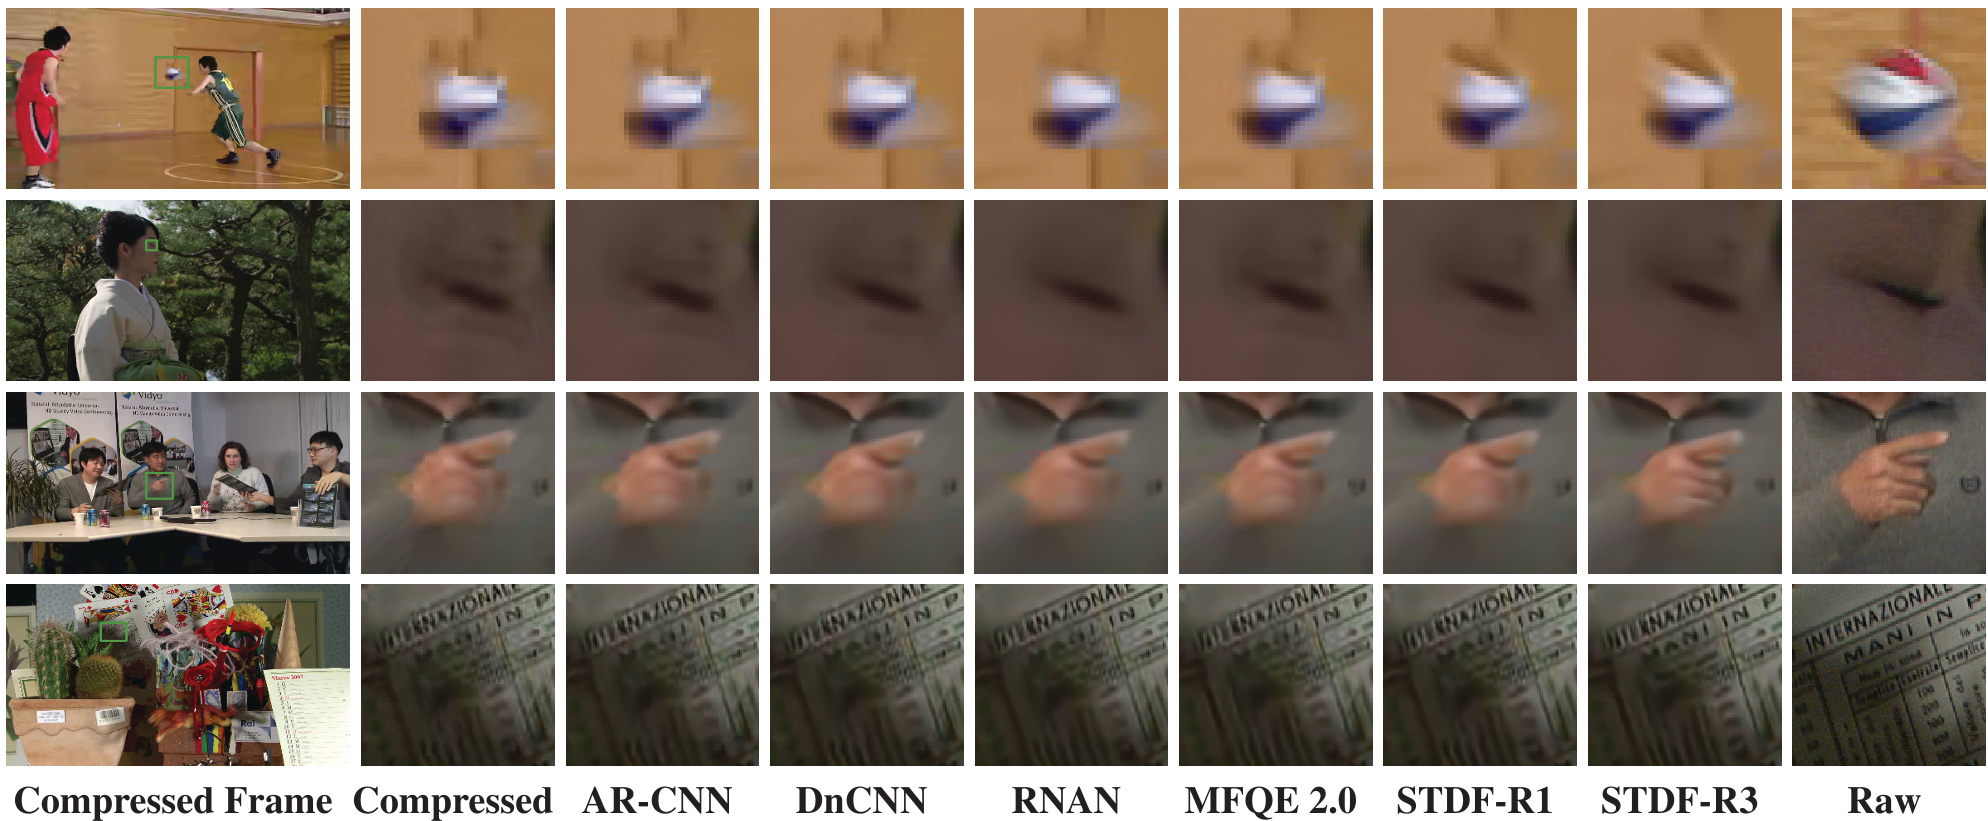 图 5:定性对比,STDF 在修复伪影的同时保留了更多的结构化边缘。
推理效率
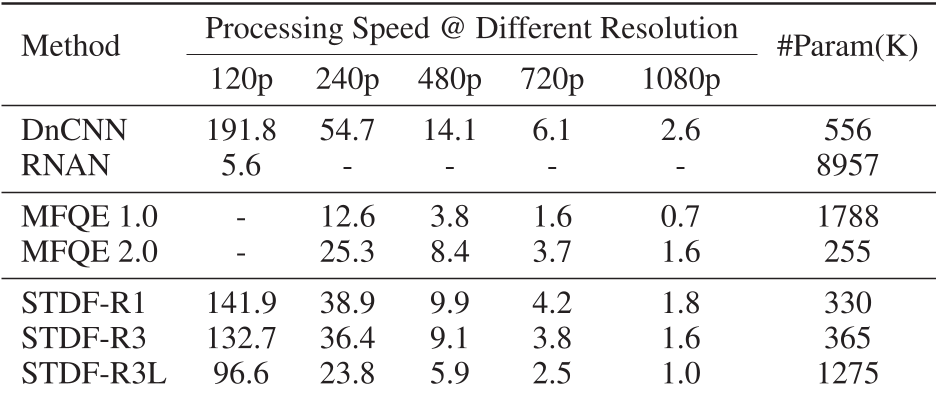
下表展示了 STDF 的工业潜力。即便在 1080p 高清视频下,STDF-R1 也能达到接近实时的处理速度,而参数量(#Param)仅为 330K。
深度洞察:为什么 STDF 有效?
作者在消融实验中揭示了一个关键点:时空联合学习的鲁棒性。 传统的 EFMC(带运动补偿的早期融合)在参考帧增多时,画质提升会遇到瓶颈甚至下降,因为光流累积误差太大。而 STDF 随着 R(参考半径)的增加,性能稳步提升。这说明其自监督采样机制能够自动过滤掉噪声帧,只锁定有效的补充信息。
总结与局限性
STDF 提出了一种极具优雅色彩的解决方案:将“运动对齐”这个疑难杂症,转化为了神经网络内部的一种采样自由度。
局限性:虽然该方法在受限的压缩视频增强中表现优异,但对于大尺度剧烈运动(超过卷积核感受野)的应对能力还有待进一步验证。
未来展望:这种时空可变形思想完全可以平移到视频超分辨率 (Video SR) 或视频修复 (Video Inpainting) 领域,作为一种通用的 Back-bone 模块。