
Saguaro:打破推测解码的串行魔咒,实现 5 倍推理加速
Speculative Speculative Decoding
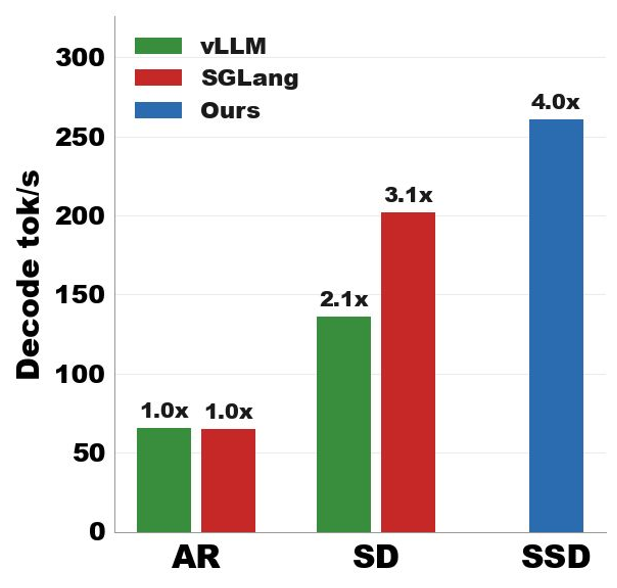
本文提出了推测性推测解码 (Speculative Speculative Decoding, SSD),一种通过将草图绘制(Drafting)与验证(Verification)过程异步并行化来加速 LLM 推理的新框架。核心算法 Saguaro 在 Llama-3 70B 上比强基线快 30%,较传统自回归解码实现最高 5 倍加速。
TL;DR
推测解码(Speculative Decoding, SD)已经是业界公认的推理加速标准。然而,即使是 SD,模型也必须在“猜测”和“验证”之间反复横跳,无法摆脱串行依赖。本文提出的 SSD (Speculative Speculative Decoding) 框架及其优化算法 Saguaro,通过让草图模型在验证进行时“提前预料”验证结果,彻底实现了两者的并行。在 Llama-3 70B 任务上,它比目前的 SOTA 方法又快了 30%。
1. 痛点:被忽视的“验证等待期”
在传统的推测解码中,流程是:草图模型猜测 K 个 Token -> 目标模型验证。关键在于,草图模型在验证期间是停顿的。这种同步逻辑就像是一个接力赛,一个人跑的时候另一个人必须站着不动。
作者敏锐地指出:如果能让草图模型在验证进行中就开始下一轮的猜测,岂不是能白赚出这段时间?但问题是,草图模型不知道上一轮验证到底通过了几个 Token,也不知道验证失败后采样的那个“Bonus Token”是什么。
2. 核心直觉:像 CPU 一样进行“分支预测”
SSD 的灵感源自经典计算机架构中的“推测执行”。既然不知道验证结果,那就全都要。草图模型不再只猜一种可能,而是构建一个推测缓存(Speculation Cache),涵盖所有可能的验证结局:
- 结局 1:验证通过 0 个,Bonus Token 是 A。
- 结局 2:验证通过 1 个,Bonus Token 是 B。
- ...以此类推。
当验证结果传回时,如果命中了缓存中的某个结局,下一轮的猜测直接就能拿来用,推测延迟被压缩到了几乎为零。
3. Saguaro 算法的三大杀手锏
3.1 几何扇出 (Geometric Fan-Out)
由于验证 outcomes 的数量庞大(Token 数 × 词表大小),盲目预测所有分支是不现实的。Saguaro 利用数学推导发现:验证接受的路径长度遵循几何分布。因此,它在大概率发生的路径上分配更多的“扇出”(即猜测更多的潜在 Bonus Token),而在小概率路径上保持稀疏。这种分配策略在数学上被证明能最大化缓存命中率。
3.2 缓存感知采样 (Saguaro Sampling)
这是本文最精妙的设计。验证失败后的“Bonus Token”通常很难猜,因为它来自目标分布与草图分布的残差。Saguaro 提出了一种采样方案:主动压低草图模型在 Top-K Token 上的概率。这听起来反直觉,但根据残差分布公式,这反而会使目标模型的残差质量集中在这些 Top-K Token 上,从而人为地提高了缓存命中率。
3.3 异步并行计算架构
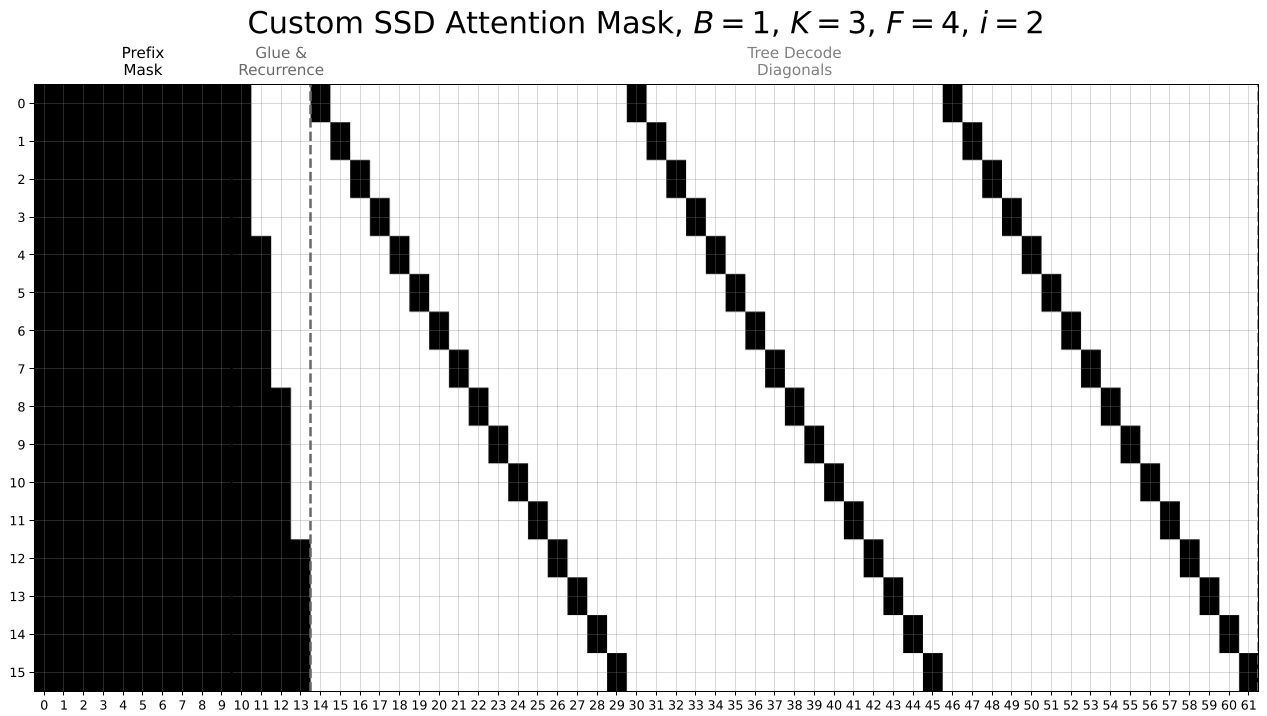
为了实现这一目标,Saguaro 需要在不同的硬件(如不同的 GPU)上部署草图和目标模型。作者开发了定制化的 Sparse Attention Mask,允许草图模型在一个 Batch 内并行处理所有分叉路径,充分压榨 GPU 的算力。
4. 实验战绩:SOTA 之上的再次突破
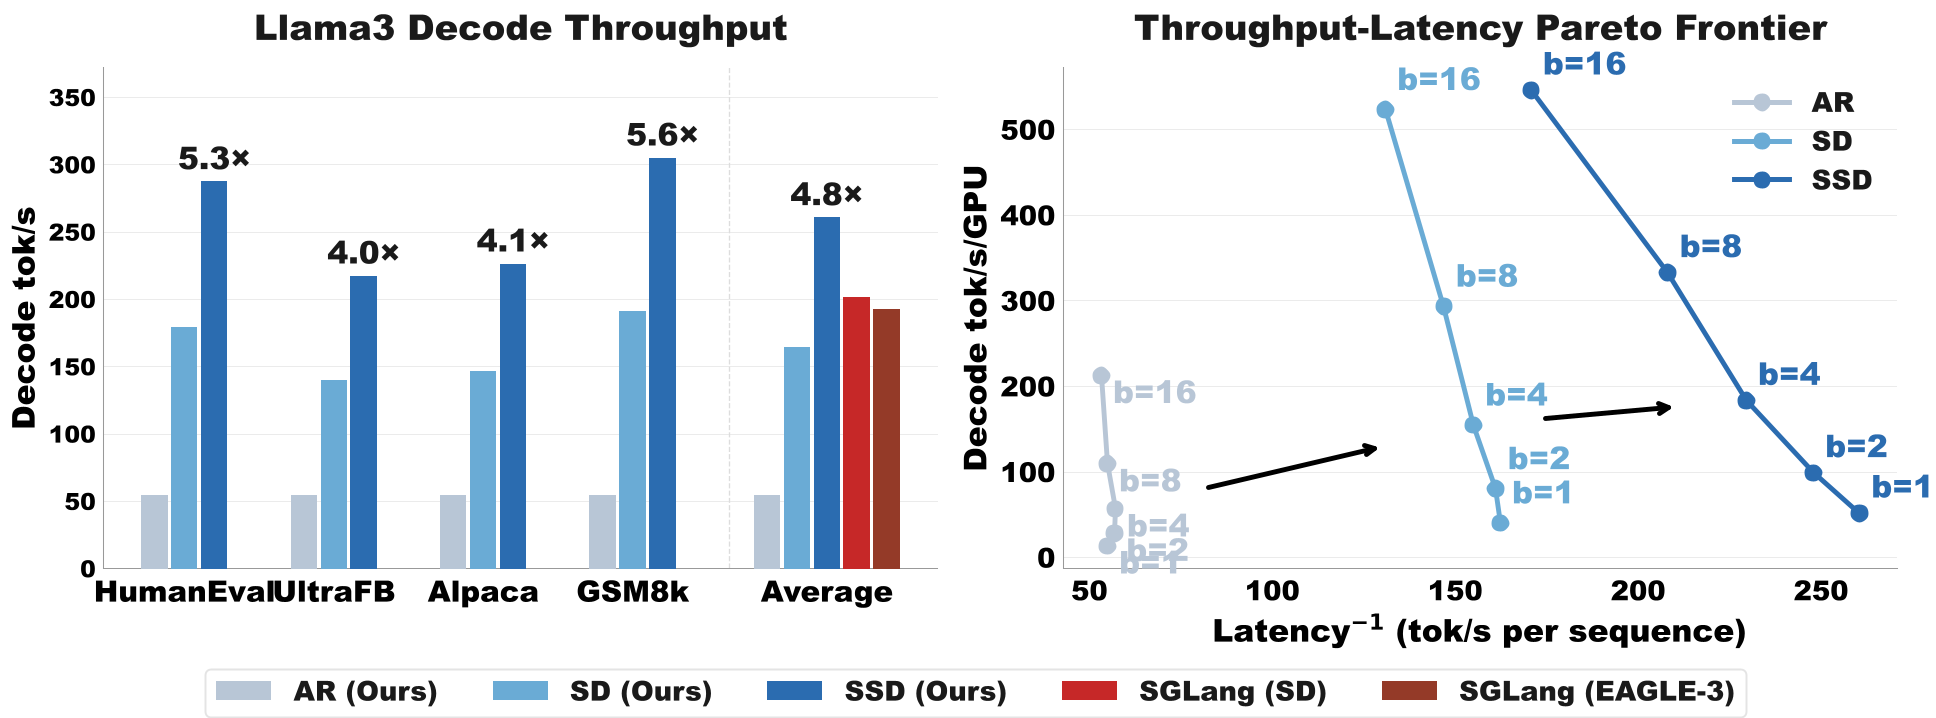
在 Llama-3.1-70B 上的测试显示,Saguaro 不仅稳赢传统的自回归解码(5x 加速),也显著优于 SGLang 和 vLLM 中实现的最新推测解码方案。
- 平均提速:30%(相比于最强 SD 基线)。
- 帕累托前沿:以往的 SD 是用算力换低延迟,往往会牺牲吞吐量。SSD 却能在提升低延迟性能的同时,保持甚至优化吞吐量表现,证明了其架构的高效性。
5. 总结与启示
SSD 的意义在于,它将 LLM 推理系统的优化目标从单纯的“算法接受率(Acceptance Rate)”扩展到了“系统异步性(Asynchrony)”。
关键启示:
- 硬件红利:算力正在变得廉价,而内存访问和串行延迟是真正的敌人。用额外的浮点运算(多分支猜测)来换取关键路径上的延迟压缩,在 H100 时代是极其划算的交易。
- 无损保证:正如传统的推测解码,SSD 依然是无损的,其最终输出的分布与单纯的目标模型完全一致。
虽然该方法增加了计算负担和显存占用,但对于对延迟极其敏感的应用场景(如实时交互式 AI 助手),Saguaro 无疑开辟了一条通往极速推理的新路径。