
Speculative Thinking:从小模型“瞎想”到大模型“领航”的思维跃迁
Speculative Thinking: Enhancing Small-Model Reasoning with Large Model Guidance at Inference Time
本文提出了 Speculative Thinking,一个无需训练的推理增强框架。该方法借鉴了推测解码(Speculative Decoding)的思想,但在推理逻辑层面而非 Token 层面运作:通过让小模型负责大部分生成,并在关键的“反思”节点(如出现 "
wait" 时)由大模型介入指导,显著提升了小模型的推理准确率并缩短了输出长度。
TL;DR
在推理模型的竞赛中,小模型往往因为“想太多而做不对”导致效率低下。本文提出的 Speculative Thinking 是一种创新的推理时(Inference-time)协作框架。它不需要任何训练,仅通过捕捉模型输出中的结构化信号(如换行符和反思词),在关键时刻让大模型为小模型“扶一下舵”。结果不仅准确率大幅提升,输出也变得更加短小精悍。
1. 痛点:小模型的“低效反思”
当前的推理模型(Reasoning Models)如 DeepSeek-R1 系列,虽然在蒸馏后具备了思考能力,但 1.5B 或 7B 的小模型在处理复杂难题时,经常会出现无效回溯。
- 现象:小模型会不断输出 "wait..."、"alternatively...",导致推理链极长,但最终还是导向错误答案。
- 直觉 (Insight):作者观察到,模型在遇到 `
`(双换行)后接反思词(如 "wait")时,往往处于逻辑分叉点。小模型在这里容易走错路,而大模型则能精准地回归正轨。
2. 核心机制:什么时候该“大模型出手”?
Speculative Thinking 并不像传统的推测解码(Speculative Decoding)那样在每一个 Token 上纠结,它看重的是语义块的决策。
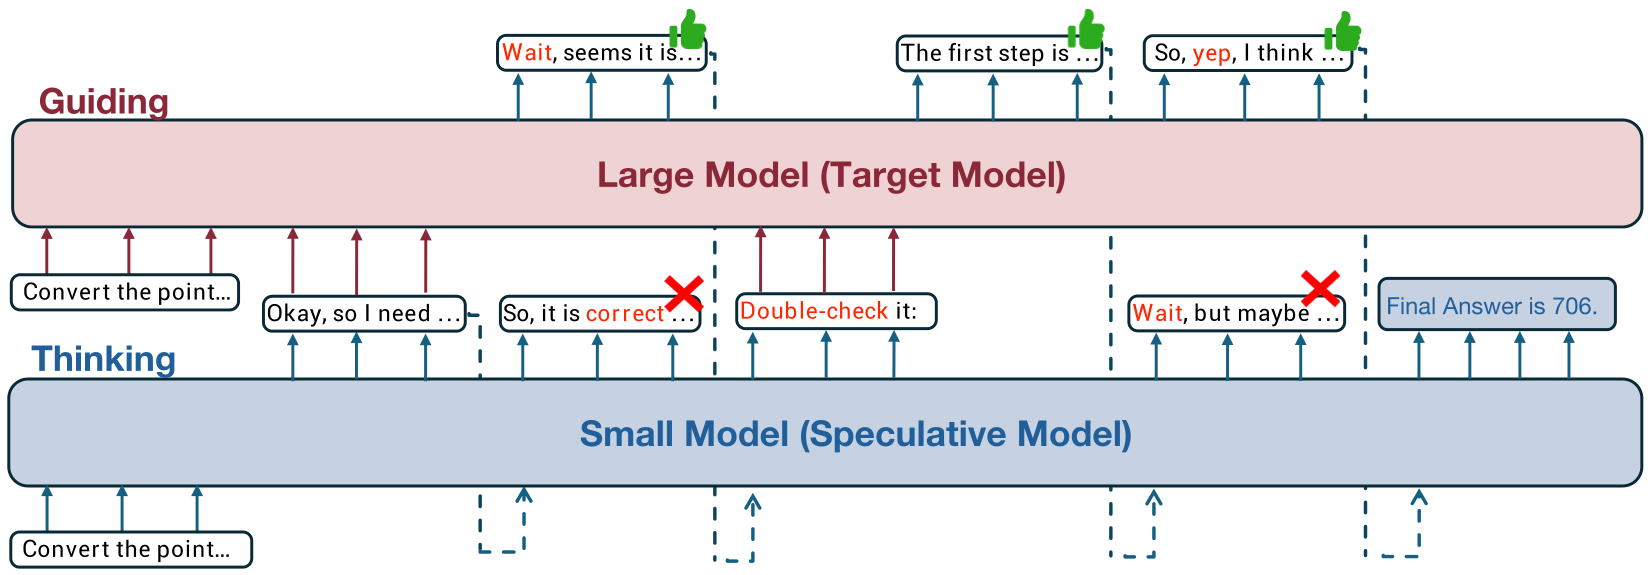 图 1:Speculative Thinking 整体框架,展示了小模型自主生成与大模型介入的逻辑。
框架设计了三道防线:
- 反思接管 (Reflection Takeover):一旦小模型说出“等一下”,大模型立即接过笔头写接下来的 20 个 Token,确保反思是有意义的。
- 验证接管 (Verification Takeover):检测到 "verify" 或 "check" 等行动词时,由大模型完成核心验证逻辑。
- 循环打破 (Loop Breaking):如果小模型反思次数超过阈值(如 15 次),大模型暴力介入,强行止损。
3. 实验战绩:更高、更短、更快
该方法在 MATH500、AIME、GPQA 等硬核推理榜单上展现了惊人的效果。
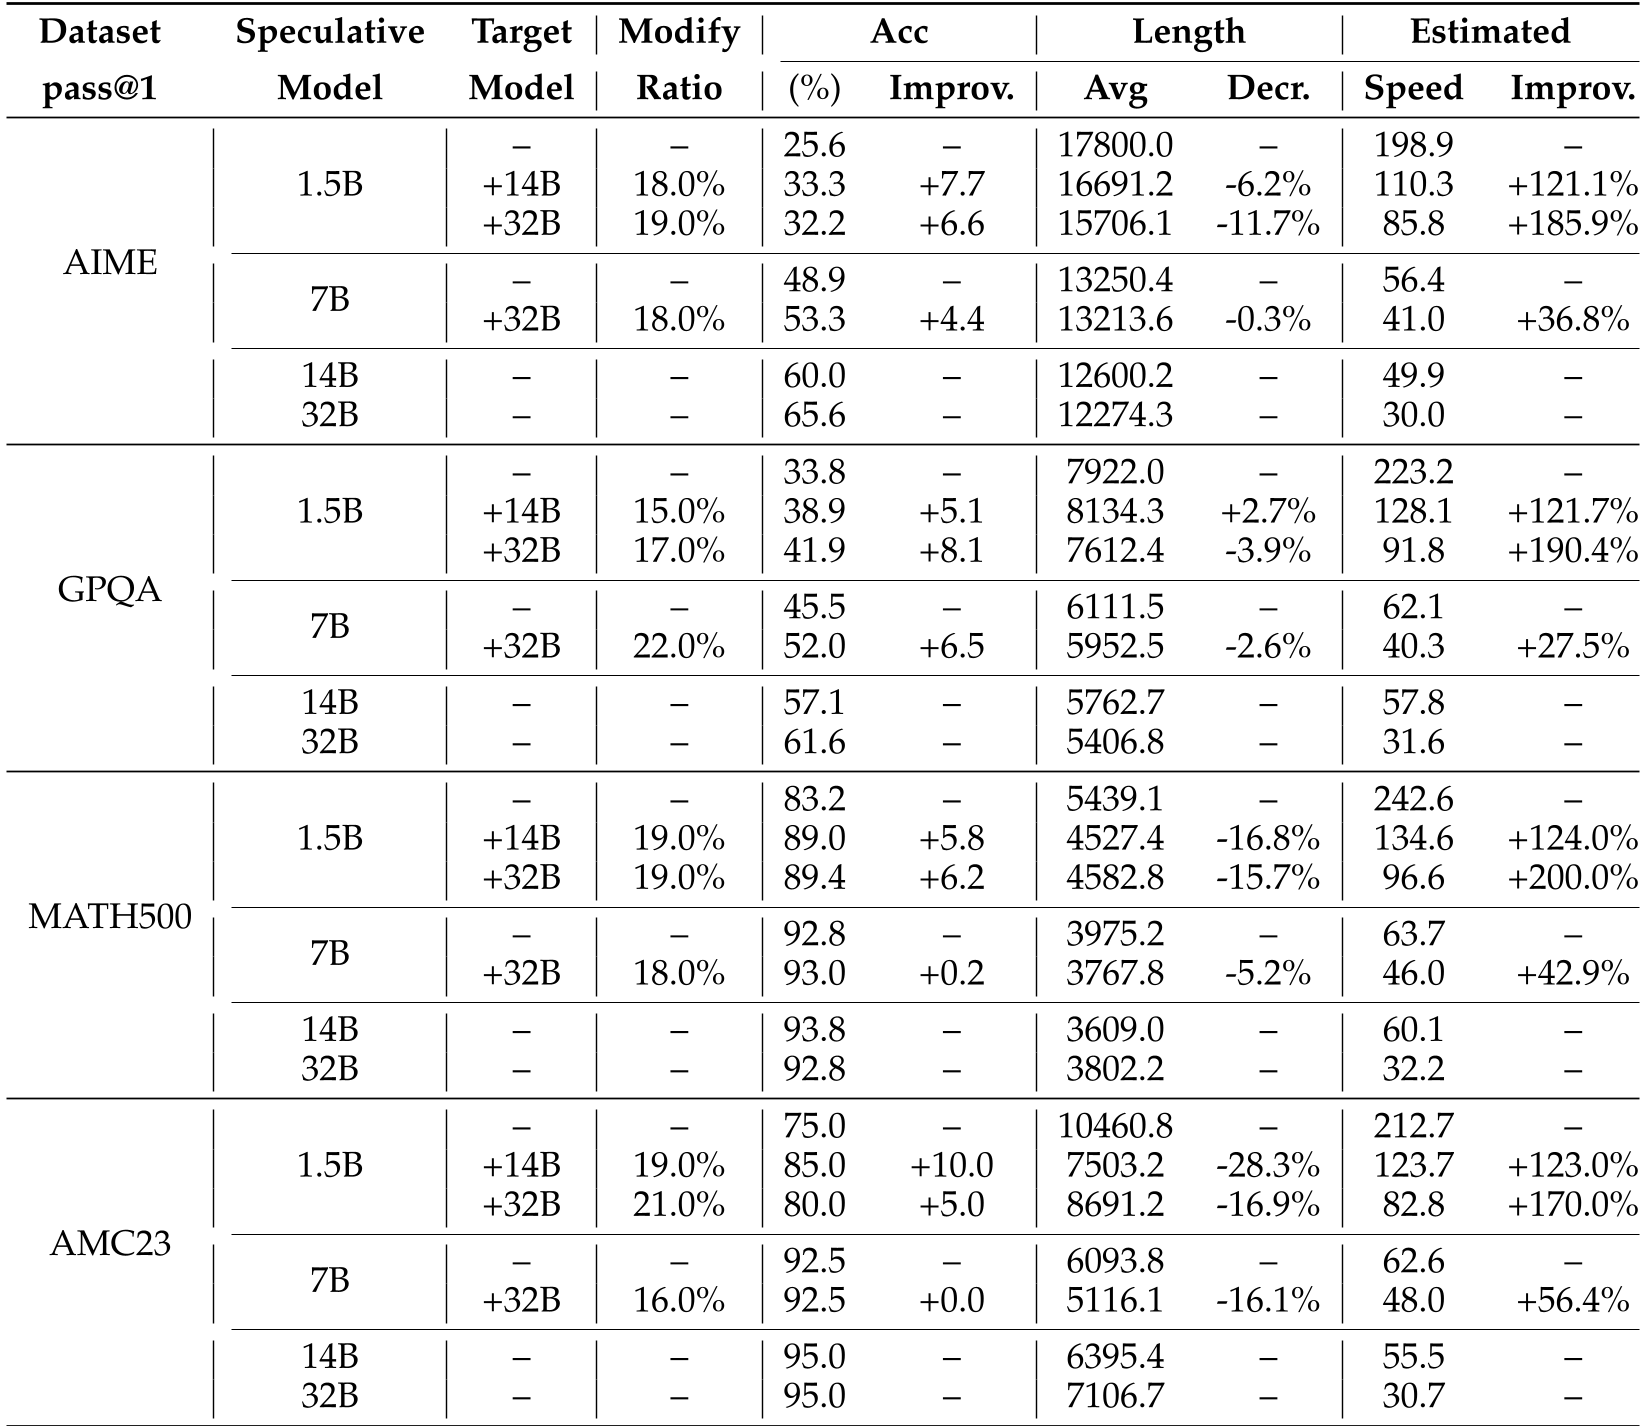 表 1:1.5B 小模型在 32B 大模型辅助下的性能提升,准确率提升最高达 8.1%,长度反而缩短。
关键发现:
- 并非参数量越大越好:1.5B 小模型配合 32B 指导,由于输出大幅精简,预估推理速度比纯 32B 模型快得多。
- 非推理模型也受益:即使是像 Qwen-2.5-7B-Instruct 这种没有专门做过 Reasoning 训练的模型,在 Speculative Thinking 的框架下,MATH500 准确率也从 74% 跃升至 81.8%。
4. 深度洞察:为什么这种协作有效?
小模型之所以效果差,不是因为它完全不会推理,而是因为它在**决策点(Decision Points)**的熵过高,容易陷入死循环。
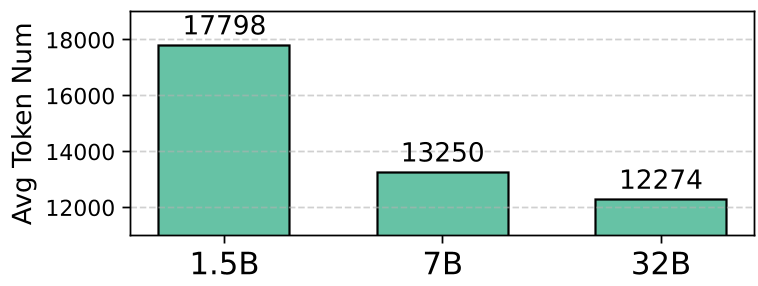 图 2:不同规模模型的准确率与输出长度对比。可见:模型越小,错题写得越长。
通过让大模型在关键接缝处(Structural Cues)提供“高确定性”的引导,小模型被拉回了高概率的正确路径上。这种“分工明确”的架构,比强行让小模型模仿大模型的每一位概率分布(Distillation)要更具鲁棒性。
5. 总结与局限
Speculative Thinking 证明了推理效率化的一个新方向:按需调用高质量计算。
- 优点:零重训成本、跨模型族通用(甚至 Llama 能带 Qwen)、显著降低 Token 消耗。
- 局限性:目前对结构化提示(如 `
`)有一定依赖,且干预所需的超参数(如干预 Token 长度)仍需针对不同领域进行微调。
这篇论文为未来的端云协同推理(Edge-Cloud Collaboration)提供了极佳的范式参考。