
伪奖励的奇迹:RLVR 真的在教模型学习推理吗?
Spurious Rewards: Rethinking Training Signals in RLVR
本文提出了针对大模型强化学习(RLVR)中奖励信号机制的重新思考。研究发现,在 Qwen2.5-Math 等模型上,即使使用随机奖励、错误标签或仅奖励格式等“伪奖励”(Spurious Rewards),也能显著提升数学推理性能(如 MATH-500 提升达 21.4%-27.1%),几乎追平真实奖励的效果。
TL;DR
华盛顿大学等机构的最新研究抛出了一个深水炸弹:在流行的 Qwen2.5-Math 模型上进行强化学习(RLVR),哪怕你给它的是完全随机的奖励或者错误的答案标签,模型的数学能力依然能暴涨 20% 以上。这表明,目前的强化学习可能只是“唤醒”了模型预训练中沉睡的某种能力,而非真正教它学会了数学。
背景定位:学术界的“Qwen 依赖症”
在 RLVR(带验证奖励的强化学习)领域,Qwen2.5-Math 几乎成了 SOTA 论文的标配基座。然而,本文指出这种繁荣背后隐藏着巨大的认知偏差:如果一个方法只在 Qwen 上有效,那它到底是算法的功劳,还是 Qwen 预训练数据的功劳?
痛点深挖:奖励信号真的是必要的吗?
传统观念认为,RLVR 强是因为它提供了 100% 正确的二元奖励。但作者实验发现:
- 随机奖励(Random):掷硬币决定对错,Qwen 照样进步。
- 错误奖励(Incorrect):只在模型答错时给奖励,模型竟然也变强了。
- 格式奖励(Format):只要模型写出
\boxed{}就给奖,不管里面填的啥。
这些荒唐的信号在 Qwen 上都奏效了。为什么?
核心机制:代码推理的“唤醒”
作者通过对推理链(CoT)的深度分析发现了一个关键模式:Code Reasoning(代码推理)。Qwen 在预训练中学习了大量 Python 辅助数学题的逻辑。
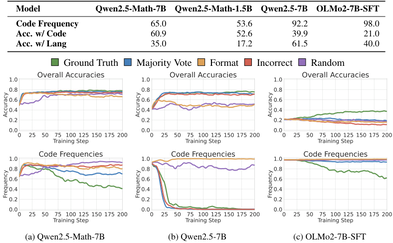
为什么伪奖励能奏效?
- 策略上调 (Up-weighting):模型在预训练时就知道“写代码”比“纯文字”更容易答对。即使是随机奖励,由于 GRPO 优化器中的 Clipping Bias(截断偏置),那些初始概率较高的优质模式(如代码块)会被算法自动加强。
- 算法副作用:GRPO 的偏置本质上是一种“保守主义”,它倾向于让模型缩在已有的高概率区,而 Qwen 的高概率区恰好是高效的代码推理。
实验结果:模型间的残酷鸿沟
研究对比了 Llama3、OLMo2 和 Qwen。结果显示,伪奖励的奇迹无法复制。
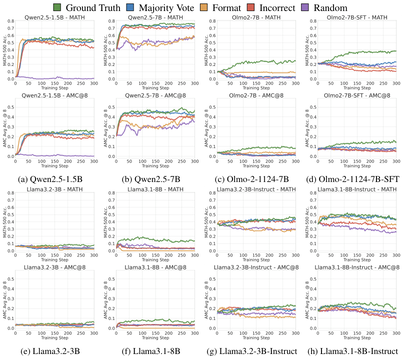
- Qwen 家族:对奖励质量极度不敏感,哪怕信号全是噪音也能起飞。
- Llama & OLMo:对奖励质量极其敏感,没有真奖励不仅不进步,甚至会学废。
这说明 Qwen 的高性能在很大程度上源于其预训练阶段嵌入的“代码思考”先验,而 RLVR 只是把这种先验从 65% 的出现频率压榨到了 90% 以上。
深度洞察:我们是否在自嗨?
本文对当前 RL 技术路径提出了尖锐的批评:
- 基准测试的偏见:如果只用 Qwen 做实验,研究者可能会误以为某种新型 RL 算法非常牛,但实际上它可能只是更会“催眠”Qwen 罢了。
- 诱导而非教育 (Elicitation vs. Learning):目前的开源 RL 流程更像是在做“提示工程的参数化”,并没有从零构建出新的逻辑推理能力。
总结与局限
Takeaway:RLVR 的成功高度依赖于基座模型的预训练分布。 局限性:本文主要探讨了数学领域和代码推理模式,对于更复杂的逻辑归纳或纯语言推理任务,伪奖励是否依然有效仍需验证。
给开发者的建议:如果你在基于 Qwen 做 RL 训练,记得加一个“随机奖励”作为 Baseline。如果你的算法连随机奖励都打不过,那可能需要重新审视你的算法创新了。