
释放 SIMD 的威力:多变量公钥密码 (MPKCs) 的向量化加速之路
SSE implementation of multivariate PKCs on modern x86 CPUs
本文探讨了多变量公钥密码系统 (MPKCs) 在现代 x86 CPU 上的高效实现,提出了利用 SSE2/SSSE3 指令集加速二进制域与小素数奇数域(如 F31)运算的方法。核心贡献在于通过 SIMD 技术将 Rainbow 和 TTS 等算法的性能提升了 4 倍以上,证明了 MPKCs 在后量子时代相比 ECC 和 RSA 具有显著的性能优势。
TL;DR
在后量子密码学 (PQC) 的阵地中,多变量公钥密码 (MPKCs) 一直以其极快的运算速度著称。本文深度分析了如何通过 x86 架构的 SSE2 和 SSSE3 指令集,对 Rainbow、TTS 及 HFE 等算法进行极致优化。通过引入 F31 奇数域 替代传统的二进制域,并结合 Wiedemann 迭代求解器,研究者在性能上实现了对 RSA 和 ECC 的降维打击。
核心速览
多变量密码学在 21 世纪初曾风靡一时,但随着 CPU 架构向 64 位大位宽和复杂流水线演进,传统的 MPKC 实现因频繁的内存查表逐渐遭遇瓶颈。本文作者通过对微架构底层指令的精确操控,证明了 SIMD(单指令多数据流) 并非 ECC 的专利,MPKCs 同样可以通过向量化指令重获新生。
痛点与动机:为什么 MPKC 变慢了?
过去 20 年,摩尔定律让门电路数量翻倍,但内存延迟改善缓慢。传统的 MPKC(如 F256 上的运算)依赖于小表查询(Table Look-up),在 8 位或 32 位机器上这很有效。然而:
- 向量化难题:标准的 SIMD 操作难以直接处理有限域乘法。
- 内存墙:大量的查表操作导致 cache miss,抵消了门电路带来的算术收益。
- 传统方案逆袭:ECC 开发者利用 128 位乘法器极大地加速了模运算。
作者由此萌生了一个直觉:如果能找到一组指令能并行执行查表,或者改变数学域以适配现有的整数向量指令,MPKC 是否能重回巅峰?
方法论详解:硬件感知的密码学设计
1. PSHUFB:并行查表的“银弹”
在支持 SSSE3 的架构中,PSHUFB 指令允许在 128 位寄存器内同时进行 16 个字节的并行查找。作者利用这一特性,将 F16 或 F256 的标量向量乘法分解为两次屏蔽映射和查找,速度提升了近 10 倍。
2. 拥抱 F31 奇数域
这是一个反直觉的设计。通常我们认为二进制域(XOR 运算)最快,但作者指出:
- 在 SSE2 下,128 位寄存器可以被视为 8 个 16 位的整数并行支路。
- 通过选择
q=31,可以利用PMULHW(高位字乘法)高效实现模约减。 - 延迟取模:在矩阵乘法中,可以累加多次乘积后再进行一次约减,极大地减少了开销。
(注:原文虽未提供独立架图,但核心在于利用冗余位宽处理溢出,公式为 )
3. Wiedemann 算法:迭代优于消元
在求解私钥映射中的线性方程组时,通常使用 Gaussian 消元法。但在向量化环境下,消元过程中的频繁取模会导致性能骤降。作者改用 Wiedemann 迭代法,每次只需进行向量乘法,这与 SIMD 架构完美契合。
实验与结果
实验在 Intel Core 2 (45nm) 上进行,结果令人惊叹:
| 方案 | 私钥映射耗时 (PriMap) | 公钥映射耗时 (PubMed) |
|---|---|---|
| RSA (1024 bits) | 1032.1 μs | 24.8 μs |
| ECC (256 bits) | 1006.0 μs | 1222.7 μs |
| Rainbow (F31) | 17.9 μs | 8.3 μs |
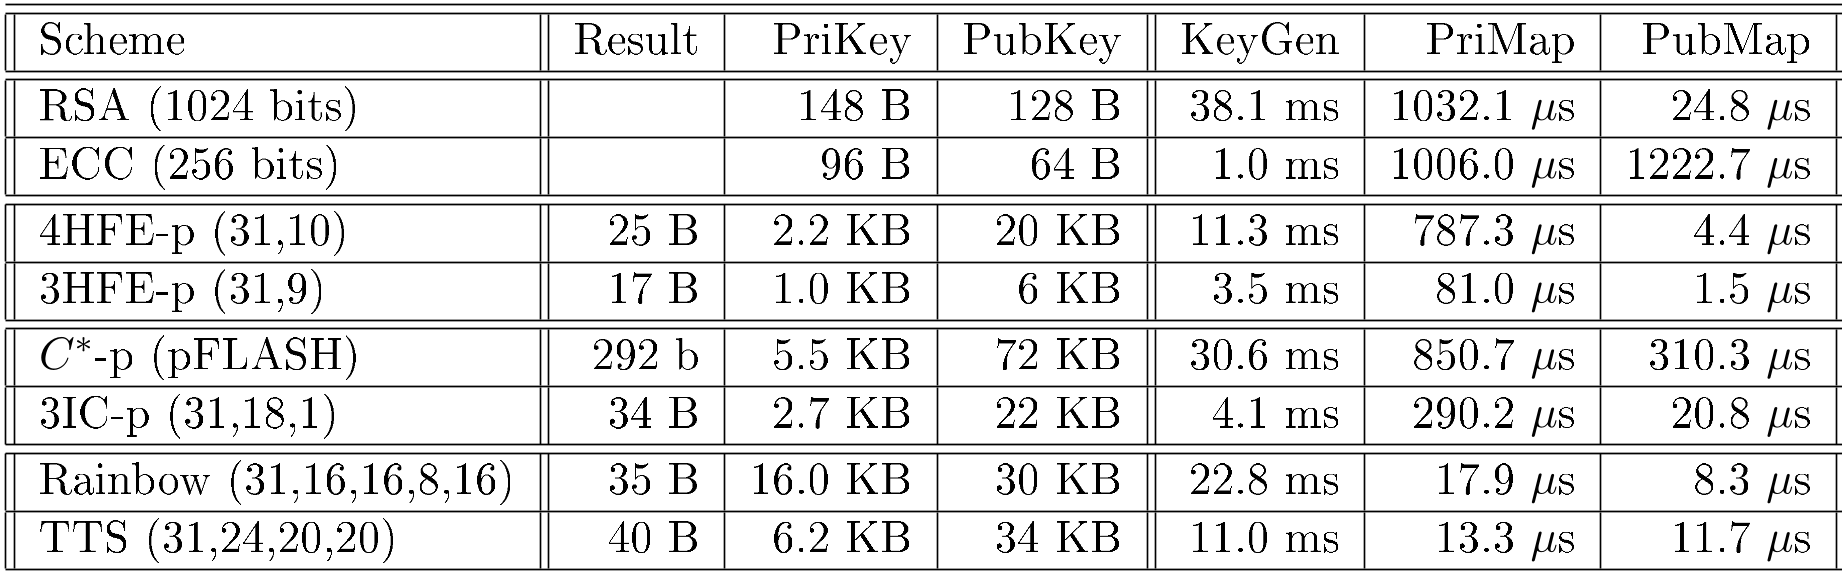
从上表可见,Rainbow 的私钥操作速度是 RSA 的 50 倍以上,显示了 MPKC 在签名速度上的极端优势。
深度洞察与总结
关键取舍
- 以算术代存储:通过计算 (q-2) 次方来求逆,虽然增加了计算量,但在向量化指令下比分散的查表更经济。
- 域的选择决定性能上限:F31 不仅在软件上快,在拥有大量 DSP 单元的 FPGA 上也具备天然优势。
结论
本论文证明了,即使面对传统 RSA/ECC 硬件加速的压力,多变量密码学通过深度适配现代 SIMD 拓扑结构,依然是目前最快的加密方案之一。对于未来基于 FPGA 或 Larrabee 架构的后量子安全实现,本研究提供的 F31 向量化框架具有极高的参考价值。
局限性
算法安全性并非本文讨论重点(如 SFLASH 已被破解),读者在应用时需结合最新的参数建议(如 TTS/7 或更高版本)以确保抗攻击强度。