
Stable-RAG:破解 RAG “排位赛”中的幻觉魔咒
Stable-RAG: Mitigating Retrieval-Permutation-Induced Hallucinations in Retrieval-Augmented Generation
本文提出了 Stable-RAG,一种旨在解决检索增强生成(RAG)中“排列诱导幻觉”的新型框架。通过隐藏层状态聚类和直接偏好优化(DPO),该方法在保持 Top-5 检索性能的同时,显著提升了 LLM 在不同文档顺序下的推理一致性及其在 SOTA 基准上的表现。
TL;DR
在检索增强生成(RAG)中,文档的顺序竟然能决定模型的“生死”?本文揭示了 LLM 对文档排列的高度敏感性,并提出了 Stable-RAG。该框架通过对模型末层隐藏状态进行谱聚类,捕捉主流推理模式,并利用 DPO 偏好对齐技术,强制模型在面对同一份证据的不同排列时保持清醒和一致。
背景定位:该工作是针对 RAG 稳健性的一次深度理论修补与方法创新,填补了“排列诱导幻觉”这一细分领域的空白。
痛点深挖:文档换个位,模型就撒谎?
尽管 RAG 能缓解幻觉,但研究者发现了一个诡异现象:在 Top-5 检索设定下,哪怕金标文档(Gold Document)被固定在第一位,只要微调后面干扰文档的顺序,LLM 的输出就会发生剧烈波动。
作者发现,这种不稳定性并非源于长文本处理能力弱,而是因为:
- 推理分叉:随着模型层数加深,文档顺序的差异会在隐藏空间内累积,导致推理轨迹在中间层开始大幅偏离。
- 结构性不稳:现有的鲁棒性方法(如加噪训练或位置偏移修补)并未触及这种由内部动力学引发的推理分歧。
方法论详解:给推理轨迹“找中心”
为了修复这种“摇摆不定”的推理模式,Stable-RAG 提出了三步走战略:
1. 隐藏状态聚类(Hidden State Clustering)
作者发现,尽管有 120 种排列(5!),但模型最终的推理模式往往只坍缩为少数几个簇。
- 提取:获取模型最后一层在生成前的
last token隐藏状态。 - 谱聚类:利用余弦相似度构建拉普拉斯矩阵,通过 eigengap 自动确定聚类数量 。
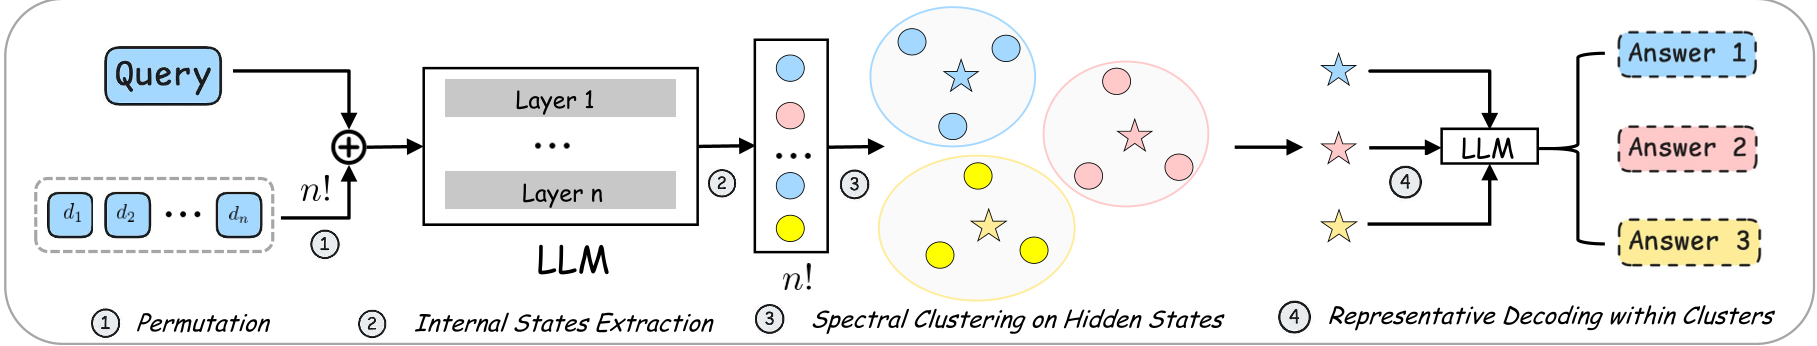 图 4:Stable-RAG 整体框架,展示了从隐藏状态提取到 DPO 对齐的全过程。
2. 代表性解码与偏好构造
与其评估所有 120 种可能,作者只解码每个聚类中心的代表性状态。根据解码结果与 Ground Truth 的对比,将数据分为四类(全对、部分对、完全错误但可答、完全不可答),构造出正负样本对。
3. DPO 偏好对齐
利用 Direct Preference Optimization(DPO)训练模型,使其偏好那些“多排列下保持一致”的正向答案,并教会在证据不足或混乱时选择说“我不知道”。
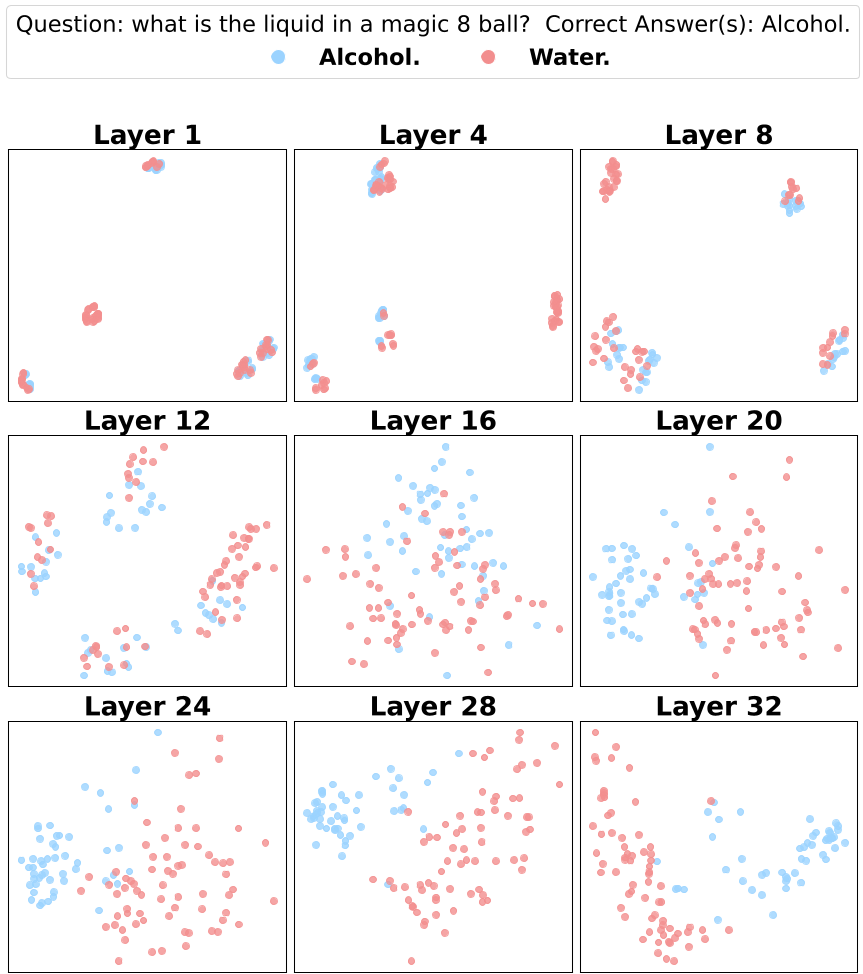 图 3:层级可视化显示,随着层数增加(从 Layer 8 到 Layer 32),不同排列产生的隐藏状态从混沌走向了分明的推理簇。
实验与结果:全线 SOTA 与强大的泛化力
在 LLaMA3-8B 和 Qwen3-8B 的验证中,Stable-RAG 表现惊人:
- 性能飞跃:在 NQ 数据集上,SubEM 相比 Vanilla RAG 提升了约 7% 以上。
- 跨检索器无缝迁移:在 DPR 上训练的模型,直接用于 Contriever 检索结果依然保持了极高的稳定性。
- 抗位移攻击:当金标文档身处不同位置时,Stable-RAG 的扰动成功率(PSR)远低于其他基线。
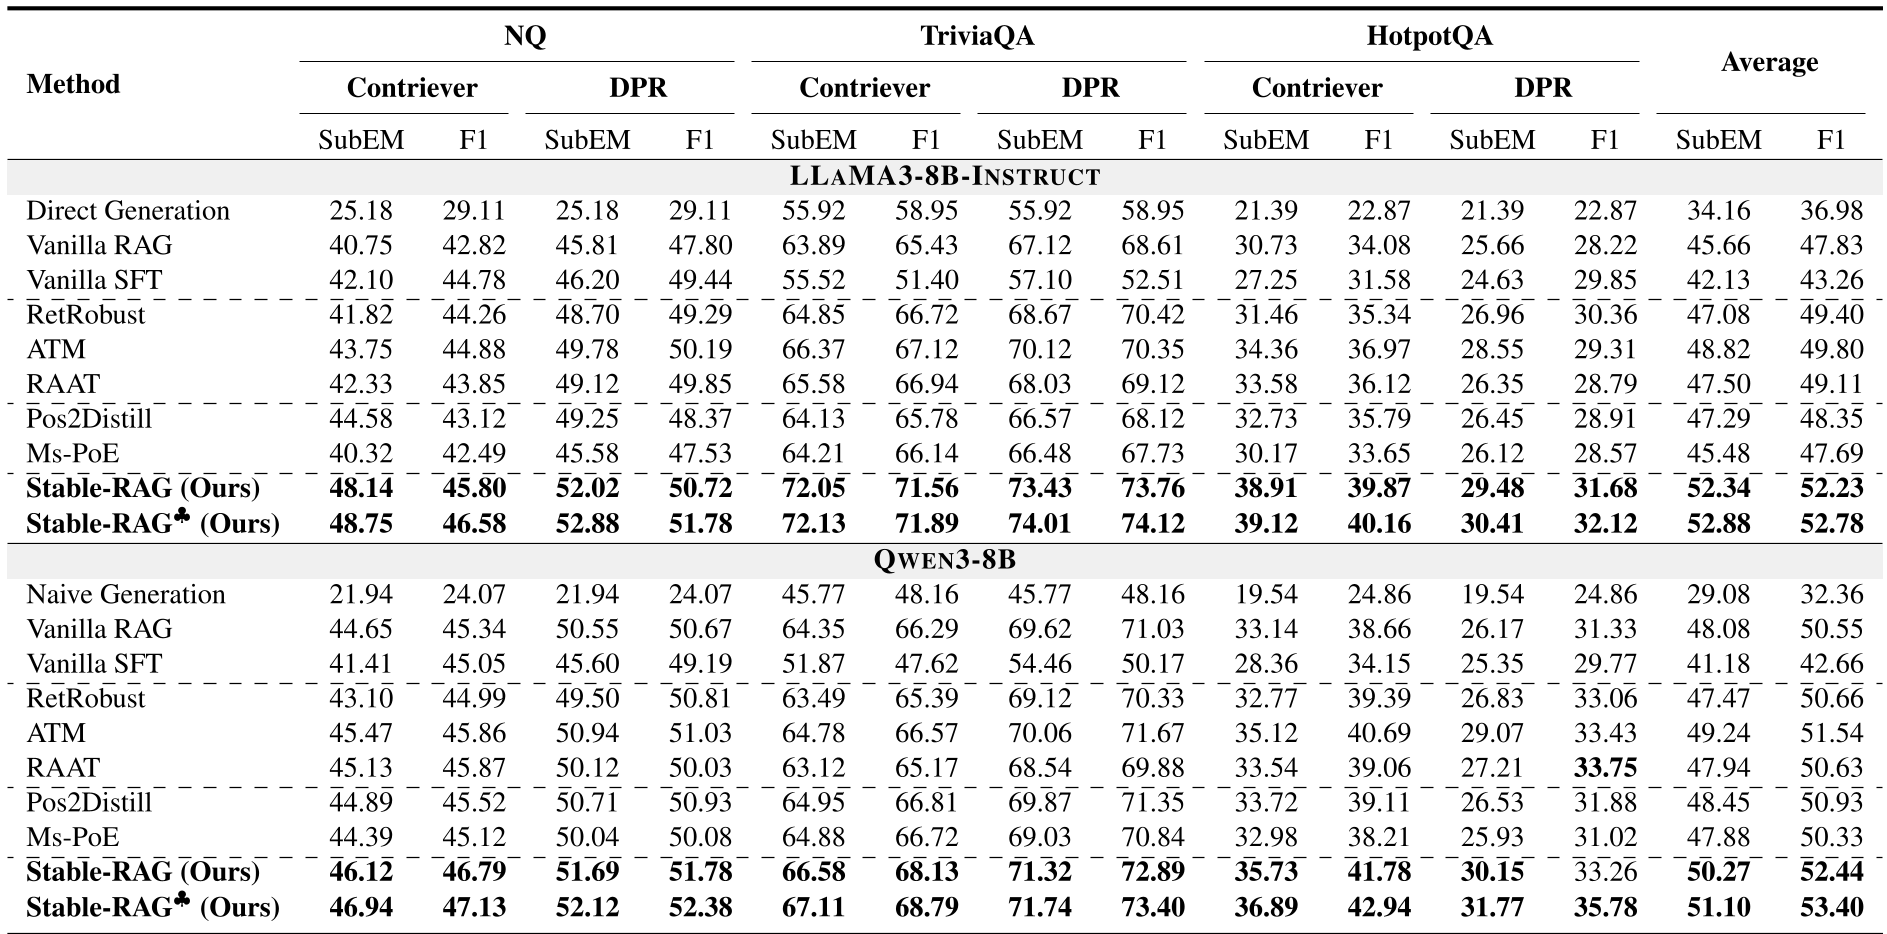 表 2:主实验对比,Stable-RAG 在多个指标和数据集上均录得最高分。
深度洞察与总结
核心贡献: Stable-RAG 的价值在于它直面了 LLM 在处理多文档输入时的“不可预测性”。它告诉我们,要让 RAG 系统真正生产可用,仅仅堆砌检索相关的上下文是不够的,必须通过优化手段让模型建立起对“顺序干扰”的免疫力。
局限性:
- 计算开销:虽然通过聚类减少了解码次数,但训练初期仍需对大量排列进行前向传播提取状态。
- 层级限制:目前仅在最终层做对齐,未来若能引入跨层级的路径约束(Path Constraints),可能会实现更极致的稳定性。
展望: 这种基于隐藏状态聚类的思想,未来可能被引入到多模态 RAG 或长文本推理机中,帮助模型在面对复杂、冗余的信息流时,精准锁定那些最稳健的推理轨迹。