
数值取证:如何用泊松分布抓出科学造假?
Statistical Detection of Potentially Fabricated Data
本文提出了一套用于检测科学研究中数值数据造假的统计取证方法。通过对细胞培养实验中的三重复(triplicate)数据进行泊松分布建模,研究者成功识别出特定人员报告数据中的非随机异常模式,并在多个维度上证实了数据造假的可能性。
TL;DR
在科学界,撤稿事件在过去十年中增加了十倍,其中大部分归咎于学术不端。本文通过一种独特的“统计取证”视角,揭示了造假者在捏造数值数据时无法避免的心理偏差。作者利用泊松分布模型(Poisson Model)对三重复实验数据进行了深度审计,通过计算 p 值发现,某些数据造假的概率比中彩票还要低。该工作不仅是一篇案例研究,更是一套可推广的数值诚信检测协议。
痛点深挖:造假者的“心理直觉”vs. 自然的“随机性”
为什么数值造假难以逃脱统计检测?核心在于人类非常不擅长模拟真正的随机性。
当一名科研人员想要伪造一组三重复(Triplicate)实验结果时,为了让实验“看起来很漂亮”,他往往会先选定一个理想的均值,然后在均值上下加减一个小的偏移量。例如,想要均值为 100,他可能会写下 {98, 100, 102}。
然而,在真实的细胞计数实验(如 Coulter 计数或菌落计数)中,数据的波动遵循泊松分布(Poisson Distribution)。泊松分布的一个关键物理直觉是:均值越大,波动越大;且观测值恰好等于四舍五入均值的概率有着严格的理论上限。
核心方法论:泊松三重复模型
作者建立了一个数学模型来评估一组 n 个三重复数据中,出现 k 个包含均值的组合的概率。
1. 均值包含性(Mean Inclusion)
如果三组观测值为 ,其均值为 。作者通过泊松分布推导出,在特定的 (均值参数)下,其中一个观测值恰好等于(或非常接近)四舍五入后的 的概率。
实验发现,无论 怎么变化,这个概率通常不会超过 0.42。而在涉嫌造假的 RTS 数据中,这一比例竟然超过了 50%。
2. 中值比例 (Mid-ratio) 分析
作者引入了一个指标 mid-ratio = (middle - low) / (high - low)。对于随机生成的测量值,这个比例在 0.4 到 0.6 之间的分布应该是均匀的。
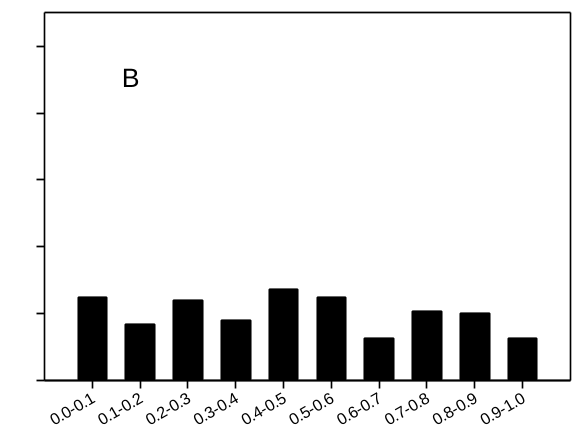 图 1:左侧(RTS)在 0.5 附近有极高的聚集,表明数据是人为对称构造的;右侧(对照组)则呈现自然的均匀分布。
实验与结果:统计学上的“死刑”判定
作者对比了涉嫌造假的 RTS 与实验室内其他 9 名成员及 3 个外部实验室的数据。
核心战绩
- 末位数字分析 (Terminal Digit Analysis):根据 Mosimann 准则,测量值的个位数应该是均匀分布的(0-9 出现频率各 10%)。RTS 的数据在卡方检验下 p 值直接归零。
- 等值对分析 (Equal Digit Analysis):RTS 记录的 Coulter 计数中,末两位数字相同的频率显著高于 10%(p < 3.3 x 10^-8)。
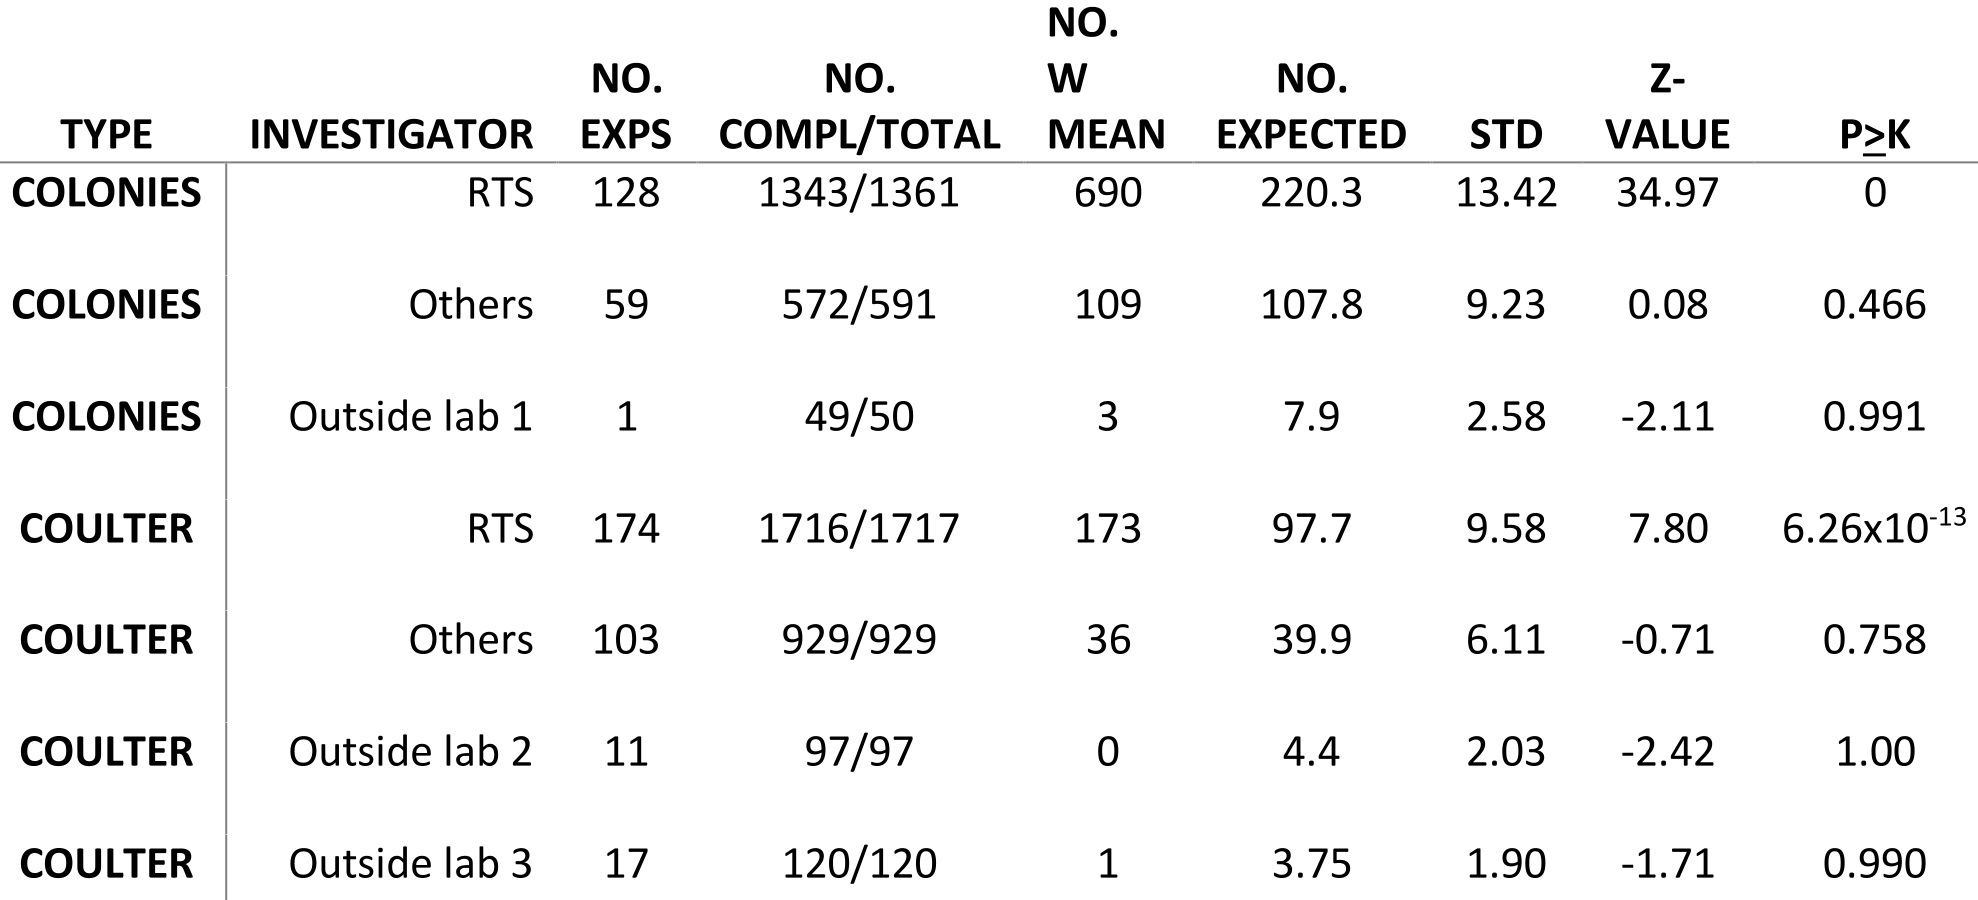 表 1:各项测试的 Z-Value 统计。RTS 在菌落计数(COLONIES)测试中的 Z 轴偏离达到了惊人的 34.97,这在统计学上意味着该数据通过随机产生的可能性为 0。
深度洞察:为什么这种方法有效?
该研究揭示了伪造者的两个致命盲点:
- 忽略了泊松分布的方差随均值增长的特性:造假者在处理高数值(如 Coulter 计数,λ > 1000)时,给出的偏差范围太小,导致数据过于“精确”。
- 个位数偏好:人类大脑在随机生成数字时会下意识地偏好某些数字(如 0, 5)或避免重复,这与物理传感器的输出特征不符。
局限性与未来展望
局限性:这是一种后验(post hoc)分析,依赖于获取完整的原始原始实验记录本。如果造假者掌握了复杂的概率建模知识,理论上可以伪造出更完美的随机数据。
启示:作者强烈建议期刊应强制要求存档原始数据,并推广自动化的细胞计数法,以减少人为干预数值的空间。未来,这种基于 R 或 Excel 的自动化检测套件有望成为学术审稿流程的标准环节。