
StepSearch:以逐步近端策略优化点燃 LLM 的搜索天赋
StepSearch: Igniting LLMs Search Ability via Step-Wise Proximal Policy Optimization
本文提出了 StepSearch,一个专为大语言模型(LLM)设计的搜索增强强化学习框架。该框架引入了逐步近端策略优化(Step-wise PPO),通过细粒度的中间搜索奖励和基于信息增益与冗余惩罚的 Token 级过程监督,显著提升了模型在复杂多跳问答(Multi-hop QA)任务中的搜索与推理能力。
TL;DR
面对复杂的多跳问答,单纯给 LLM 一个“搜索引擎”是不够的。本文提出的 StepSearch 框架通过 Step-wise PPO (StePPO) 技术,为模型提供了“此时此刻搜索得好不好”的细粒度反馈。通过引入信息增益奖励和冗余惩罚,StepSearch 让 3B 规模的小模型在多跳推理能力上甚至跨级挑战大模型。
1. 为什么“全局奖励”在垂直搜索中失效了?
在 Openai-o1 或 DeepSeek-R1 开启的大模型强化学习时代,我们习惯于通过最终结果(如公式对不对、答案准不准)来倒推模型的推理逻辑。然而,在检索增强生成 (RAG) 的场景下,搜索是一个多次迭代的过程:
- 痛点一:奖励稀疏。 如果搜索了 5 次才找到答案,只有最后一次有正向反馈,模型很难学会前 4 次搜索中哪次是路径错误,哪次是关键词不准。
- 痛点二:搜索冗余。 LLM 经常会反复搜索同一个意图的词,既浪费计算资源又容易引导出幻觉。
- 痛点三:小模型之痛。 小参数模型(如 3B)往往难以自发形成高效的搜索策略,需要更强的“手把手”教导。
2. 核心技术:StePPO 及其双重奖励机制
StepSearch 的核心在于将 PPO 算法细化到每一个检索步骤中。作者设计了一个精妙的奖励函数:
2.1 信息增益 (Information Gain, )
并不是搜到东西就有奖励!算法会通过 TF-IDF 向量对比当前检索到的文档与真实答案所需的证据文档。只有当新搜到的内容覆盖了之前未曾掌握的知识点时,模型才会获得高分。这迫使模型在每一轮搜索中都尝试挖掘“新料”。
2.2 冗余惩罚 (Redundancy Penalty, )
为了改掉模型“车轱辘话”的毛病。如果模型这一轮搜到的文档和之前几轮高度重合,就会面临严厉的负奖励。
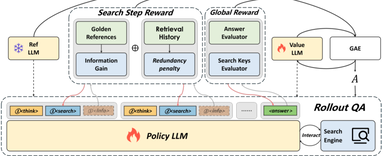 图 1:StepSearch 概览。在每一轮检索中,模型通过思考、搜索、获取信息循环。Token 级别的步骤奖励确保了搜索的高效性。
3. 数据流水线:MuSiQue-based 生成
好算法离不开好数据。作者基于 MuSiQue 数据集,利用 GPT-4o 将复杂问题拆解为子问题,并生成了 60k 条带有“正确检索路径”的数据。这种过程轨迹数据是 StepSearch 能够进行步骤级监督的基础。
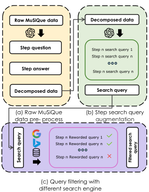 图 2:数据增强流程,确保模型在训练时有明确的“子问题-搜索词”参考对。
4. 实验战绩:小模型的“降维打击”
实验结果非常令人惊喜:
- 全面超越基线:在 4 个主流多跳问答数据集上,StepSearch 均大幅领先 Search-R1 等强对手。在 MuSiQue 任务中,其 F1 分数相比传统方法提升了近 15%。
- 小模型更有潜力:令人惊讶的是,这种逐步 PPO 对 3B 模型的提升比对 7B 模型更显著。这说明细粒度引导能让原本搜索能力孱弱的小模型快速“开窍”。
- 收敛更快:如图 3 所示,相比传统的全球奖励 PPO 或 GRPO,StePPO 的收敛速度极快,且最终达到的准确率上限更高。
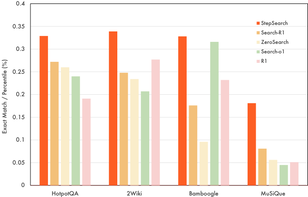 图 3:Base 模型在 StepSearch 训练下的表现。可以看到其在各数据集上均实现了大幅跃迁。
5. 局限性与思考 (Critical Thinking)
尽管 StepSearch 在多跳问答中效果拔群,但它目前主要针对文本检索。在未来,如果搜索场景扩展到多模态检索(如以图搜图来回答问题)或实时网页浏览,奖励函数的设计将面临更大挑战。例如,如何定义一张图片的“信息增益”?
结论 (Takeaway)
StepSearch 告诉我们:在大模型学会“思考”之后,下一步是教它如何高效地“寻找答案”。通过将复杂任务拆解,并给予每一个微小动作准确的物理反馈(信息增益 vs 冗余),即使是小规模参数的模型也能在知识密集型任务中发挥出惊人的战斗力。