
SGPO:别浪费你的错误!在大模型强化学习中“教育”负样本
Stepwise Guided Policy Optimization: Coloring your Incorrect Reasoning in GRPO
本文提出了 Stepwise Guided Policy Optimization (SGPO),一种针对大语言模型推理任务的强化学习优化框架。该方法通过引入步进式裁判模型(Step-wise Judge),在 Group Relative Policy Optimization (GRPO) 无法处理的全负样本组中提取学习信号,显著提升了模型在数学推理任务中的收敛速度和 SOTA 性能。
TL;DR
在强化学习(RL)训练 LLM 推理能力的过程中,如果一组尝试全都失败了,传统方法(如 DeepSeek 使用的 GRPO)通常会直接“躺平”——不产生任何更新。本文介绍的 SGPO (Stepwise Guided Policy Optimization) 打破了这一沉默。通过引入一个步进式裁判模型来定位错误的起点,SGPO 能让模型从“差一点就对了”的失败中吸取教训,将收敛速度和推理精度推向新高度。
背景定位:这是针对当前推理模型训练(RLVR 范式)中样本效率问题的关键改进,介于结果奖励(ORM)与过程奖励(PRM)之间的轻量化高效方案。
痛点深挖:全负样本的“静默”代价
在当前的 Reasoning 模型(如 OpenAI-o1, DeepSeek-R1)训练中,GRPO 是一种极具吸引力的算法,因为它不需要额外的 Critic 模型。然而,它的致命伤在于其组内相对优势计算。
假设模型针对一个难题生成了 8 个回答,结果全错了。在 GRPO 的公式里,这 8 个回答的奖励都是 0,归一化后的优势值 也会变成 0。
- 后果:模型在最需要指导的难题上原地踏步。
- 直觉缺失:人类学习数学时,即便最后算错了,老师也会指出哪一步公式代错了。丢弃全负样本,等于丢弃了最宝贵的“错题本”。
核心逻辑:给错误“着色” (Coloring Incorrect Reasoning)
SGPO 的核心思想非常直观:并非所有错误都等价。一个在最后一步算错数的结果,显然比第一步就胡言乱语的结果更有价值。
1. 推理轨迹得分 (RTS)
SGPO 引入了一个 Step-wise Judge。对于每一个错误的回答,裁判会参考标准答案,指出“在哪一步开始跑偏的”。
- 计算公式:。
- 平滑奖励:通过下式将 RTS 转化为标量奖励: 其中 调节强度, 是阈值。
2. 模型架构
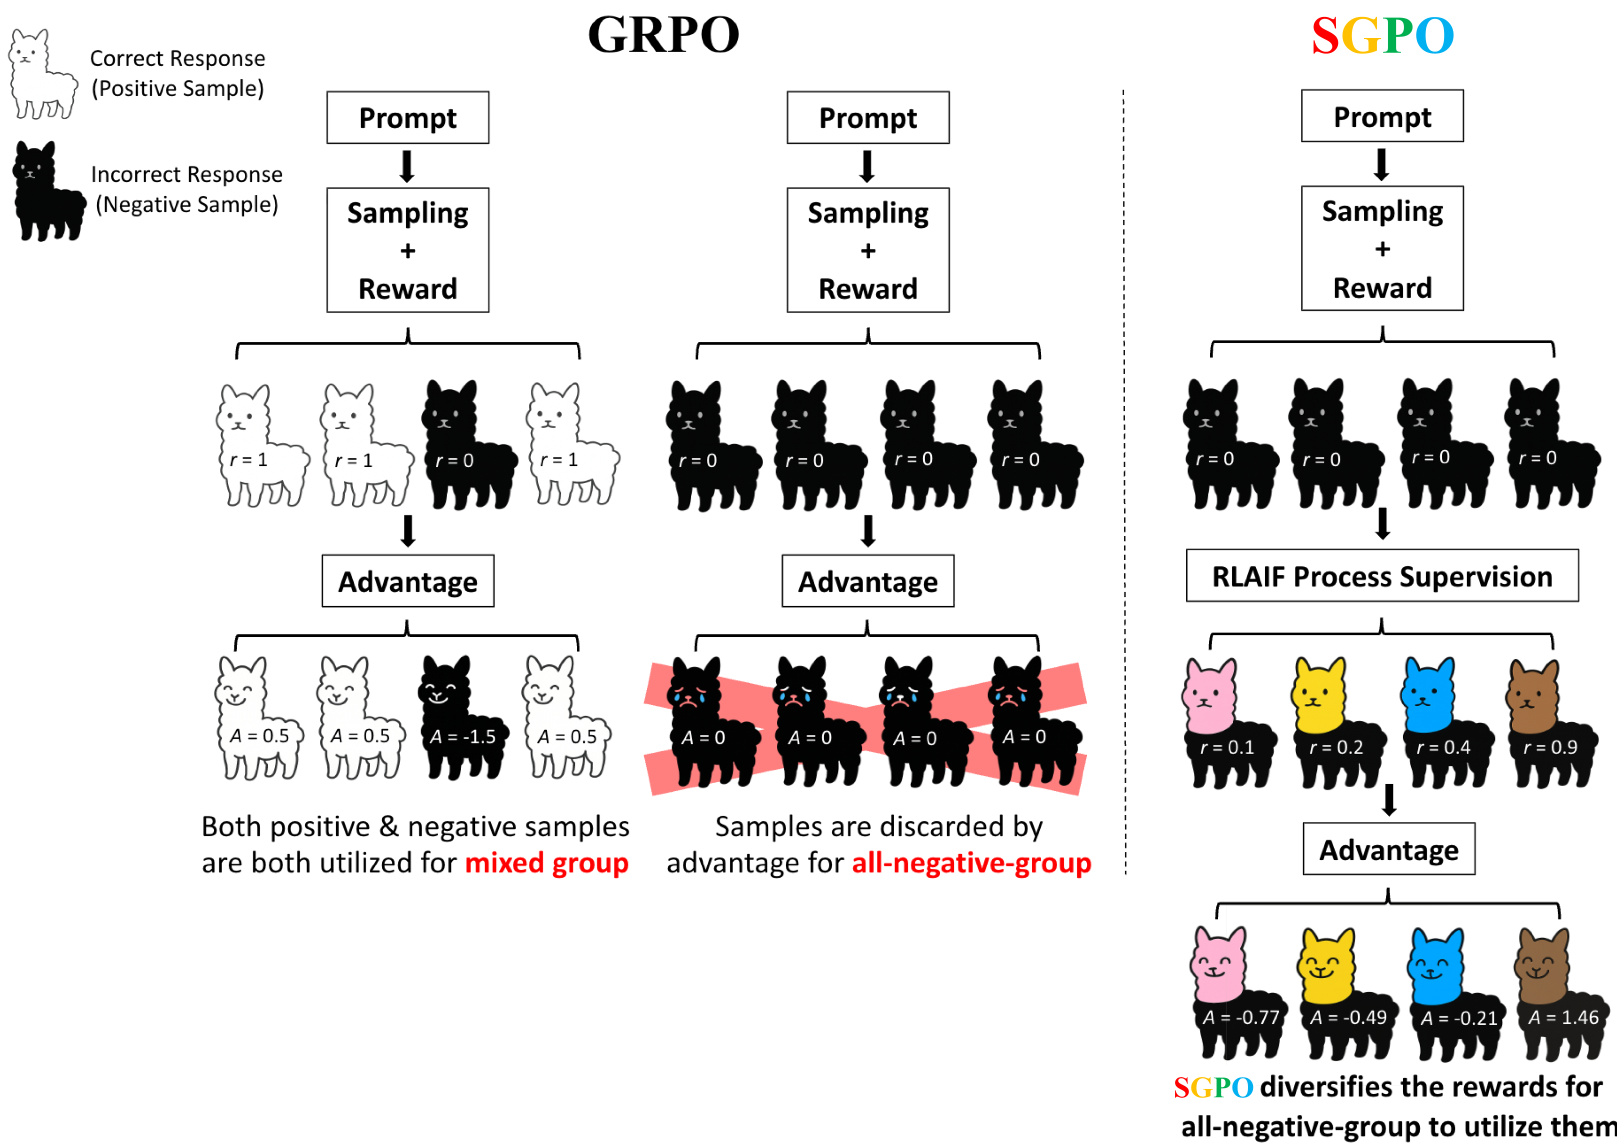 上图展示了 SGPO 的工作流:采样 -> 裁判纠错 -> 计算 RTS -> 更新政策。
理论证明:为何 SGPO 跑得更快?
作者通过一个简化的二级决策模型证明了:SGPO 的梯度动力学在任何迭代步下都优于 GRPO。
- 加速收敛:由于 SGPO 在第一步就能从局部正确中获得正向偏置(Bias),它学习“正确动作”的概率 上升速度远超传统方法。
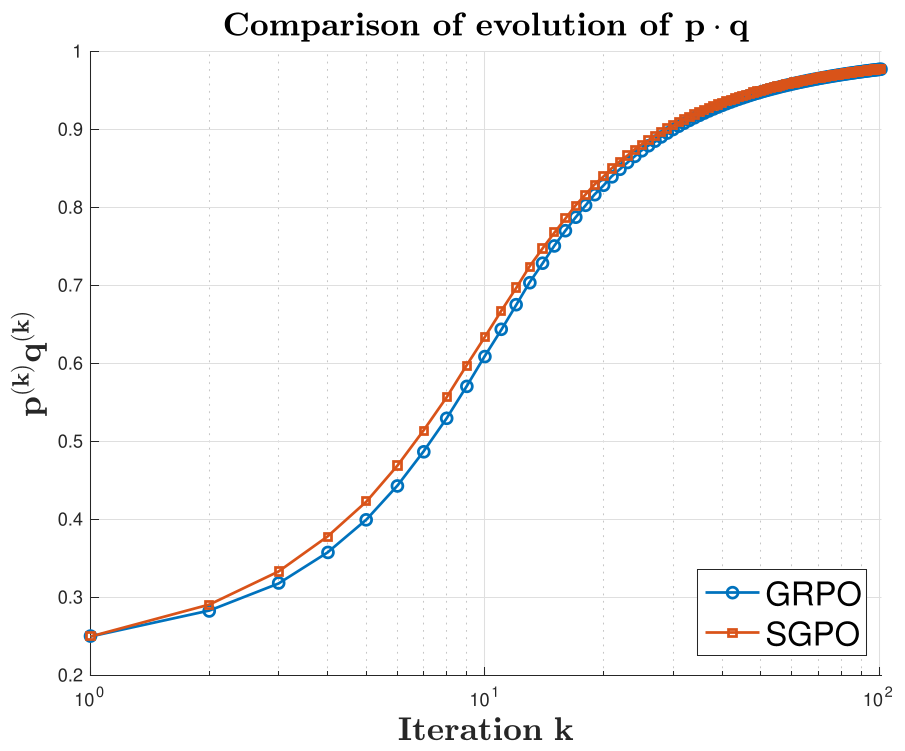 左图展示了第一步正确动作的概率演变,右图展示了最终找到最优策略的概率,SGPO(橙色)始终压制 GRPO(蓝色)。
实验战果:数学竞赛能力的跨越
研究团队在 Qwen2.5 和 DeepSeek-R1-Distill 等多个强力基座上进行了测试,涵盖 AIME、AMC、MATH500 等多项高难度数学评测。
- 关键发现 1:负样本也能带飞。在离线实验中,即便只用负样本进行 SGPO 训练,模型性能提升竟然能与只用正样本训练相媲美,甚至在某些指标上更优。
- 关键发现 2:更强的鲁棒性。在线训练中,SGPO 在 AIME24 和 AIME25 等竞赛级任务上表现稳健。特别是针对 QwQ-32B 的实验,SGPO 将平均分从 78.8 提升至 80.1。
政策熵分析
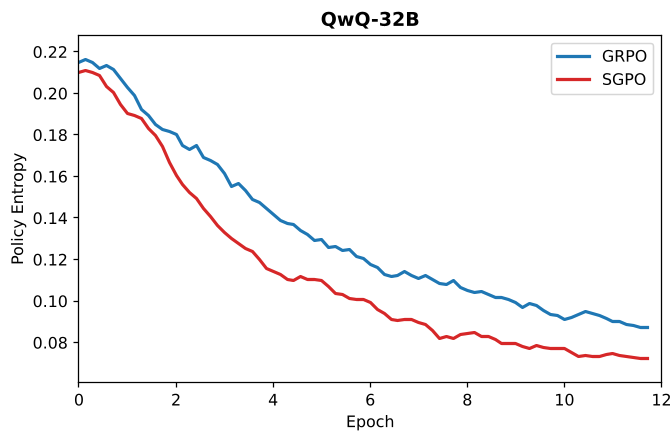 实验数据显示,SGPO 的政策熵下降速度显著快于 GRPO。这意味着模型能更迅速地从迷茫(高熵)转向确定(低熵)的正确推理逻辑。
深度洞察:为什么不直接用 PRM?
很多读者会问:为什么不直接训练一个复杂的过程奖励模型 (PRM)?
- 开销极低:SGPO 只需要裁判定位“第一个错”,不需要对每一步进行复杂的概率估值。
- 抗攻击性强:PRM 容易陷入 Reward Hacking(模型学会通过写特定格式来骗分),而 SGPO 基于首错定位的事后评估更难被欺骗。
- 不依赖超强裁判:实验证明,即便用性能稍弱的开源模型(如 QwQ-32B)做裁判,SGPO 依然有效,这极大地降低了训练成本。
总结与局限
Takeaway:SGPO 证明了通过“局部信用分配”来盘活全负样本是提升大模型推理能力的捷径。它填补了成功经验与失败教训之间的鸿沟。
局限性:SGPO 的效果高度依赖于负样本的“质量”。如果模型错得太离谱(第一步就乱码),SGPO 提供的信号也会变弱。但在模型已经具备一定基础的训练中后期,SGPO 是超越平庸、冲刺 SOTA 的绝佳助力。
未来,这种“从错误中精准学习”的范式预计将扩展到代码纠错和更复杂的科学发现任务中。