
停止拟人化:思维链(CoT)究竟是逻辑推导还是“念经”?
Position: Stop Anthropomorphizing Intermediate Tokens as Reasoning/Thinking Traces!
本文由亚利桑那州立大学 Subbarao Kambhampati 教授团队撰写,是一篇针对“长思维链评估”的立场论文。文章揭示了推理模型(如 DeepSeek R1)产生的中间预测序列(ITG)并非人类意义上的“思考轨迹”,而是某种通过强化学习习得的“提示词增强”(Prompt Augmentation)。
TL;DR
在 DeepSeek R1 等推理模型横扫各大榜单的今天,我们习惯于阅读那一页页密密麻麻的“思考过程”。但这篇来自亚利桑那州立大学团队的立场论文(Position Paper)泼了一盆冷水: 中间 Token(Intermediate Tokens)并不是模型的“思考轨迹”,而是一种被拟人化误读的、旨在改变概率分布的“数据脚手架”。 模型的所谓“Aha Moment”可能只是概率分布下的风格模仿,而非真正的逻辑觉醒。
1. 痛点:拟人化的危险诱惑
目前的 AI 社区陷入了一种“拟人化”陷阱。我们给模型生成的中间步骤取名为 "Thinking Trace" 或 "Reasoning Trace",导致了三个严重的错误假设:
- 可解释性假设:认为这些伪代码或自然语言揭示了模型的内部运作。
- 忠实性假设:认为如果中间步骤错了,结果一定错;如果步骤对了,结果必对。
- 努力度假设:认为 Token 越长,模型“思考”得越努力。
作者指出,这种拟人化不是无害的比喻。它不仅让用户在面对错误答案时因为“看起来很像推理的过程”而产生虚假信任(False Trust),还诱导研究者去优化一些对模型性能毫无帮助、甚至有害的“人类可读性”。
2. 核心实验:逻辑不再重要?
为了拆穿这些“思维链”的真面目,作者进行了多项干预实验。
迷宫路径规划中的“逻辑互换”
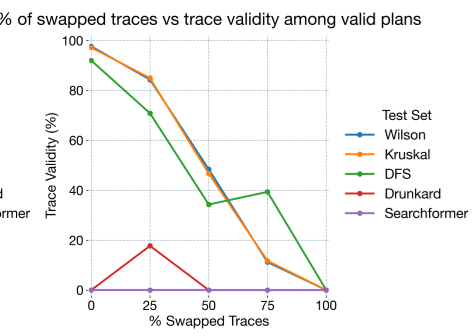
作者在训练模型解决迷宫任务时,故意将 A* 算法生成的轨迹与错误的迷宫实例进行匹配(Swapped Traces)。
结果令人震惊: 模型在测试时,即便输出的是完全混乱、无语义逻辑的轨迹,只要其格式符合某种“习得的模式”,模型最终给出正确路径的概率依然很高。这意味着,模型并不依赖轨迹中的“逻辑链条”进行计算,而是将其作为一种**提示词增强(Prompt Augmentation)**的占位符。
长度与难度的脱节
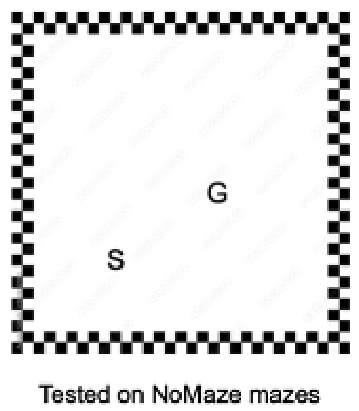
DeepSeek R1 宣称更长的思维链代表更强的推理能力。但作者发现,一个训练用于处理复杂迷宫的模型,在面对极其简单的“无障碍迷宫”时,由于 OOD(分布外)效应,会陷入疯狂的、长达整页的无效“呻吟”,甚至耗尽上下文窗口。
3. 方法论:从“逻辑链”到“脚手架”
作者提出了一个新的视角:中间 Token 应被视为“习得的提示词增强”(Learned Prompt Augmentation)。
这里的 是原始任务, 是模型生成的中间 Token。它的物理直觉是:这些中间 Token 的真正作用不是为了给人类看,而是为了让当前的语境分布(Context Distribution)更容易让模型拟合出正确的下一个 Token。
4. 深度洞察:为什么还要让人类读懂?
文章中最尖锐的一个观点是:强行让思维链变“美观”和“可读”会损害准确率。 DeepSeek 在从 R1-Zero(混杂中英、格式混乱但准确率极高)进化到 R1(优雅美观)的过程中,使用了大量人工干预来让模型“好好说话”。结果显示,这种纯粹为了人类审美的 Supervised Fine-Tuning (SFT) 往往会降低模型的原生逻辑表现。
5. 总结与未来展望
本文的结论极具挑战性:
- 停止寻找语义:不要试图在中间 Token 里找“算法”,它们可能只是模型的一种“文化惯例模仿”。
- 拥抱隐藏维度:未来的推理模型或许不应再输出人类语言。在**连续潜在空间(Continuous Latent Space)**中生成不可读但高效的计算向量,才是真正释放 Transformer 算力逻辑的方向。
- 验证胜于信任:在安全敏感领域,绝对不能依靠思维链的“看起来合理”来判断系统安全性,必须引入外部的形式化验证器(LLM-Modulo)。
一句话评论:不要被 AI 的“碎碎念”欺骗了,它只是在通过念经来调整呼吸,而不是真的在思考。