
StoryScope:当 AI 学会了华丽辞藻,我们如何通过“叙事逻辑”识破它的伪装?
StoryScope: Investigating idiosyncrasies in AI fiction
本文提出了 STORYSCOPE,一个专门用于识别 AI 生成小说与人类创作小说之间话语级(Discourse-level)叙事差异的自动化分析框架。通过在 10 个叙事维度提取 304 个解释性特征,该方法在不依赖词汇风格信号的情况下,实现了 93.2% 的 AI 识别准确率。
TL;DR
随着 GPT 和 Claude 等大模型的进化,传统的 AI 检测器正在失效。本文介绍的研究工作 STORYSCOPE 另辟蹊径,它不看你用词是否华丽,而是深挖故事的“骨架”——情节连贯性、角色动机和时间跳跃。结果发现,AI 故事往往“用力过猛”且“过于整齐”,而人类故事则胜在“混乱的创意”和“非线性的复杂”。
背景定位
在 2026 年的今天,AI 生成的长篇小说已泛滥。当词汇库可以被随意优化,“风格”已不再是可靠的防线。本文在 AI 创作评估坐标系中属于开创性的方法论改进:它首次在大规模平行语料库(1万+提示词,6万+故事)上证明了,叙事架构(Discourse-level choices)才是区分人类原创与机器生成的终极护城河。
痛点深挖:风格易整容,逻辑难洗白
现有的 AI 检测器(如 GPTZero)大多在玩“猫鼠游戏”:AI 多用了几个“delve”,侦探就抓这个词;版本一更新,侦探就歇菜。 作者洞察到一个深刻的直觉:
“修饰文字只需要局部修改,但改变叙事结构——比如把线性叙事改成倒叙,或者增加一个道德模糊的副线——需要对全局逻辑进行重写,这正是当前 LLM 的软肋。”
核心方法论:STORYSCOPE 流水线
STORYSCOPE 并不是直接读小说,它包含了一个“去肉取骨”的过程:
- 结构化表示 (Extraction):将 5000 字的长文转化为 JSON 模板,涵盖角色动机轨迹、因果链、时序跳跃等。
- 特征发现 (Discovery):通过 GPT-5.1 对比不同模型生成的同一题材故事,推导出 304 个可解释的叙事特征。
- 预测与解释 (Attribution):利用 XGBoost + SHAP 分析,不仅告诉你这是 AI 写的,还告诉你它是因为“因果链太直”或“过度说教”泄了底。
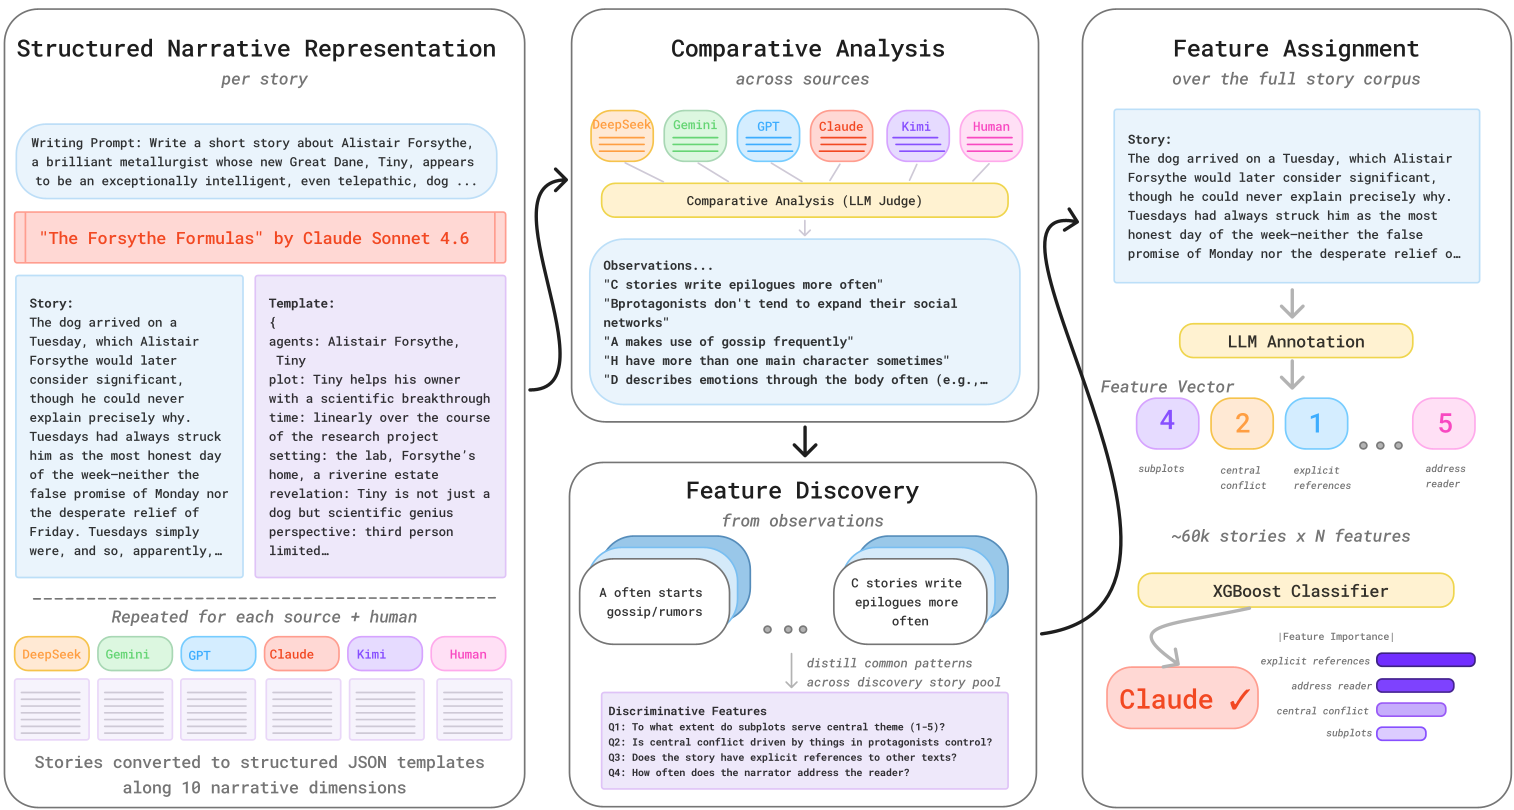 图 1:STORYSCOPE 流水线概览:从散文到模板,再到特征发现与检测。
关键发现:人类与 AI 的“灵魂”博弈
通过对实验结果的深度复盘,论文揭示了 AI 创作的三个典型“怪癖”:
- 过度解释 (Thematic Over-determination):AI 怕你看不懂,会在故事结尾或对话中反复强调主题和寓意(占比 77%,人类仅 52%)。
- 感官过载 (Sensory Over-writing):AI 极其喜欢描写气味和身体反应来堆砌氛围,比如角色害怕时一定会流冷汗、心跳加速,而人类可能直接写他“感到恐惧”。
- 时空线性的平庸:AI 喜欢单线叙事(79% 没有副线),更偏好圆满或内部释怀的结局;而人类作者则热衷于时间跳跃、倒叙以及让人不安的道德模糊性。
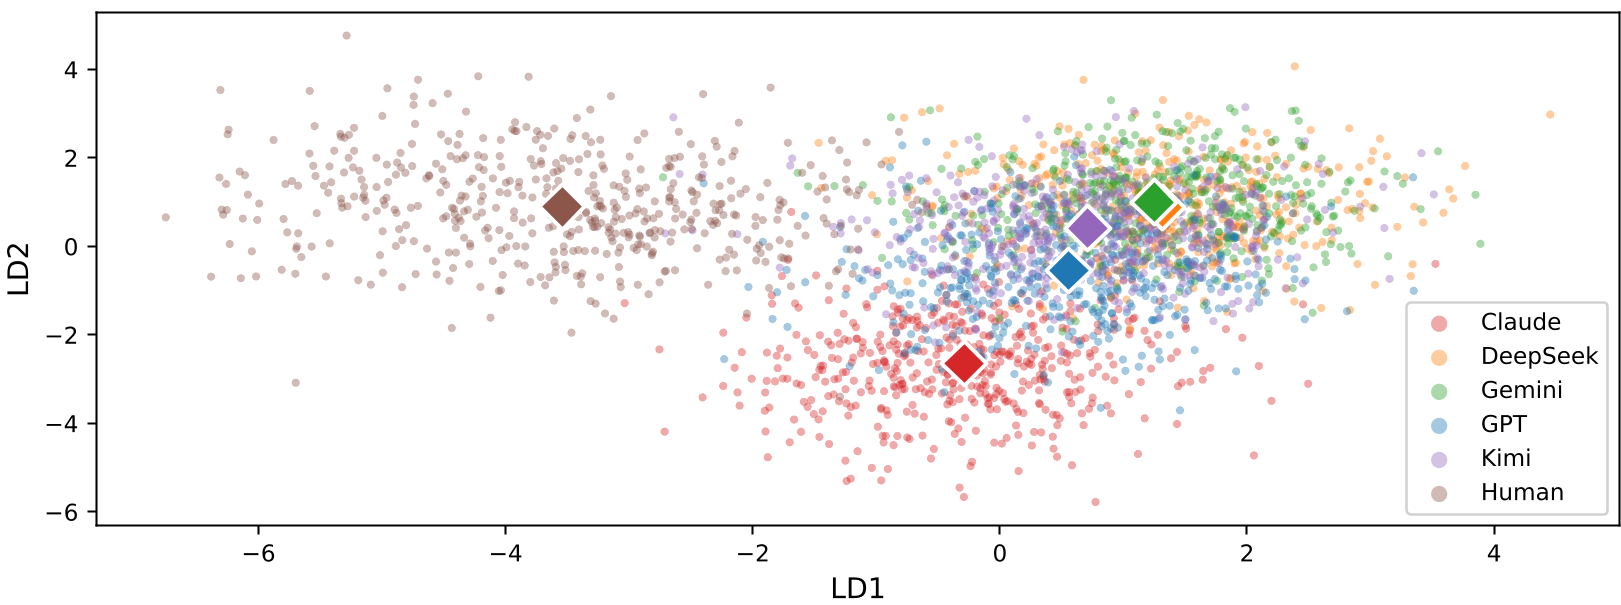 图 2:叙事特征空间投影:可见人类(红色)占据了更广阔且稀疏的区域,而 5 种 AI 模型紧密缩在特定的聚类中。
深度洞察:AI 会梦见电子羊吗?
论文还提供了一个有趣的“模型指纹”库:
- Claude:最“克制”,情节升级平缓,但叙事声音极其统一,尊重传统。
- GPT:社交达人,喜欢写闲言碎语和群体社交网络。
- Gemini:结局最“整洁”,但笔下的环境往往最阴森压抑。
总结与局限
Takeaway: 该研究通过测量“叙事稀有度”(Rarity)量化了原创性。结果证明,人类的原创力体现在对常规结构的破坏和多样性的探索上,而 AI 倾向于寻找叙事的“平均值”。
局限性: 虽然叙事特征难以修改,但如果未来的 LLM 专门针对这些“叙事指纹”进行对齐微调(例如强制加入非线性结构),本方法的识别效能可能会面临新的挑战。
本文主编评论:STORYSCOPE 的意义不仅在于检测,它更像是一张“人类创意地图”,告诉我们在生成式 AI 时代,哪些深层的文学特质依然是我们作为物种所独有的。