
Stream-CQSA:打破显存枷锁,单卡实现 10 亿 Token 无损注意力计算
Stream-CQSA: Avoiding Out-of-Memory in Attention Computation via Flexible Workload Scheduling
本文提出了 Stream-CQSA,一种基于循环法定数集(Cyclic Quorum Sets, CQS)理论的高效注意力计算框架。该框架通过 CQS Divide 算子将原始注意力机制无损地分解为多个独立的子序列任务,支持在显存受限的单卡上执行超过 10 亿(1B)长度的准确注意力(Exact Attention)计算。
TL;DR
传统的注意力机制(Attention)由于其 的显存占用,在面对超长上下文时极易导致显存溢出(OOM)。普林斯顿大学的研究团队通过引入 CQS Divide 理论,将注意力计算从一个“不可分割的逻辑块”转变为“一系列可调度的子任务”。这种方法在数学上是完全无损的,且能让单张 GPU 在有限显存下通过“时间换空间”的方式处理高达 10 亿级别 的 token 序列。
背景定位:显存是长文本的“头号杀手”
尽管 FlashAttention 系列显著降低了中间矩阵的 IO 开销,但它们都有一个共同的假设:Q、K、V 三个完整的张量必须能全部塞进 GPU 显存。当序列长度达到百万甚至千万级别时,仅仅是存储这些张量本身就会触发 OOM。
Stream-CQSA 的出现,标志着注意力计算从算子优化层深入到了任务分解层。
核心动机:为什么要用 CQS 理论?
作者的直觉非常精妙:注意力计算本质上是所有 Token 之间的两两交互,这可以抽象为一个完备图 (Complete Graph)。
- 痛点:传统的拆块(Block-wise)方法在处理 Softmax 归一化时,需要复杂的跨块通信和中间变量存储。
- CQS 的核心思想:利用循环法定数集理论,将一个大完备图拆解为若干个小完备图(子序列)。只要这些子完备图的并集能够覆盖原图的所有边,并且通过巧妙的 CQS Masking 剔除重复计算的边,我们就能实现无通信开销的并行分解。
架构解析:如何实现 Stream-CQSA?
Stream-CQSA 的核心流程分为三步:Divide (分解)、Compute (独立计算) 和 Merge (聚合)。
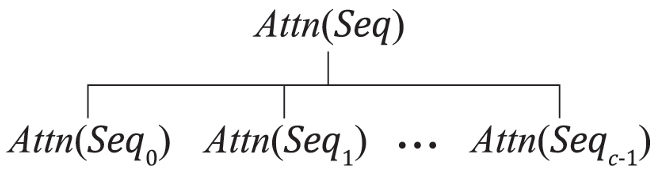 图 1:CQS Divide 的几何直观。将一个大任务循环分解为多个互相重叠但覆盖完备的子任务。
- CQS Divide:将长度为 的序列划分为 个块,构造包含若干块的子序列。例如在 的配置下,每个子任务只处理约 43% 的长度。
- CQS Masking:这是确保数学无损的关键。由于子序列之间存在重叠,直接相加会导致结果偏大。作者设计了一种简单的掩码规则:每个子序列仅负责其主对角线上的块交互,从而实现非冗余覆盖。
- 流式调度 (Streaming):由于任务之间完全独立,系统可以根据当前剩余显存,动态决定一次运行几个子任务(
n_cap)。如果发生 OOM,系统会自动增加分解粒度(itr),将任务切得更小。
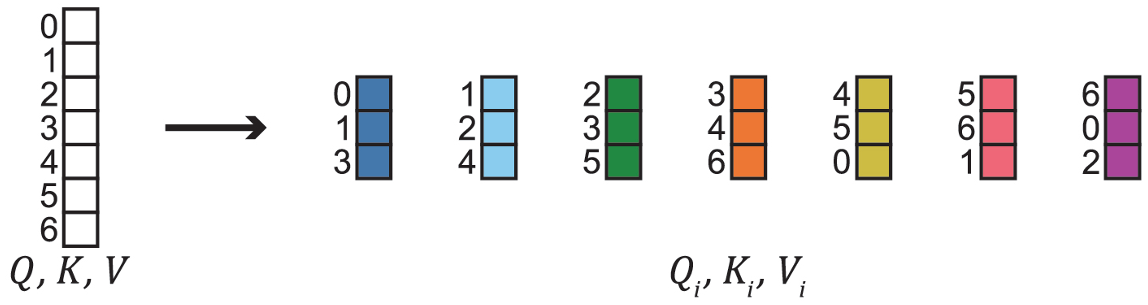 图 2:CQSA 前向传播示意。可以看到,最终结果由各子任务的 Numerator 和 Denominator 累加后归一化得到。
实验战绩:迈向 10 亿 Token
在单张 A100 GPU 上,研究者验证了 Stream-CQSA 的极强可扩展性:
- 显存可预测性:显存占用随分解深度 的增加而线性下降。每次执行 CQS 分解,显存 footprint 降低约 42.86%。
- 性能拐点:有趣的是,实验发现当分解足够细(如 )时,由于子任务规模变小极大提升了内核效率,总计算时间反而会下降,实现了显存和时间的双赢。
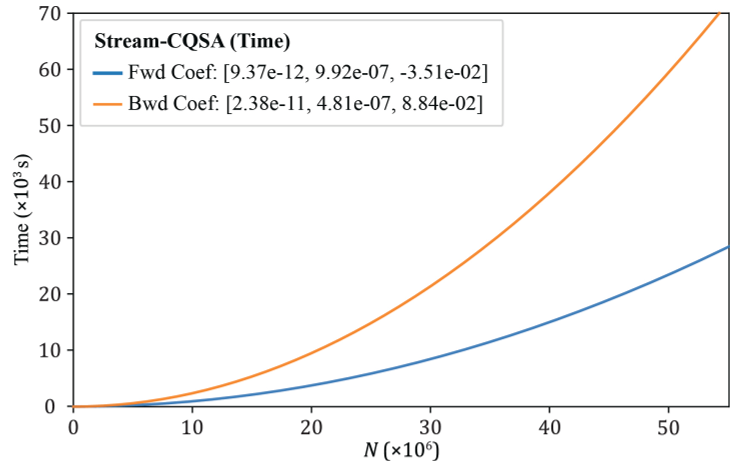 图 3:正向与反向传播的显存与时间对比。即便在反向传播这种开销巨大的环节,Stream-CQSA 依然表现稳定。
深度洞察:不仅仅是单卡优化
Stream-CQSA 的真正价值在于它改变了我们配置算力的方式:
- 异构并行:你可以让显存大的 GPU 处理大子序列,显存小的处理细碎任务。
- 通信零开销:由于子任务在数学上是独立的,在分布式环境下,节点之间不需要进行中间状态的同步,直到最后一步 Merge。
- OOM 守护进程:内置的 OOM Guardrail 机制让模型在面临不确定长度的输入时拥有极强的鲁棒性。
局限与展望
尽管 Stream-CQSA 展现了惊人的扩展性,但目前的瓶颈在于由于频繁的 Host-Device 数据交换(H2D/D2H)带来的 Miscellaneous 负载。未来的研究方向将聚焦于开发内核级集成的 CQSA(如基于 FlashAttention 算子重写),以进一步压低调度开销。
总结
Stream-CQSA 证明了:通过深度的组合数学设计,我们可以在不改变 Transformer 架构、不引入近似误差的前提下,彻底攻克长文本的显存屏障。这为构建真正的“无限上下文”模型打开了一扇大门。