
[EMNLP] Structure Tree-LSTM:让文档编码回归“建筑学”结构,实现高可解释性分类
Structure Tree-LSTM: Structure-aware Attentional Document Encoders
本文提出了 Structure Tree-LSTM,一种将 Tree-LSTM 扩展至篇章层面的文档编码方法。该方法通过模仿文档的物理结构(词-句-段-节)建立分层架构,并引入了基于 Zero Vectors 的分层注意力机制,在多项文档分类任务中达到 SOTA 水平。
TL;DR
本文提出了一种名为 Structure Tree-LSTM 的新型文档编码器,打破了过去将长文档视为“句子序列”的惯效思维。通过将文档建模为一颗反映物理结构(段落、节、子节)的树,并利用递归神经网络的特性,该模型在显著提升分类精度的同时,通过“天然”生成的注意力机制实现了极佳的可解释性。
痛点深挖:被忽视的文档“骨架”
长文本处理一直是 NLP 的难题。传统的 Sequential LSTM 在处理超长序列时容易遗忘,而主流的 Attention 机制 在处理包含数千词的文档时,往往因计算复杂度过高而只能采取“折中”的扁平化策略。
作者指出,人类阅读并非线性扫描,而是通过“目录(Table of Contents)”建立全局认知。现有的模型如 HAN (Hierarchical Attention Networks) 虽然考虑了词与句的层次,但依然无法捕捉文档中递归嵌套的复杂结构(例如:一个“Section”包含多个“Sub-sections”,后者又包含多个段落)。
核心机制:Structure Tree-LSTM
作者的核心 Insight 是:直接镜像文档的逻辑树状结构。
1. 结构觉醒 (Structure Awareness)
不同于之前只用于句子内词法解析(Dependency Tree)的 Tree-LSTM,Structure Tree-LSTM 根据文档的实际大纲构建树。
- 叶子节点:最小语义单位(词或句子嵌入)。
- 非叶子节点:段落、节、直至根节点(整个文档)。
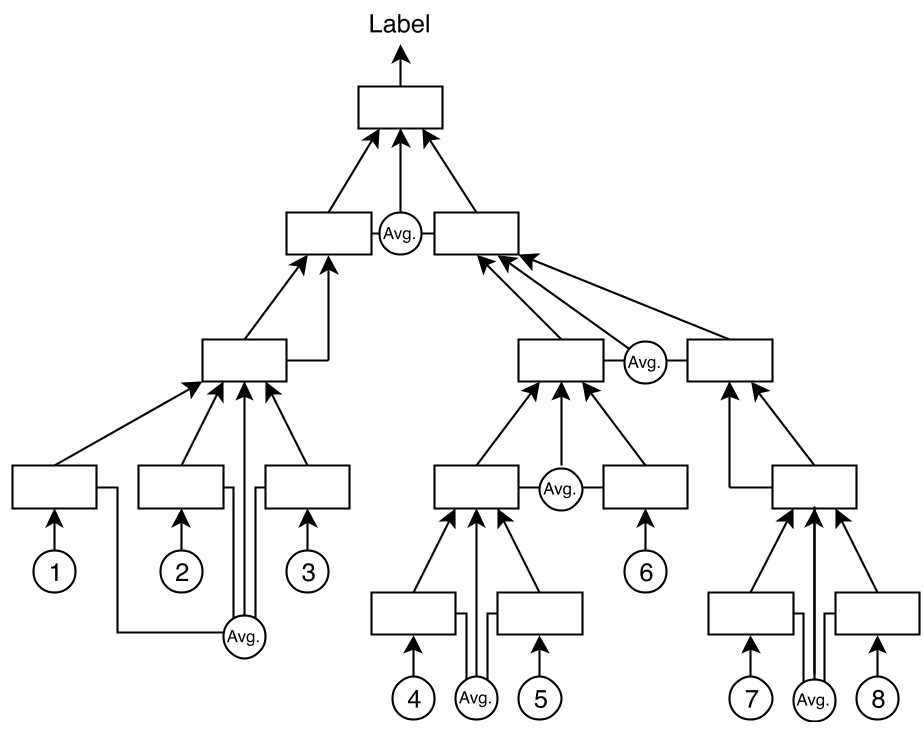 上图展示了从文档大纲到 Tree-LSTM 结构的映射过程。
2. 零向量初始化:发现天然注意力机制
这是一个非常优雅的数学处理。作者提出了 Structure Tree-LSTM with Zero Vectors: 在递归过程中,非叶子节点不接收任何额外的特征输入()。这意味着该节点的隐藏状态 完全由其子节点的输入 决定。根据推导,原本用于控制信息的遗忘门 此时在数学形式上等同于对子节点的 分层注意力权重:
这种设计不仅减少了参数量,更让模型在没有显式注意力层的情况下,学会了“哪些句子对段落重要,哪些节对全文重要”。
实验与结果:小样本下的逆袭
研究人员在 Enron Email(真实、非结构化邮件)和 Wikipedia(长篇、深层结构)上进行了实验:
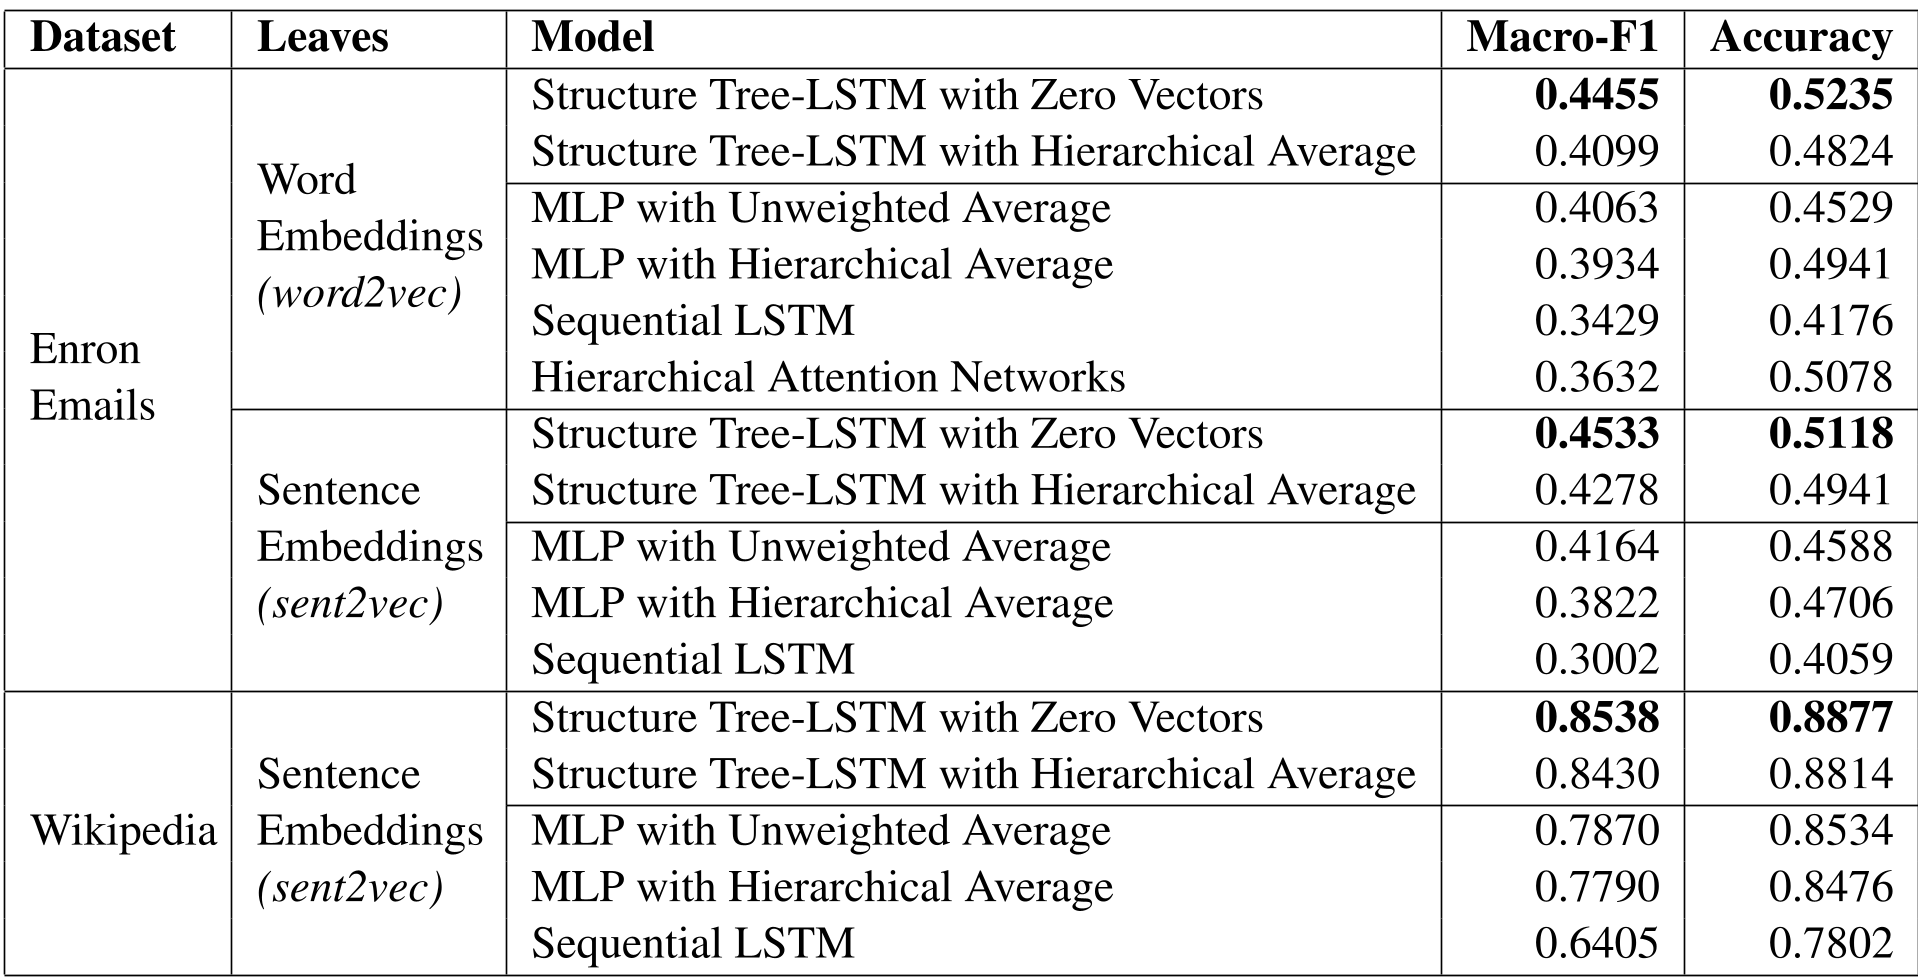
- 卓越的性能:在 Wikipedia 数据集上,Structure Tree-LSTM 的 Macro-F1 达到了 0.8538,大幅领先于传统顺序 LSTM 的 0.6405。
- 数据效率:相较于 HAN 等模型,由于有了显式的结构先验,该模型在较小规模的数据集上(如 Enron)表现出了更强的鲁棒性。
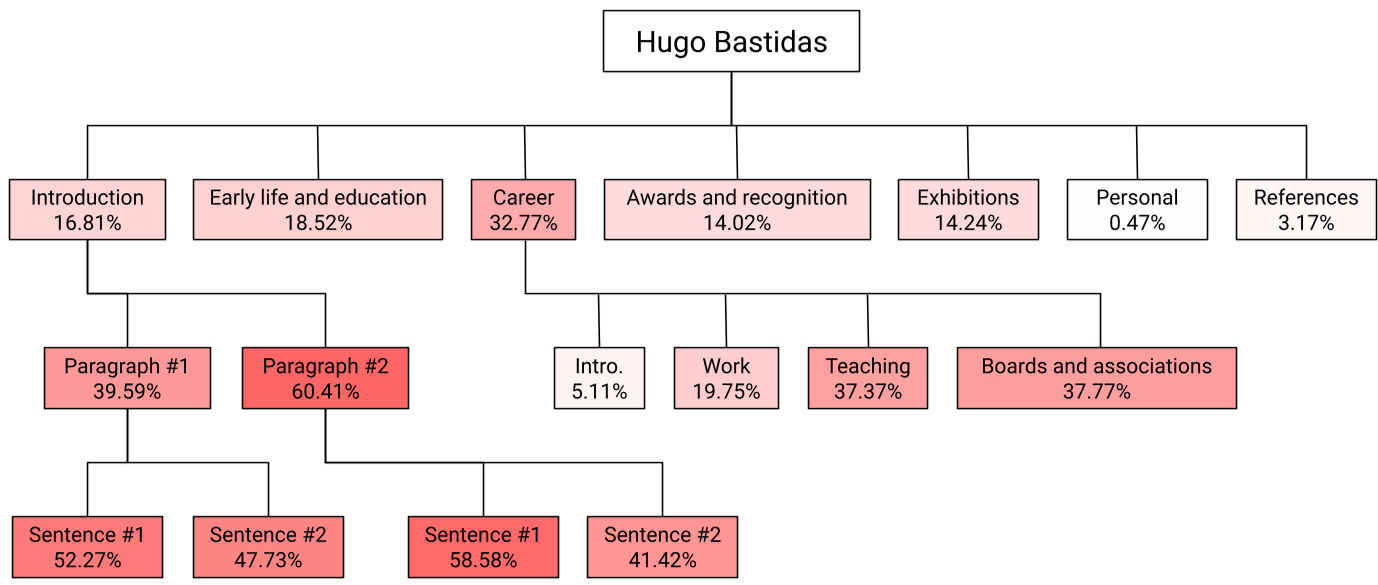
可解释性可视化
通过可视化计算出的分层权重,我们可以清晰地看到:为了判断一篇维基百科文章是否属于“艺术家”类别,模型将大部分注意力集中在了“职业生涯(Career)”这一章节,这与人类的逻辑完全一致。
深度洞察与总结
模型局限性
作者坦诚,目前的 Child-Sum 架构无法捕捉子节点之间的时序/顺序信息。在医学模型 MIMIC-III 的病死率预测中,由于病人的病情好转(坏报告在前,好报告在后)与恶化在模型视角下是等价的,导致其表现略逊于 CNN。
启示与展望
Structure Tree-LSTM 证明了“结构化先验知识”在长文档建模中的巨大潜力。虽然现在是大模型(LLM)的时代,但这种将**文档格式(Markdown, JSON, XML)**转化为计算拓扑结构的思路,对于提升长上下文处理的情景感知(Context-aware)能力,以及设计更轻量、可解释的工业级分类器仍有极强的借鉴价值。
Takeaway: 复杂的模型不一定需要复杂的公式,对物理世界逻辑的回归往往能带来更强的鲁棒性。