
[综述] 大语言模型自主智能体:通往 AGI 的关键进化路径
A survey on large language model based autonomous agents
本文对基于大语言模型(LLM)的自主智能体进行了全面综述,提出了由控制角色(Profiling)、记忆(Memory)、规划(Planning)和行动(Action)四大模块组成的统一架构框架,并深入探讨了智能体在社会科学、自然科学及工程领域的应用与评估方法。
TL;DR
本文是关于基于 LLM 的自主智能体(Autonomous Agents)的权威综述,由人民大学团队撰写。它不仅定义了智能体的四大核心架构模块(控制角色、记忆、规划、行动),还深入剖析了如何通过微调或机制工程使 LLM 获得类人决策能力。这是理解当前生成式 AI 如何从“对话框”走向“现实世界执行者”的必读指南。
1. 痛点:为什么 LLM 不等于智能体?
尽管 GPT-4 等模型表现出极高的智力,但它们本质上仍是概率预测器。传统 AI 智能体在受限环境中演化,而人类心智则能利用海量知识在开放领域决策。若要让 LLM 成为真正的智能体,必须解决以下问题:
- 缺乏身份意识:模型需要知道自己在扮演什么角色(如架构师或心理医生)。
- 短时记忆限制:上下文窗口(Context Window)无法承载长期的经验积累。
- 规划能力缺失:面对复杂目标,模型容易“迷失”在中间步骤。
2. 核心架构:构建智能体的“四大支柱”
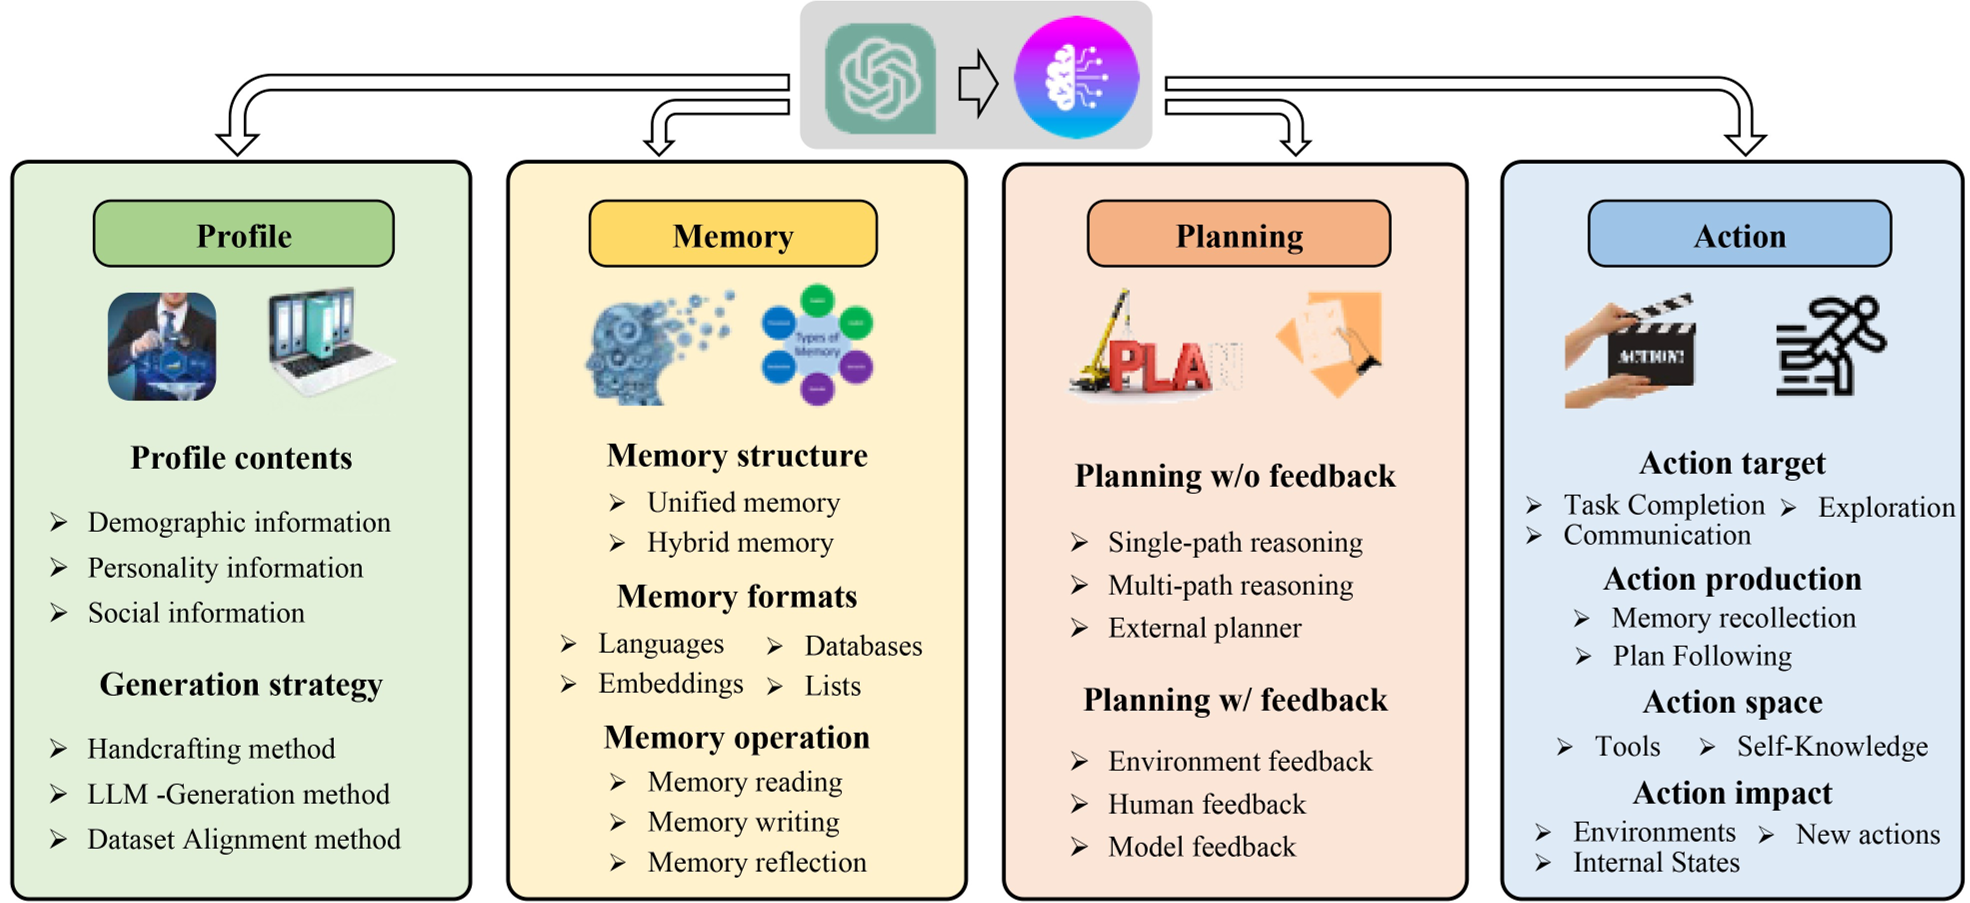
作者提出的统一框架图示了智能体的运作逻辑:
2.1 控制角色模块 (Profiling)
智能体需要一个“人设”。通过人工设定(Handcrafting)、LLM 自动生成或真实数据对齐,为智能体赋予职业、性格甚至心理状态。这直接影响了后续的记忆提取和行动风格。
2.2 记忆模块 (Memory)
- 短期记忆:通过 In-context Learning 实现,受限于 context window。
- 长期记忆:通过向量数据库等外部检索(RAG)实现。
- 演化机制:不仅是存储,还包括记忆反思 (Reflection),即将低层经验总结为高层见解。
2.3 规划模块 (Planning)
这是解决复杂任务的关键。
- 无反馈规划:如 CoT (Chain of Thought),一次性生成步骤。
- 有反馈规划:通过环境反馈、人类反馈或模型自评进行迭代修正。
2.4 行动模块 (Action)
将决策转化为现实结果。智能体不仅可以产生文本,还能调用 External Tools (APIs, 数据库) 或通过 Robotics 改变物理世界。
3. 能力获取:从“预训练知识”到“专业技能”
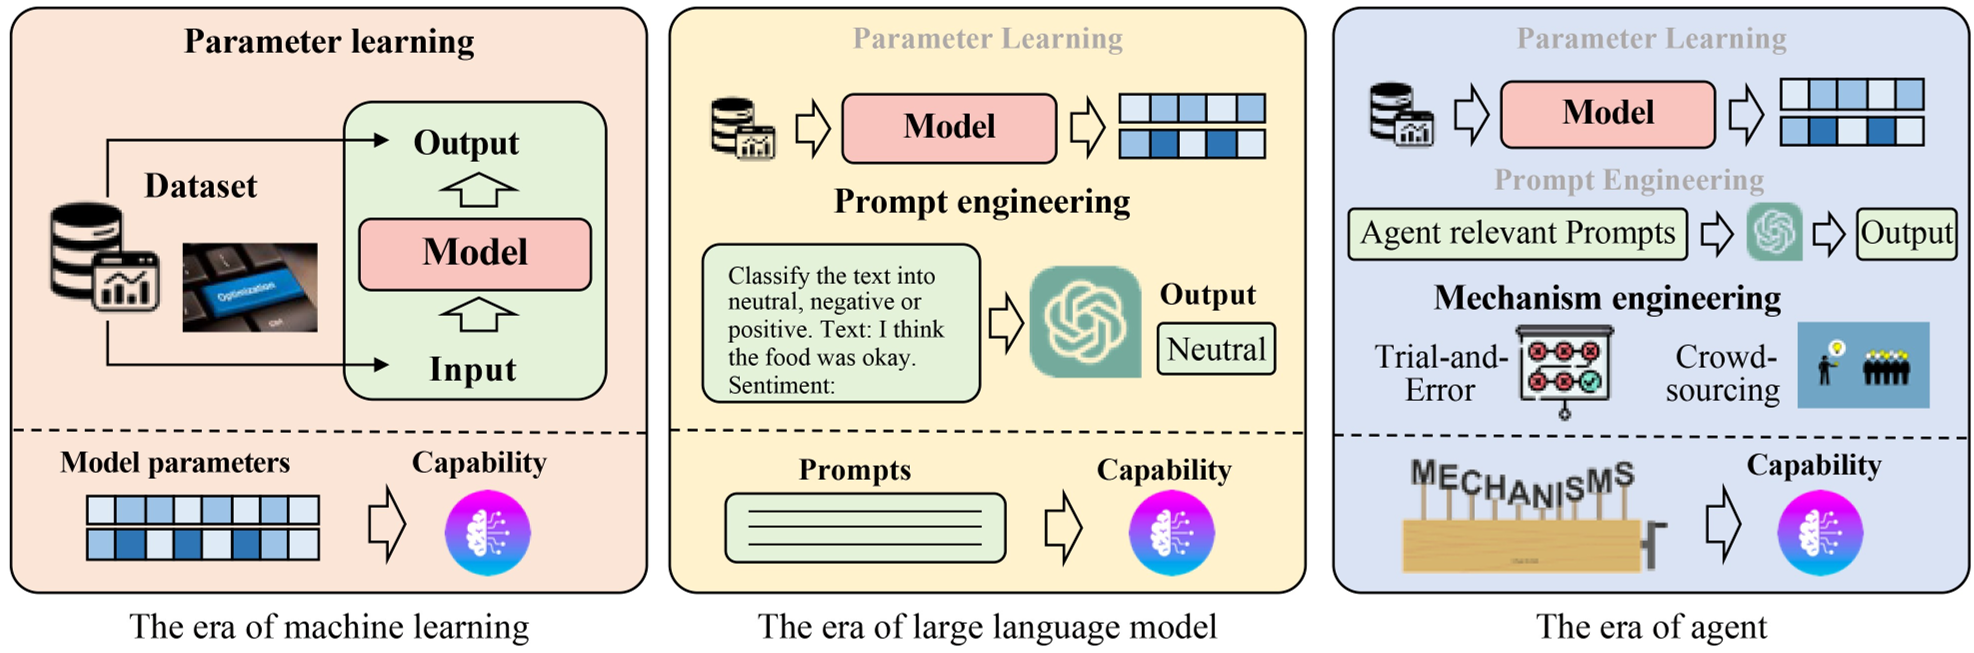
文章总结了提升智能体能力的三种范式:
- 微调 (Fine-tuning):利用人类标注、LLM 生成或真实世界数据进行参数更新(如 ToolBench)。
- 提示工程 (Prompt Engineering):利用 CoT 等策略激发模型潜能。
- 机制工程 (Mechanism Engineering):这是本文的一大亮点,强调通过试错 (Trial-and-error)、众包对抗 (Crowd-sourcing) 和经验积累等逻辑回路来增强智能体,而无需改变模型权重。
4. 应用与评估:无处不在的智能体助手
论文详细分类了智能体在 社会科学(社会模拟、法律、心理)、自然科学(实验设计、文献管理)和 工程领域(软件工程、具身人工智能)的爆发式应用。
在评估方面,除了传统的指标(成功率、准确率),作者呼吁关注 人类相似度 (Human Similarity)。如下表所示,AgentBench 和 WebArena 正在成为该领域的新 SOTA 基准。

5. 深度洞察:未来的挑战在哪?
- 角色扮演的深度:LLM 目前仍难以模拟非 Web 语料库覆盖的边缘角色。
- 广义人类对齐:当智能体用于模拟时,我们是否应该允许它模拟“不当行为”以进行压力测试?
- 知识边界问题:模型往往“知道得太多”,在模拟认知受限的人类行为时会产生偏见。
- 幻觉问题:在代码和法律等严谨领域,幻觉依然是致命伤。
总结
基于 LLM 的自主智能体不再是科幻概念,而是正在发生的工程现实。通过模块化设计与机制创新,我们正在见证从“聊天语言模型”到“通用人工智能原型”的跨越。下一阶段的竞争,将不仅在于模型参数规模,更在于如何构建更加鲁棒、可扩展的智能体协作系统。