
引爆小模型潜力:深度拆解大模型在策略蒸馏 (On-Policy Distillation)
A Survey of On-Policy Distillation for Large Language Models
本文是学术界首篇关于大语言模型(LLM)在策略蒸馏(On-Policy Distillation, OPD)的综述。文章提出了统一的 f-divergence 理论框架,系统梳理了从白盒 logit 匹配到黑盒反馈及自我竞赛(Self-play)的演进路径,并指出 OPD 是解决自回归生成中“曝光偏差”的核心手段。
1. 核心速览 (Executive Summary)
TL;DR:为什么 7B 的模型总是学不像 GPT-4?核心痛点在于曝光偏差 (Exposure Bias)。本文综述了 在策略蒸馏 (On-Policy Distillation, OPD) 技术,这是一种让学生模型“在犯错中学习”的机制。通过让学生生成自己的答案并接受教师的实时纠偏,OPD 将推理误差的增长从二次方降低到了线性。
背景定位:这篇综述是该领域的“及时雨”。它不仅总结了从 DeepSeek-R1 到 GKD 等最新 SOTA,更将碎片化的研究统一到了 f-divergence 理论框架下,标志着 LLM 蒸馏从“黑盒模仿”进入了“系统优化”时代。
2. 痛点:被忽视的“曝光偏差”
在传统的离线蒸馏策略中,学生模型就像一个背诵标准答案的学生。他只见过教师给出的完美路径,却从未学习过:如果前一个词写错了,后一个词该如何补救?
在自回归推理中,第一步的微小偏差会导致学生进入一个从未见过的隐空间状态(Out-of-Distribution)。因为训练时没见过这种“烂摊子”,学生会彻底崩溃。这就是为什么离线蒸馏的小模型在面对数学题或长代码时,往往会产生严重的幻觉。
3. 理论基石:f-divergence 统一架构 (Methodology)
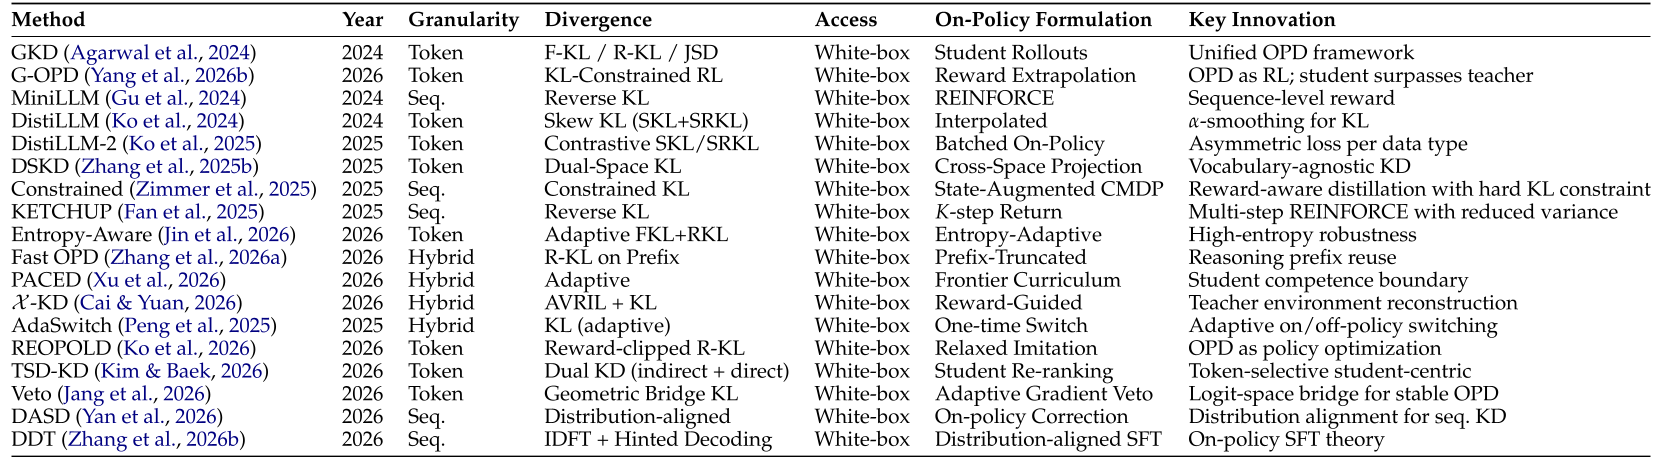
作者提炼出一个极简的 OPD 统一公式,揭示了所有现有的 OPD 方法(如 GKD, MiniLLM, DistiLLM)本质上都在做三件事的组合:
- 采样策略 ():决定是完全按学生想的写(On-policy),还是偶尔参考教师(Off-policy)。
- 散度选择 ():选择 Forward-KL(求全)、Reverse-KL(求精)还是 JSD。
- 参数排布:是将教师作为分布目标,还是作为奖励函数。
深度洞察:
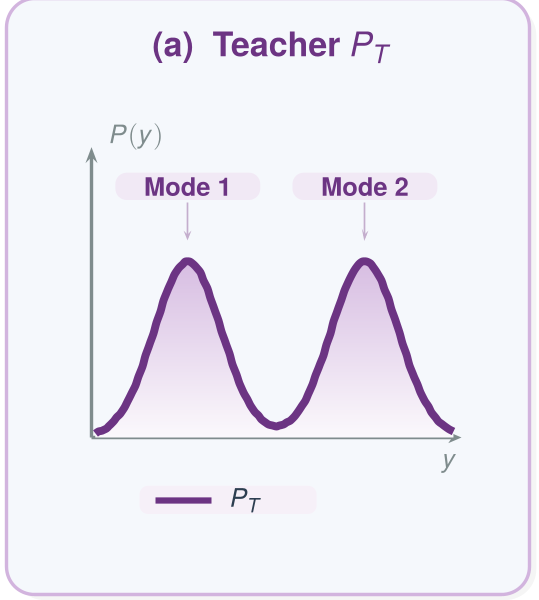
- Forward-KL (Mode-covering):强迫学生覆盖教师的所有可能,但会导致模型在多个正确答案之间“反复横跳”,产生平庸的废话。
- Reverse-KL (Mode-seeking):强迫学生专注在教师最认可的一个节点上,这正是复杂推理所需要的。MiniLLM 正是利用这一点,通过强化学习(REINFORCE)优化这一目标。
4. 技术地图:三维分类学
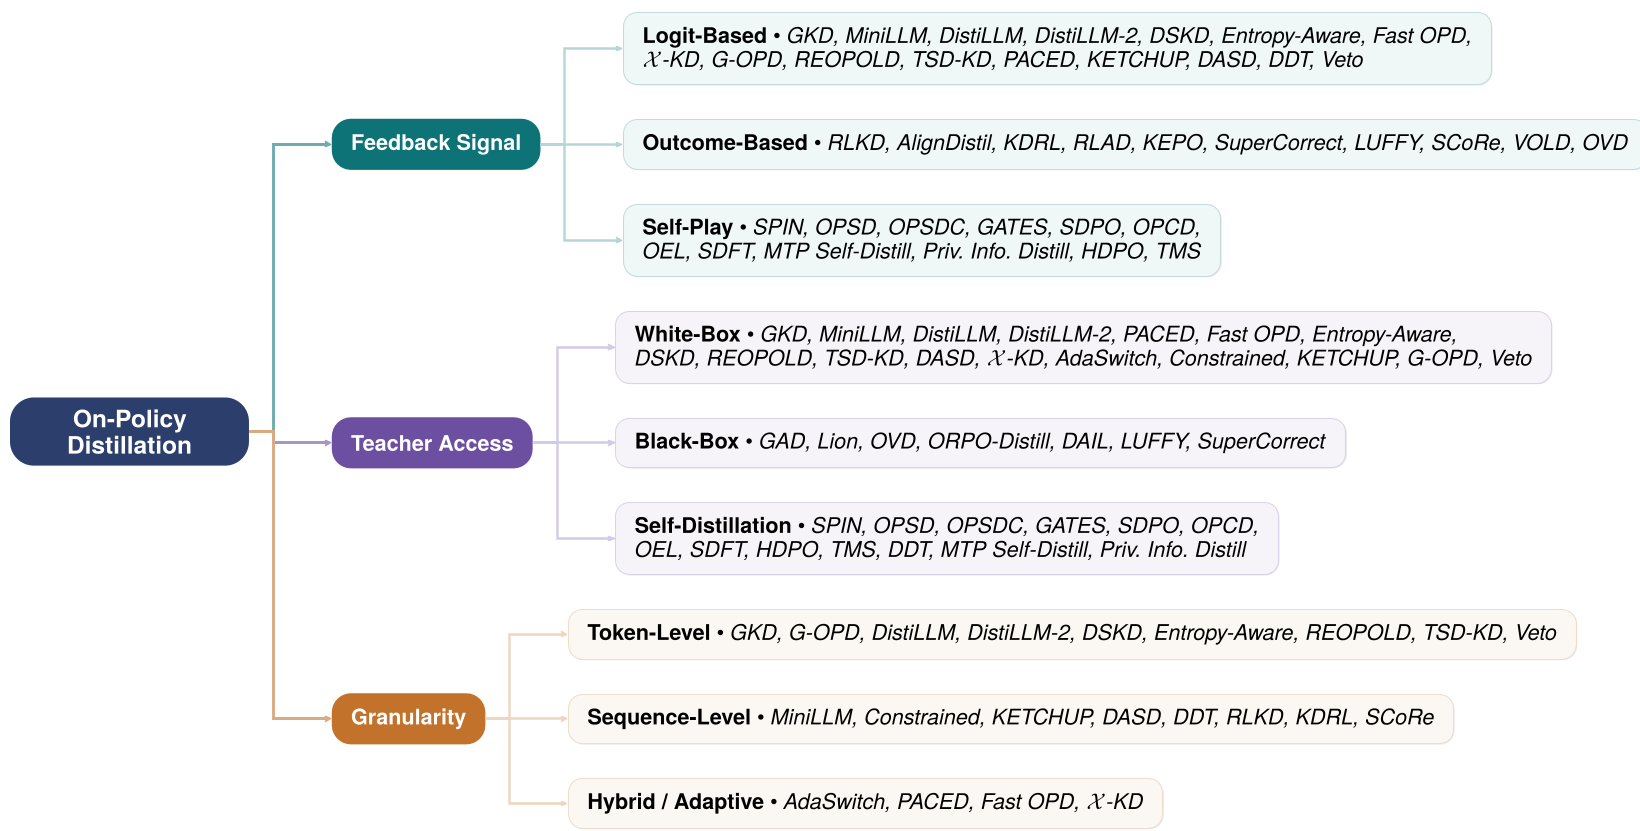
文章将 OPD 划分为三个核心维度,为开发者提供了清晰的路线图:
- 反馈信号:
- Logit-based:白盒模式,信号最密,梯度最稳,但对算力要求极高。
- Outcome-based:黑盒模式(如调用 GPT-4 API),只看最后对不对。
- 教师访问:不仅有“白盒/黑盒”,还提出了自我蒸馏(Self-Distillation)。例如 SPIN 算法,让模型自己跟自己的旧版本打架。
- 粒度选择:Token 级太短视,Sequence 级梯度太稀疏。目前的趋势是 Hybrid(混合粒度)。
5. 实验分析与工业实践
论文特别分析了 DeepSeek-R1 的成功。虽然 R1 分发的是离线 Reasoning 数据,但其核心价值在于数据中包含了“自我纠偏”的过程(Aha Moments)。
更有趣的是 奖励外推 (Reward Extrapolation) 现象:在 OPD 框架下,学生模型有可能在某些特定领域超越教师模型。这是因为学生通过自主探索发现了更简洁、更符合自身架构的推理路径。
6. 总结与未来展望
Takeaway:
- 推理任务选 Reverse-KL:不要迷信标准的交叉熵(Forward-KL),模式寻求(Mode-seeking)才是提升逻辑的关键。
- 效率是第一生产力:OPD 的算力开销是离线蒸馏的 3-8 倍。投机蒸馏 (Speculative KD) 和 前缀截断 (Fast OPD) 是未来的落地关键。
局限性:目前的 OPD 依然缺乏类似 Chinchilla 的 Scaling Laws。我们需要知道,对于 7B 的学生,喂 1B 的在线生成的 Token 和喂 10B 的离线 Token,收益曲线具体如何交汇?
随着 DeepSeek-R1 开启的大模型推理时代,在策略蒸馏已经从“学术探讨”变成了“工业刚需”。它不仅是压缩手段,更是赋予小模型生存与进化能力的终极路径。