
SwitchMT:突破多任务学习干扰,自适应切换让 SNN 智能体更进化
SwitchMT: An Adaptive Context Switching Methodology for Scalable Multi-Task Learning in Intelligent Autonomous Agents
本文提出了 SwitchMT,一种基于脉冲神经网络 (SNN) 的高效多任务强化学习架构。该方法通过引入主动树突 (Active Dendrites) 和对决结构 (Dueling Structure) 的深度脉冲 Q 网络 (DSQN),结合一种创新的自适应任务切换策略,实现了在资源受限设备上对多个 Atari 游戏任务的同步高效学习。
TL;DR
在强化学习(RL)领域,让一个模型同时学会玩多个游戏而不“左右互搏”一直是个难题。近日,纽约大学阿布扎比分校(NYUAD)的研究团队提出了 SwitchMT。它通过在脉冲神经网络(SNN)中引入主动树突和自适应任务切换策略,成功克服了多任务干扰,并在不增加计算负担的情况下,实现了比传统固定频率训练更高效的学习过程。
1. 痛点:固定节奏是多任务学习的“杀手”
传统的多任务学习(MTL)往往采用“大锅饭”模式:每项任务固定训练 N 个回合(Episode)后切换。这种做法存在两个致命缺陷:
- 平台期浪费:简单任务很快就学好了,但固定周期的存在强迫模型继续“磨洋工”,产生过拟合风险。
- 干扰严重:在模型还未巩固当前任务特征时暴力切换,会导致之前学到的知识被迅速覆盖(即灾难性遗忘)。
2. 核心架构:像大脑一样进行任务隔离
为了在单一网络中有效隔离不同任务,SwitchMT 采用了增强型的 Deep Spiking Q-Network (DSQN) 架构。
主动树突 (Active Dendrites)
SwitchMT 在神经元模型中模拟了生物脑的树突调节机制。通过任务特定的上下文信号(Context Signals),网络能够动态地加强或抑制某些神经通路,从而在同一个大网络中产生多个“专用子网络”。这种机制极大地减少了不同任务目标之间的冲突。
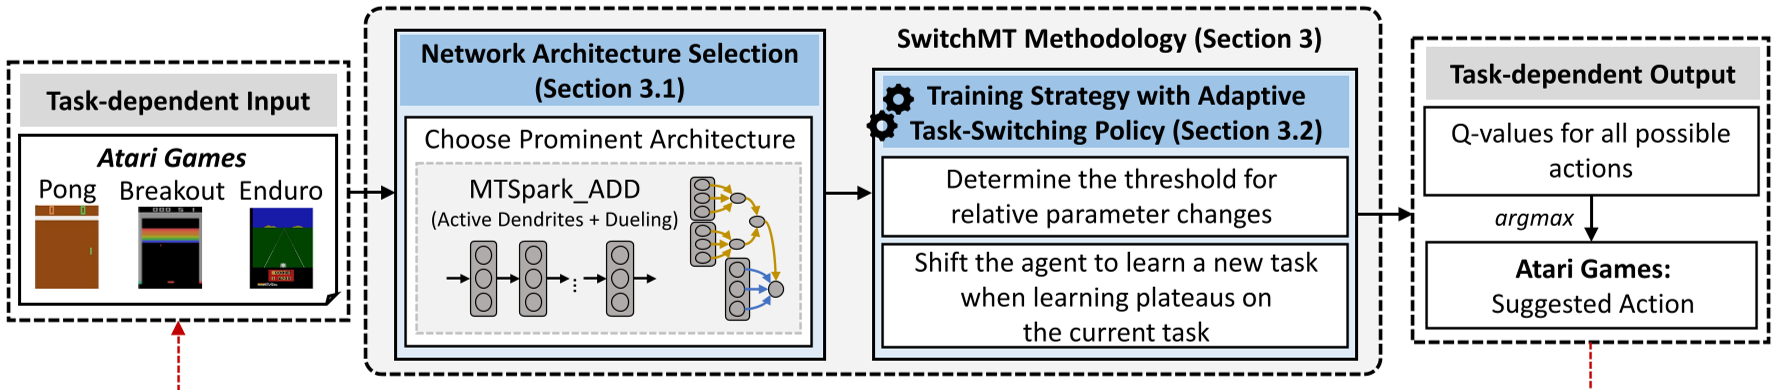 图 1:SwitchMT 方法论概览:网络架构选择与自适应切换策略。
脉冲神经元与对决结构
模型保留了 SNN 低功耗的特性,并集成了对决结构 (Dueling Structure)。该结构将状态价值(State Value)与动作优势(Action Advantage)分开评估,进一步提升了模型在不同状态下的泛化能力。
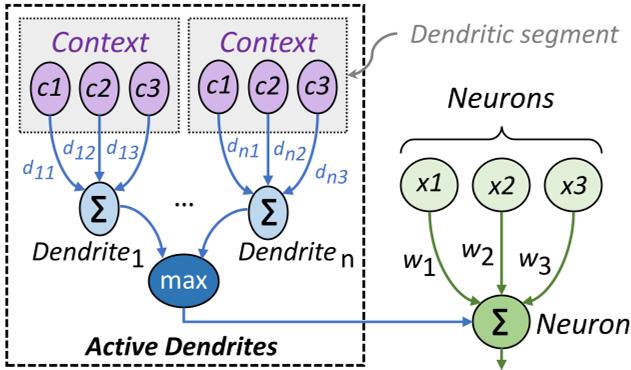 图 2:集成主动树突的脉冲神经元模型。
3. 动态策略:以“参数变化”决定切换时机
SwitchMT 最精彩的设计在于其自适应切换策略。它不再看闹钟办公,而是观察内部参数的变化率 ()。
利用 L2 范数衡量最近 个回合内网络权重的更新程度。如果变化率低于预设阈值(如 10%),说明该任务的潜在学习增益已触及天花板,系统会自动切向下一个任务。这种“学好即止”的策略建立了一种动态课程学习(Dynamic Curriculum),让模型把精力花在最难啃的任务上。
4. 实验战绩:低功耗下的强悍表现
在针对 Atari 游戏(Pong, Breakout, Enduro)的测试中,SwitchMT 展现了显著的优越性:
- 突破瓶颈:在极难的 Breakout 任务中,传统 DQN 和 baseline SNN 几乎无法得分,而 SwitchMT 获得了 5.6 分(最高达到 7 分)。
- 效率提升:在 Enduro 任务中,其得分(355.2)紧随人类专家水平,且在由于自适应切换带来的高效训练下,游戏存活时间(Episode Length)远超同类对比方法。
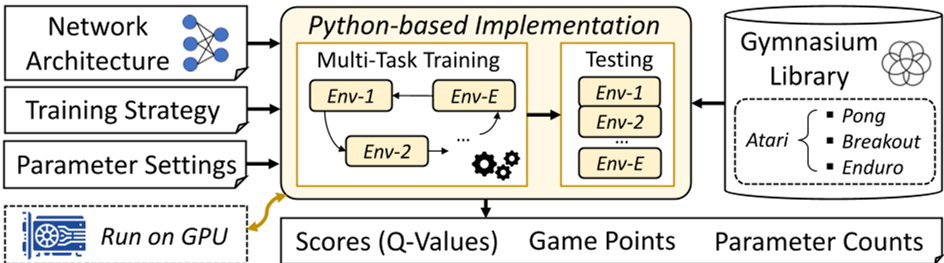 图 3:SwitchMT 在三款 Atari 游戏中的 Q-value 表现对比。
通过参数量对比(如 Table 3 所示),SwitchMT 在实现更强性能的同时,模型大小与基线持平(约 3.3M 参数)。这意味着性能的提升完全来自于算法逻辑的优化而非暴力堆砌算力。
结论与洞察
SwitchMT 的成功证明了,在神经形态计算中,“如何训练”与“用什么架构”同等重要。通过实时监控网络内部的动力学状态来指导训练流程,可以显著提升智能体的自主学习效率。这为资源受限的无人机、自动驾驶仪等边缘侧 AI 提供了一个非常具有吸引力的多任务处理范式。
局限性分析:尽管在多任务干扰上取得了长足进步,但在 Breakout 等极其依赖精细策略和长期规划的任务中,SwitchMT 离人类顶尖水平(31 分)仍有差距。未来如何进一步结合长短期记忆机制或更高级的神经可塑性规则将是研究重点。