
Programming with Data:像写代码一样调试 AI 的训练数据
Programming with Data: Test-Driven Data Engineering for Self-Improving LLMs from Raw Corpora
本文提出了 Programming with Data (ProDa) 框架,旨在解决大语言模型(LLM)在特定领域微调时缺乏反馈的“开环”问题。通过将原始语料库转化为结构化的三层知识表示,该方法实现了类似软件工程的“编译-测试-调试”循环,在 16 个学科的实验中,32B 规模的模型在经过一轮数据调试后超越了 GPT-4o 等闭源顶尖模型。
TL;DR
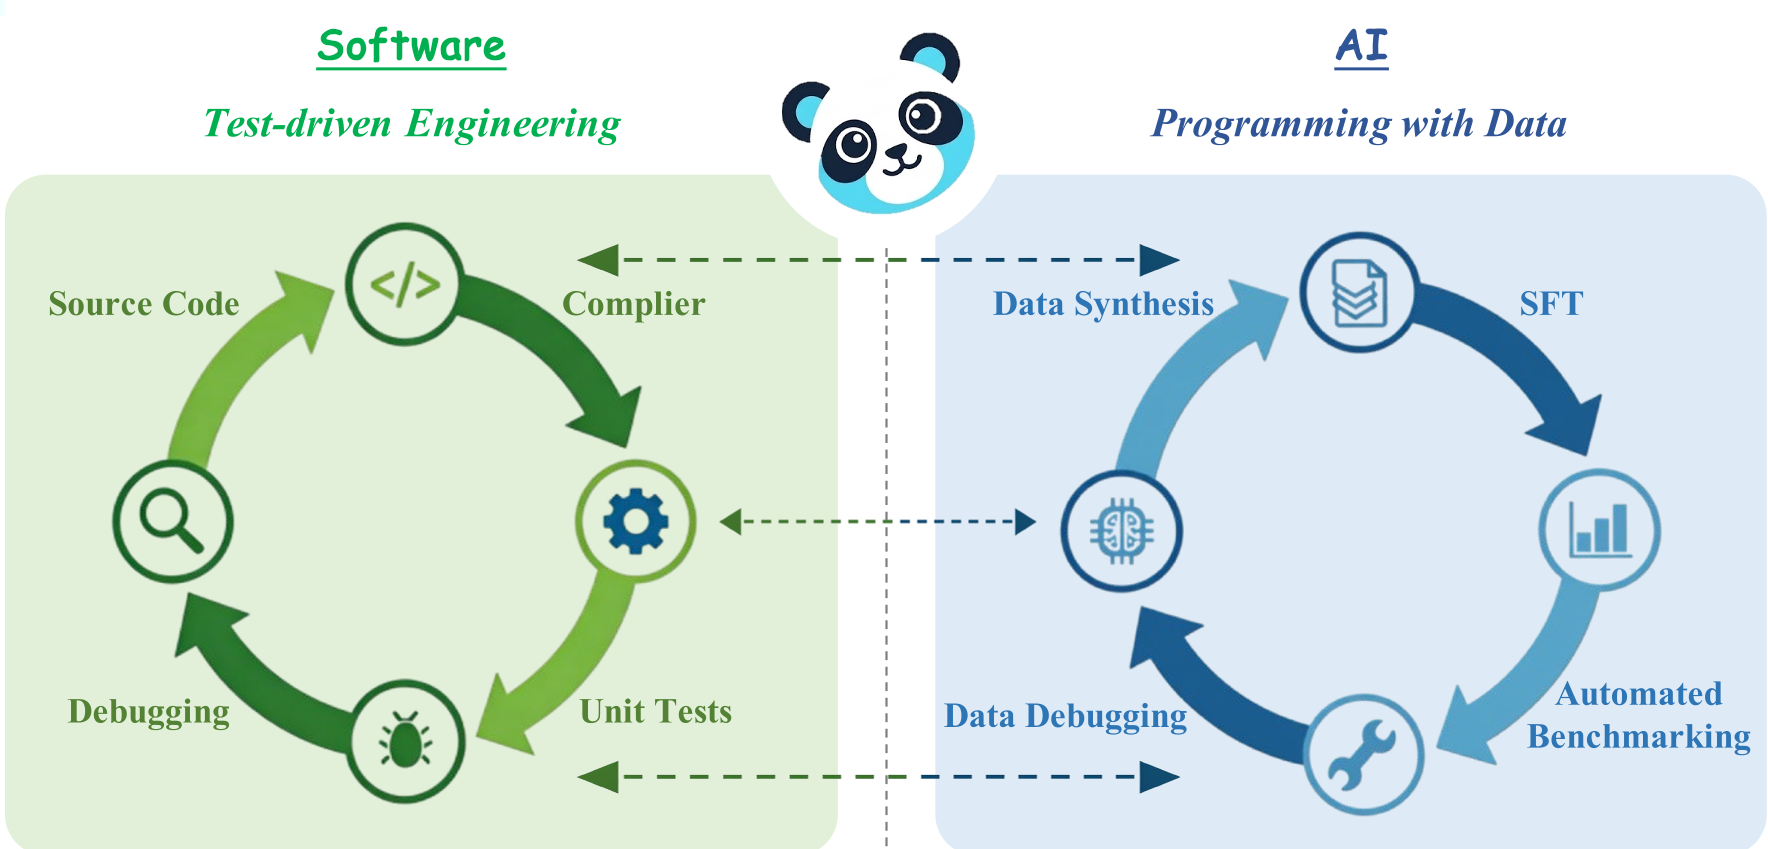
长期以来,AI 训练被视为一种“炼丹”:我们把海量数据丢进模型,祈祷它能学到东西。如果效果不好,就丢更多的数据。上海人工智能实验室与浙大等机构近期发表的论文《Programming with Data》(ProDa),彻底颠覆了这种低效的开环流程。他们提出了一种**测试驱动的数据工程(Test-Driven Data Engineering)**范式,将模型训练比作代码编译,将基准测试比作单元测试。通过这种方式,模型的每一次“幻觉”或错误都能精准回溯到数据层面的漏洞,并通过“数据补丁”进行修复。
痛点深挖:为什么“大力出奇迹”在专业领域失效了?
在通用预训练阶段,万亿级 Token 的规模掩盖了数据质量的瑕疵。但在特定的专业领域(如医学、法律、先进制造),语料库极其稀缺且结构紧密。
- 开环困境:目前的流向是“采集 -> 训练 -> 评估”。如果评估挂了,你不知道是哪条数据教错了,还是哪条数据没教。
- 结构脱节:现在的测试集(如 MMLU)通常是独立于训练集构建的。这导致测试结果只能告诉你“模型没及格”,但不能告诉你“该修哪行代码”。
核心机制:三层知识结构(The Technical specification)
ProDa 的核心直觉在于:必须要有一份“图纸”,让训练数据和测试题共用一套逻辑基础。 作者从语料库中提取了三层结构:
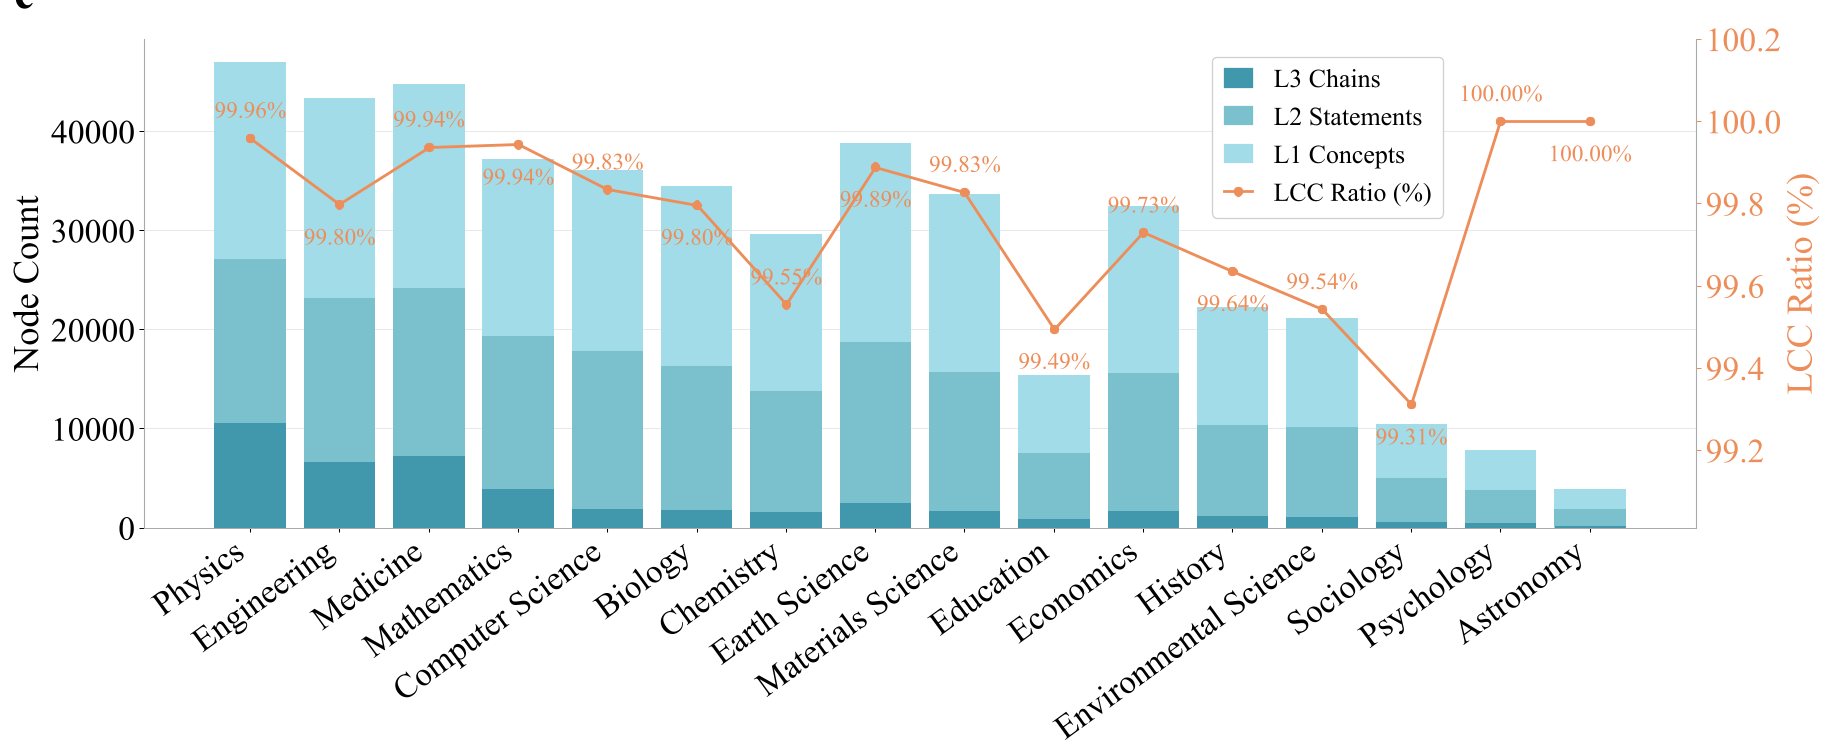
- L1 原子概念 (Key Concepts):学科的词汇表(如:Fresnel Zone)。
- L2 知识关系 (Relations):概念间的逻辑连接(如:A 是 B 的诱因)。
- L3 推理链 (Reasoning Chains):多步推导路径。
在这个范式下:
- L1/L2 构造训练集(告诉模型基础知识)。
- L3 构造测试集(考察模型是否能组合这些知识进行推理)。
闭环调试:如何精准修复模型故障?
当模型在某道 L3 测试题上报错时,Debugger 会介入:
- 分类:这是“概念间隙”(根本不认识 L1 里的词)还是“推理缺陷”(认识词但逻辑连不起来)?
- 溯源:通过共享的知识图谱,精确定位到语料库中的知识节点。
- 打补丁 (Patching):针对该节点合成强化学习样本,并与少部分旧数据(Replay)混合,重新“编译”模型。
实验战绩:开源模型的逆袭
在 16 个学科的全面评估中,ProDa 展现了惊人的效率:
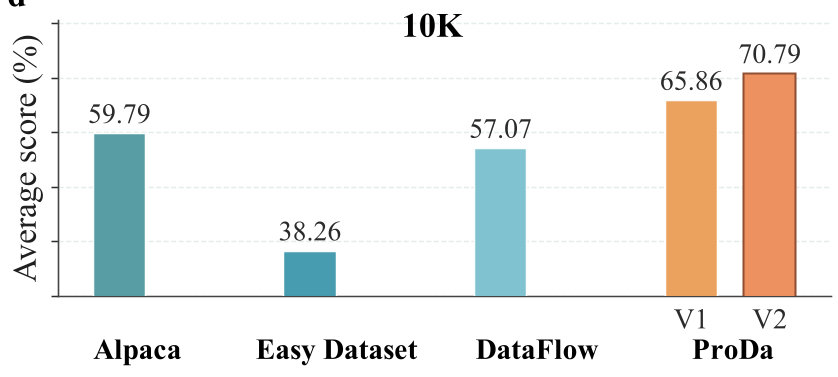
- 超越闭源巅峰:经过 V2 轮次练习的 Qwen-2.5-32B 模型,在 16 学科平均分上达到了 78.84%,击败了 GPT-4o (76.82%) 和 DeepSeek-v3 (76.69%)。
- 极高的数据样本效率:仅需 1000 个针对性修复样本(ProDa V2),提升效果就超过了盲目增加数万个通用合成样本(如 Alpaca 模式)。
- 零遗忘:在提升专业能力的同,模型在 MMLU 等通用任务上的表现不仅没有下降,甚至略有回升。
深度洞察:迈向“AI 集成开发环境” (IDE)
论文最让人兴奋的部分是他们开发了 ProDa Studio。这不再是一个实验脚本,而是一个真正的 IDE。开发者可以像观察代码行覆盖率一样,观察知识点在模型训练中的覆盖率。
总结 (Takeaway): ProDa 的成功标志着数据工程从“劳动密集型”向“逻辑密集型”转变。它向我们展示了:与其去纠结模型架构的细微调整,不如去精耕细作那份指导模型行为的“数据规格说明书”。对于正在构建垂直领域垂直大模型的团队来说,这种“打补丁”的思想极具落地价值。
局限性与展望
虽然 ProDa 在结构化文本上表现卓越,但在处理极具跳跃性的非线性知识或多模态数据时,如何自动提取高质量的 L3 推理链仍是挑战。未来的方向可能会结合 RAG (检索增强生成) 与 机械可解释性 (Mechanistic Interpretability),实现更底层的神经元级“代码调试”。