
Concept Fields:将语料库视为“概念场”,像物理模拟一样捕捉 LLM 幻觉
Text Corpora as Concept Fields: Black-Box Hallucination and Novelty Measurement
本文提出了 Concept Field (概念场),通过将文本语料库映射为嵌入空间中的局部漂移向量场与点态不确定性,来量化文本序列的可靠性。该方法利用 Vector Sequence Database (VSDB) 存储句子路径,在无需模型内层参数(Black-box)的情况下,实现了 SOTA 级别的幻觉检测与创新性度量。
TL;DR
来自 Oracle 的研究团队提出了一种名为 Concept Field (概念场) 的黑盒检测方案。该方法跳出了“语义相似度”的传统范式,将语料库想象成一个充满了“流体”的向量空间。通过测量 LLM 输出的句子转换是否符合语料库中预设的“流动方向”,该方法能精准识别幻觉(Hallucinations)并度量创新(Novelty),其在法律和文学领域的测试中表现出了极高的准确率与通用性。
背景定位
在 LLM 落地过程中,落地可靠性(Groundedness) 是 compliance(合规)与 creativity(创意)任务的核心。传统方法要么太贵(LLM-as-judge),要么太局限(白盒探测)。本文提出的 Concept Field 是一项底层创新,它通过构建 VSDB (向量序列数据库),让每一条检测结果都能追溯到原文,且计算开销仅需普通 CPU 即可承担。
痛点深挖:余弦相似度的“失效”
目前最常用的检索增强生成(RAG)评价高度依赖余弦相似度。然而,作者在一个实验中揭示了其致命伤。 例如以下两个句子:
- "资金可以用于奖励..."
- "资金不可以用于奖励..."
在 SONAR 嵌入空间中,两者的余弦相似度竟然高达 0.98,甚至比原义改写的相似度还高!这意味着传统的相似度匹配根本无法捕捉到这类涉及逻辑取反的严重幻觉。
核心机制:从粒子轨迹到概念流
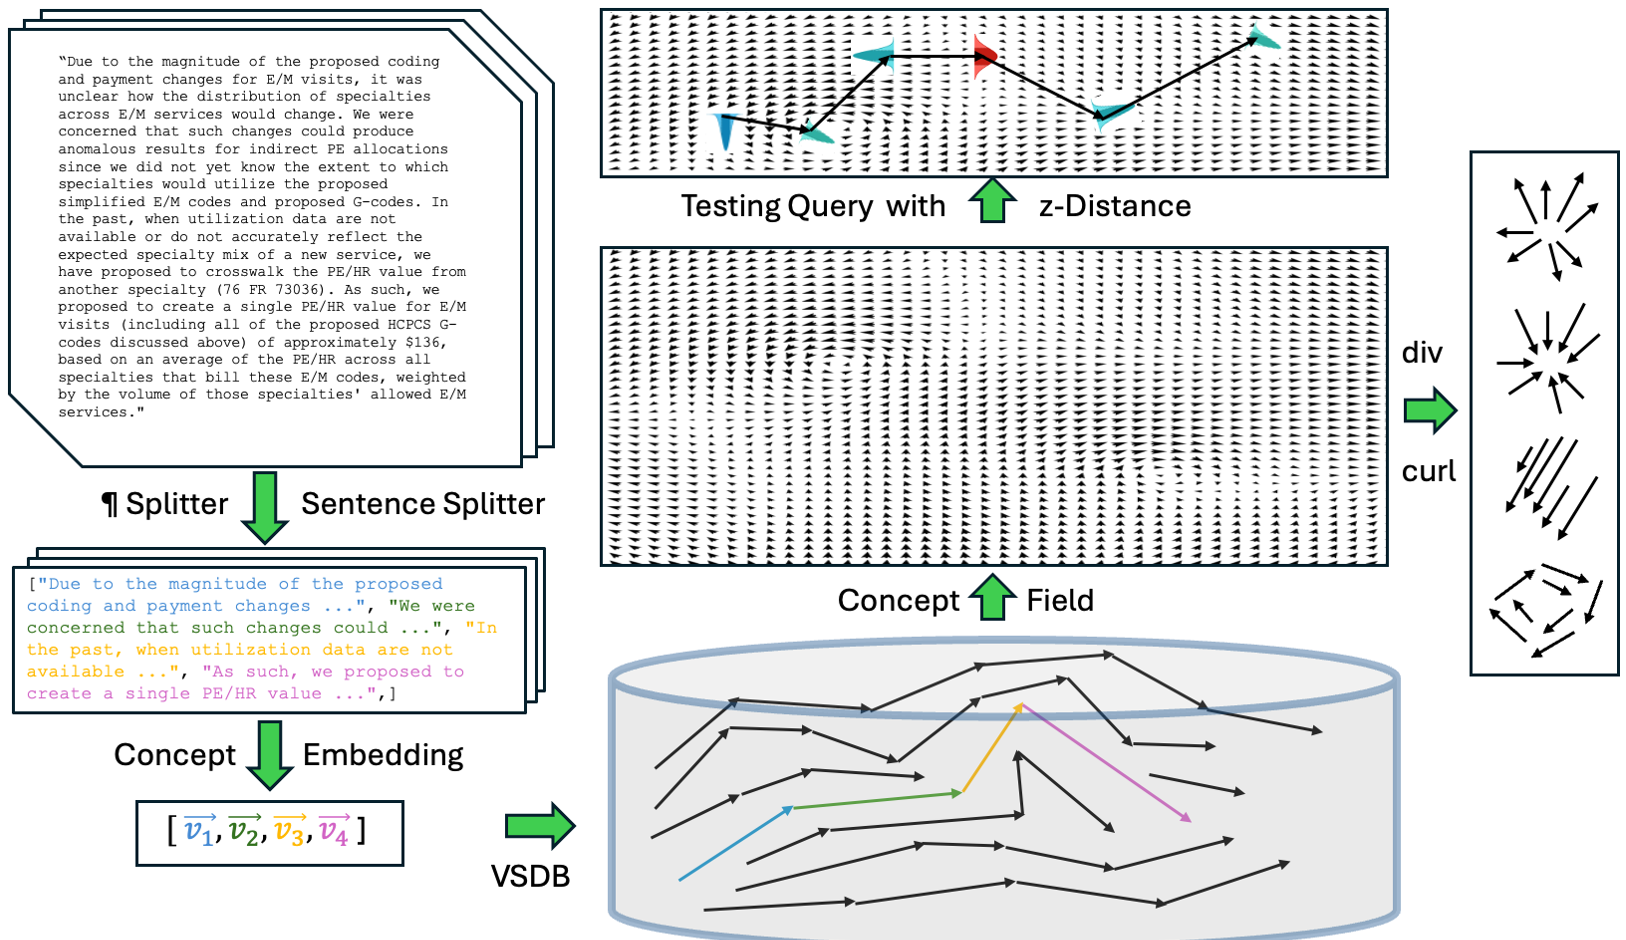
作者引入了物理学的直觉:将语料库中的文章视为嵌入空间中的一条条“粒子轨迹”。
1. 向量序列数据库 (VSDB)
与普通的 VDB 不同,VSDB 不仅存向量,还存序列位置和下一个位置的增量 ()。
2. IDW 概念场插值
对于空间中任意一点,通过对周围邻居的 进行反距离加权(IDW)平均,我们可以预测在该语义点上,逻辑应该往哪个方向“流动”。
3. 指标:语义的 Z-距离
当 LLM 生成一个句子对 时,我们计算其实际增量与该处概念场预测均值 的距离:
如果 极小,说明 LLM 顺着语料库的逻辑在走;如果 极大,说明这可能是一次“逻辑起飞”(幻觉)或“神来之笔”(创新)。
实验与结果:2D 弹道模拟到千亿级语料
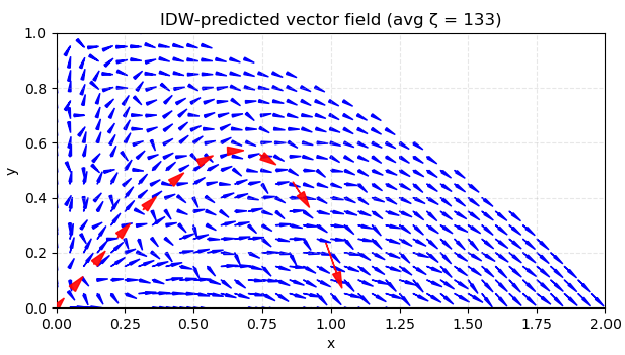
为了验证直觉,作者先在 2D 物理弹道上进行了模拟(见下图)。当给定的 query 轨迹符合抛物线物理规律时, 保持低位;一旦加入空气阻力改变物理模型, 瞬间飙升。
在真实案件(CFR 法律文本)中,该方法证明了其作为“幻觉探测仪”的威力:
- 低噪声环境:在语义支持充足的区域,AUC 高达 0.984。
- 跨域稳定性:在文学创作(Gutenberg)任务中,无需重新调优超参数,模型依然表现稳健。
深度洞察:语义的“散度”与“旋度”
论文最有趣的部分在于对概念场的几何分析:
- 高散度区域(Divergence):代表“逻辑源头”(如某个法律定义的起点)。
- 高旋度区域(Curl):代表“绕圈子”或“语义空洞”,这些地方通常是语料库缺乏训练数据的地方,也是 LLM 最容易胡说八道(幻觉)的高风险区。
总结与展望
Takeaway: Concept Field 为 AI 的信任评估提供了一个可解释的“坐标系”。它告诉我们,判定 LLM 是否在撒谎,不仅要看它说了什么,更要看它的逻辑走向是否偏离了人类知识的既定流场。
局限性:该方法高度依赖嵌入模型(如 SONAR)的质量和语料库的密度。在极其稀疏的语义空间,场估计会变得极不稳定。
未来的企业级 RAG 架构或许可以集成一个专门的 Concept Field 监控层,实时阻断任何 值异常的生成任务。