
深度学习泛化新论:从内核分区到 5 倍速“顿悟”
A Theory of Generalization in Deep Learning
本文提出了一种关于深度学习泛化的非渐近理论,通过经验神经切线核(eNTK)将输出空间划分为信号通道和噪声水库。核心方法是基于留一法(Leave-one-out)导出的“群体风险训练”算法,在 Adam 优化器之上添加一个 SNR 门控。该工作统一解释了良性过拟合、双峰下降、隐式偏置和 Grokking 等现象,并在 DPO 微调和 PINNs 任务中实现了 SOTA 性能。
TL;DR
斯坦福大学研究员 Elon Litman 与 Gabe Guo 近期发布了一项重磅研究,提出了一种能够解释特征学习(Feature Learning)全过程的泛化理论。该理论的核心逻辑极其简单:训练过程将输出空间分割为“信号通道”和“噪声水库”。作者基于此导出的群体风险更新法则(一种 Adam 插件),不仅能让模型在算法任务中快 5 倍“顿悟”,还能在含噪声的 DPO 微调中显著提升模型表现。
背景:被误解的“过拟合”
经典的泛化理论在面对现代神经网络时几乎是失效的。我们观察到:
- 良性过拟合 (Benign Overfitting):模型可以把训练噪声拟合到零,但测试误差依然很低。
- Grokking (顿悟):模型在长时间过拟合后,突然学会了泛化。
作者指出,问题的根本在于内核的测试不可见性 (Test-Invisibility)。如果一个噪声方向在测试集上是看不见的,那么模型拟合得再狠,也不会影响测试表现。
核心机制:信号通道与水库的“生死劫”
作者将模型的演化抽象为输出空间中的动力学过程。通过引入累积耗散 (Cumulative Dissipation) 算子 ,输出空间被划分为两个阵营:
- 信号通道 (Signal Channel):训练能够有效降低损失的方向,这些方向对测试集是“可见”的。
- 水库 (Reservoir):对应内核近零特征值的维度,误差被“困”在这里。
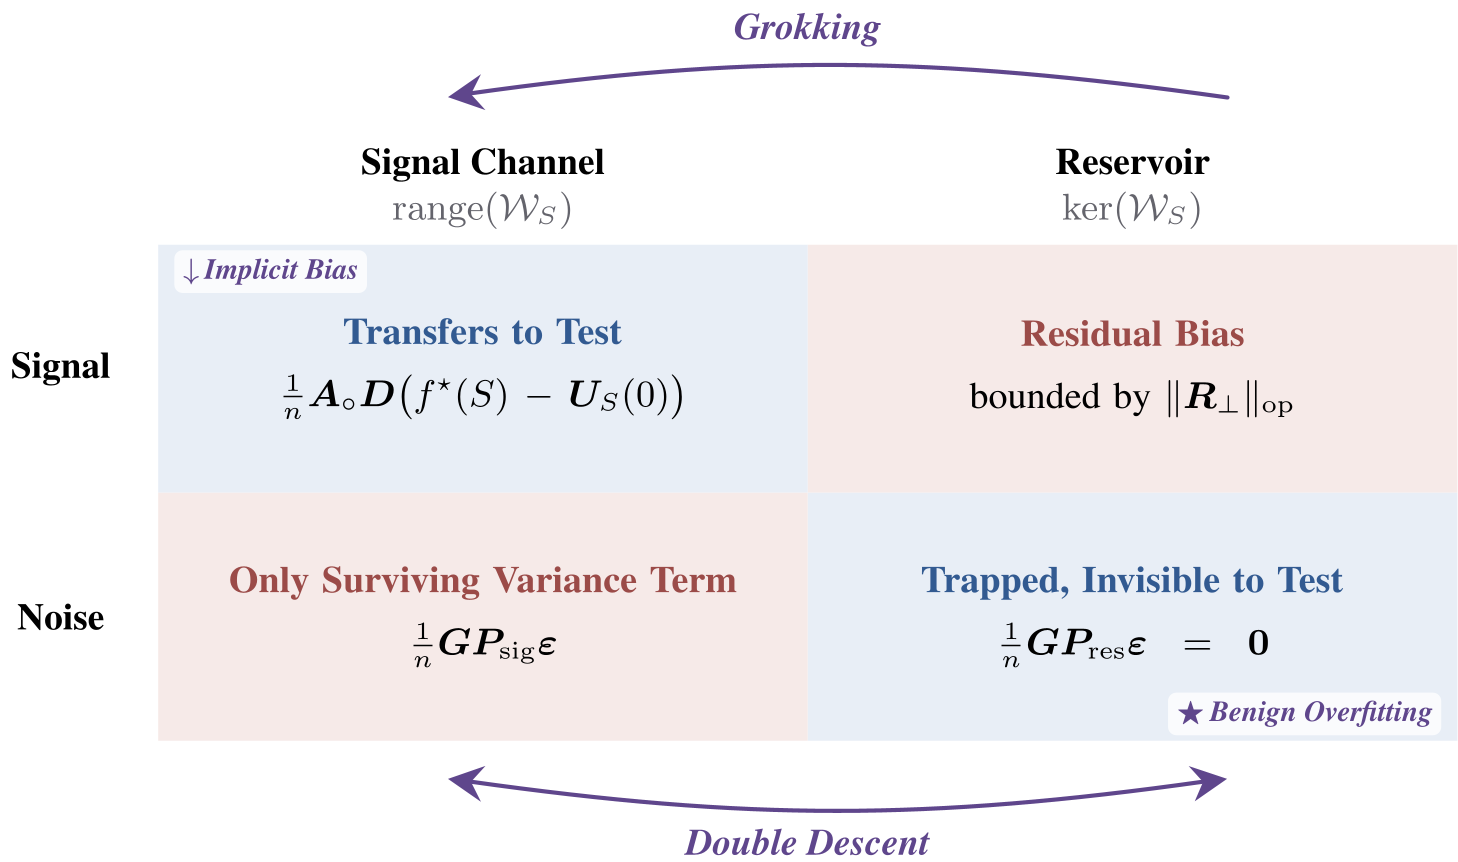 图 1:测试误差的四格分解。蓝色部分代表正确泛化,红色代表失败模式(如信号掉进水库或噪声混入信号通道)。
特征学习下的耦合
不同于传统的 NTK 假设内核冻结,本理论证明了:即使内核在训练中发生了 的剧烈漂移,测试集的移动轨迹依然由训练集的累积耗散所决定。这一发现打破了“只有懒惰制度才能分析泛化”的迷信。
群体风险训练:把验证集“集成”进 Adam
这是该论文最硬核的贡献:作者利用交换性 (Exchangeability) 证明,我们可以从当前 Minibatch 的梯度波动中直接读出群体风险。
通过计算梯度的信噪比 (SNR),算法定义了一个每参数门控 (Per-parameter Gate): 简而言之:如果一个参数在当前 Batch 里的表现纯粹是噪声(标准差大得出奇),那它就该“闭嘴”,不许更新。
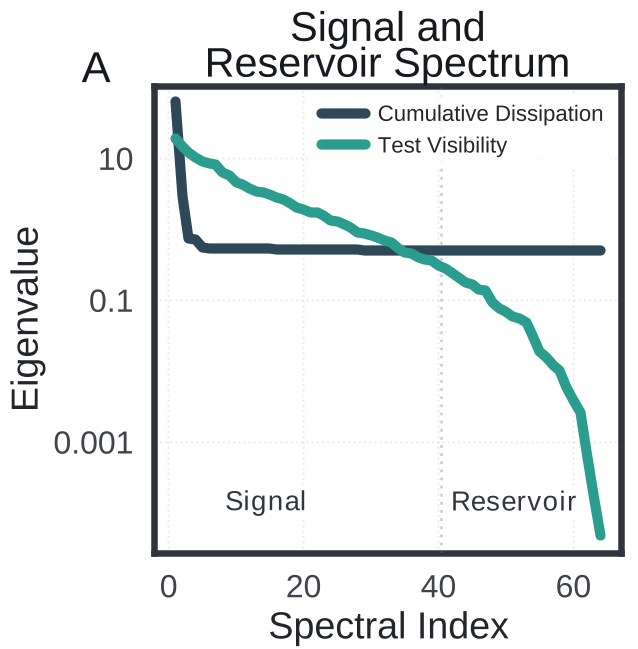 图 2:特征学习下的内核特征结构演化。即使内核漂移达 4.8 倍,训练与测试的耦合关系依然稳固。
实战战绩:DPO 与 Grokking 的大捷
- 顿悟加速:在处理模运算等算法任务时,通过过滤掉那些只负责“死记硬背”的噪声成分,模型达到 95% 准确率的时间缩短了 4.9 倍。
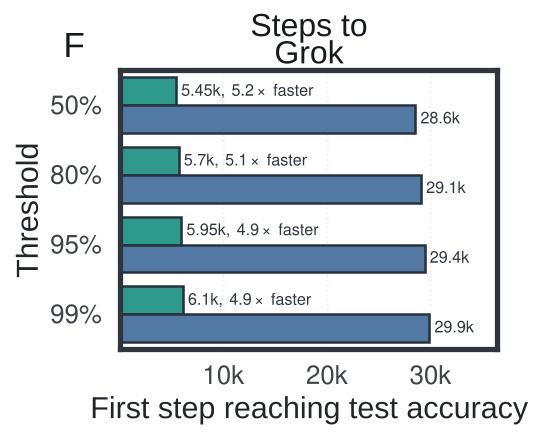 图 3:群体风险训练极大地缩短了顿悟延迟(右部绿色曲线)。
- DPO 微调防噪声:在大模型对齐中,如果标注偏好存在 30% 的噪声,传统 AdamW 会被带偏,而新方法保持了极高的奖励准确率,且与参考策略的漂移量减少了 3.05 倍。这对于缺乏高质量标注数据的场景简直是救星。
总结与洞察:走向物理直觉
这篇论文的伟大之处在于它赋予了泛化理论一种“物理直觉”。它告诉我们:泛化不仅仅是参数量的博弈,更是动力学方向的选择。通过在优化层面直接测量并截断噪声拟合路径,我们可以在根本上解决过拟合问题。
局限性:虽然理论非常优雅,但在高维流行(Manifold)场景下,填充距离(Fill Distance)的限制可能导致误差界限变得不够紧致。未来的工作或许需要结合更强的几何先验来进一步细化这些界限。