
[EMNLP 2025] Think Less, Know More: 状态感知与知识引导下的高效推理压缩
Think Less, Know More: State-Aware Reasoning Compression with Knowledge Guidance for Efficient Reasoning
本文提出了 STACK,一个状态感知的长思维链 (CoT) 压缩框架,旨在解决大型推理模型 (LRM) 中的“过度思考 (Overthinking)”问题。该框架通过引入知识引导的对比解码、基于本地熵的状态检测以及答案收敛早停机制,在显著降低模型推理延迟的同时提升推理准确性。
TL;DR
在大型推理模型(LRMs)如 DeepSeek-R1、o1 席卷学术界的今天,模型“想得太多”导致的推理延迟和冗余已成为实际落地应用的主要障碍。本文提出的 STACK 框架,通过精准捕捉模型推理过程中的“犹豫时刻”,动态引入外部知识校正并压缩冗余链条。它不仅实现了近 60% 的文本量压减,更在 AIME 等高难度数学任务中达成了 4.8% 的准确率飞跃。
背景定位:从“暴力计算”转向“精准推理”
长思维链(Long CoT)的本质是模型通过自我博弈、验证和反思来换取推理精度的提升。然而,当前的训练范式往往诱导出一种“过度思考(Overthinking)”的倾向:无论题目简单与否,模型都会进行冗长甚至循环的无效推理。STACK 并非简单地截断输出,而是在学术坐标系中开辟了**步级动态调节(Step-wise Adaptive Regulation)**的新路径,让模型学会在确定的环节“快思考”,在存疑的环节“借外力”。
核心洞察:为什么要“状态感知”?
冗余的来源是异质的:
- 高置信冗余:模型知道答案,但还在重复描述已知事实。
- 低置信偏差:模型陷入逻辑漏洞或知识盲区,反复挣扎(犹豫状态)。
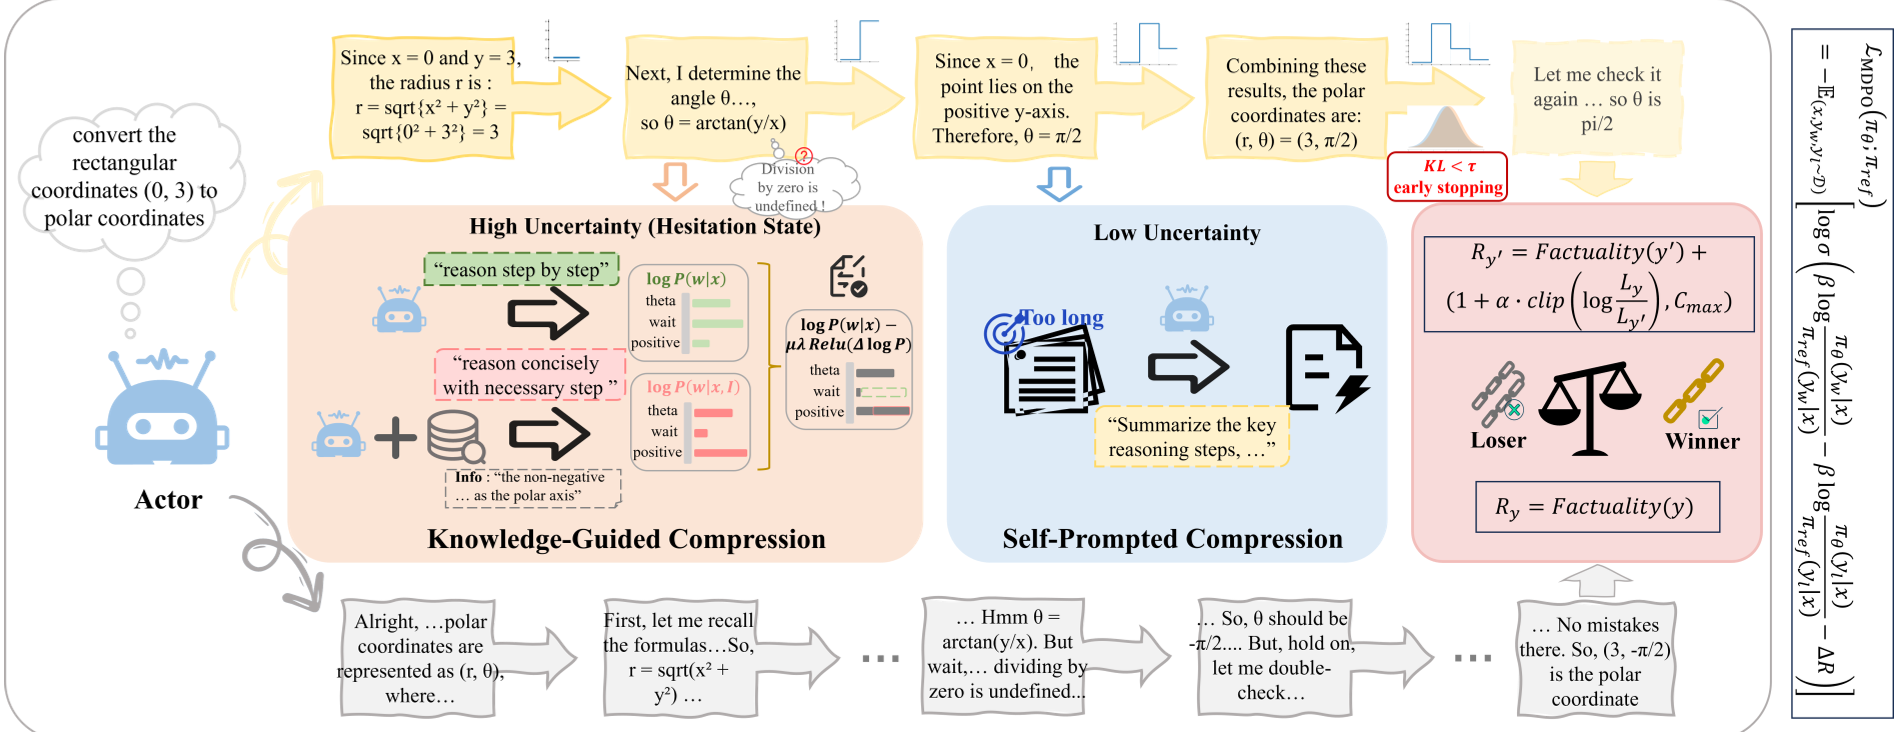
STACK 通过 本地熵 (Local Entropy) 构建了一个实时的监测器。如果 Entropy 突增,说明模型进入了“犹豫状态”,此时系统会自动触发知识引导。
技术详解:STACK 的四大杀手锏
1. 知识引导的对比解码 (KGCD)
当监测到犹豫时,STACK 并不只是把知识塞进 Context,而是使用对比解码。
- 逻辑:对比“原始模型输出分布”与“知识限制下的模型分布”。
- 直觉:如果某个 Token 在没有外部知识支持时概率很高,但在有知识支持时概率骤降,说明它是“脑补”的概率大,从而被抑制。
2. 答案收敛早停机制
模型经常在得出结论后还进行长时间的“自洽性校验”。STACK 通过计算连续推理步骤后答案分布的 KL 散度。当信息增益(Information Gain)低于阈值时,直接在结论处“Cut”,极大减少了无效 Token。
3. 基于奖励差值的 MDPO 训练
传统的 DPO 只是简单的二元选择(好 vs 坏)。STACK 引入了 MDPO (Margin DPO),将压缩率和准确率量化为奖励 ,并计算 。
- 效果:损失函数能够感知“相比于原链路,这条压缩链路到底好了多少”,从而让策略梯度更新更加精准稳定。
实验战绩
STACK 在 DeepSeek-R1-Distill-Qwen 系列模型上表现惊人。尤其是在 AIME24 数学竞赛题中,1.5B 这样的小模型在 STACK 的加持下,不仅速度翻倍,ACC 甚至由于外部知识的及时校正提升了显著。
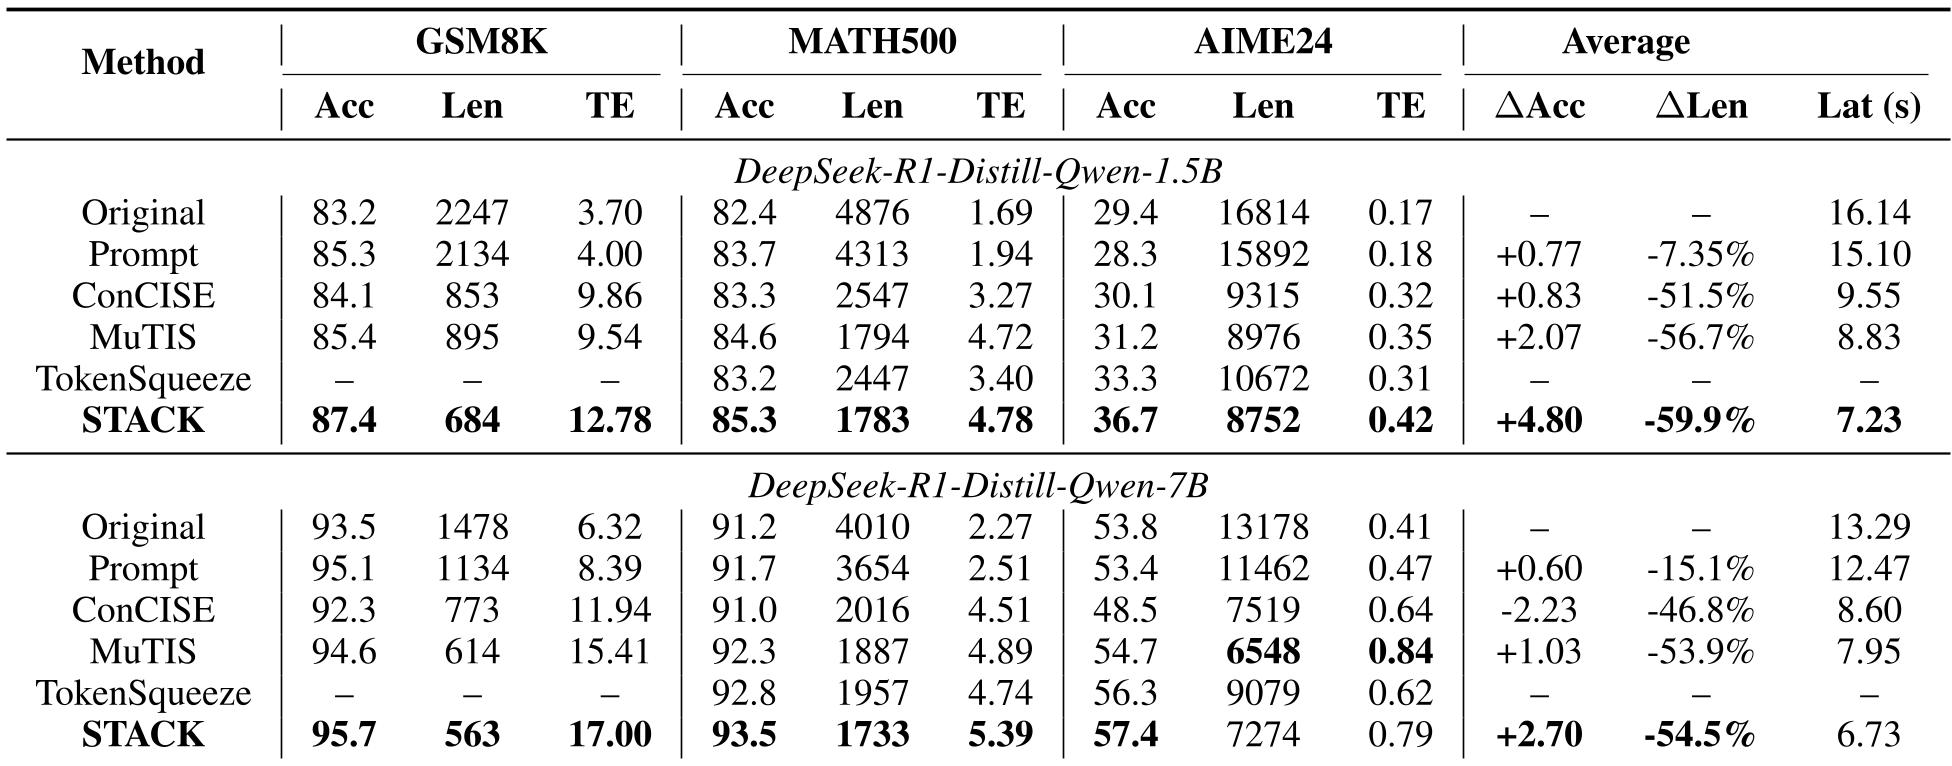
- 效率指标:Token Efficiency (TE) 在各个规模模型上均实现翻倍。
- 小模型逆袭:经过 STACK 优化的 1.5B 模型,在逻辑严密性上逼近了原始的 7B 模型。
深度思考:未来的启发
STACK 的成功揭示了一个深刻的学术趋势:推理模型的未来不在于更长的 CoT,而在于更高密度的信息熵。
然而,该工作也存在一定的局限性:目前的检索依然依赖于外部搜索引擎(如 Bing),这在实时性要求极高的场景下会产生 IO 瓶颈。未来,将这种“步级监控”与内部记忆层或更快速的向量数据库结合,将是工业界落地的关键。
总结一句话:好的推理模型应该像人类专家一样——在轻舟已过万重山时迅速决断,在深水区时精准引用外部证据。