
Thinking with Visual Primitives:让多模态模型边“指”边“想”
Thinking with Visual Primitives
本文提出了 Thinking with Visual Primitives (TwVP),这是一种旨在解决多模态大模型 (MLLMs) 复杂推理任务的新型框架。通过将坐标点 (Points) 和边界框 (Bounding Boxes) 提升为“最小思维单元”,并将其直接交织在思维链 (CoT) 中,模型实现了即便在紧凑的参数规模与极低视觉 Token 预算下,依然在空间推理和拓扑导航等任务上超越了 GPT-5.4 和 Claude-Sonnet-4.6。
TL;DR
DeepSeek-AI 团队近日发布的论文提出了一种革命性的多模态推理框架。它不再仅仅让模型“看图说话”,而是要求模型在思考过程中,像人类指着地图寻路一样,实时在思维链(CoT)中嵌入点(Points)和框(Boxes)。这种被称为“视觉原语”(Visual Primitives)的方法,成功解决了长久以来 MLLM 在密集计数和复杂空间逻辑搜索中的“逻辑崩溃”问题。
痛点深挖:为何模型“看清了”却“想错了”?
在多模态领域,业界一直致力于解决感知鸿沟(Perception Gap)——即通过增加分辨率让模型看清细节。然而,作者提出了一个更深刻的瓶颈:引用鸿沟(Reference Gap)。
当你在一个复杂的迷宫中寻找出路,或者在几百个相似的细胞中计数时,纯文字的记录(如“那个在左边的、红色的...”)很容易产生歧义。随着推理步数的增加,模型的“文本思维”会逐渐脱离“视觉现实”,从而产生严重幻觉。
方法论详解:视觉原语作为“最小思维单元”
为了弥补这一鸿沟,作者将空间坐标点和边界框定义为视觉原语,并将其提升到与 Token 同等的地位。
1. 架构:极致的端到端压缩
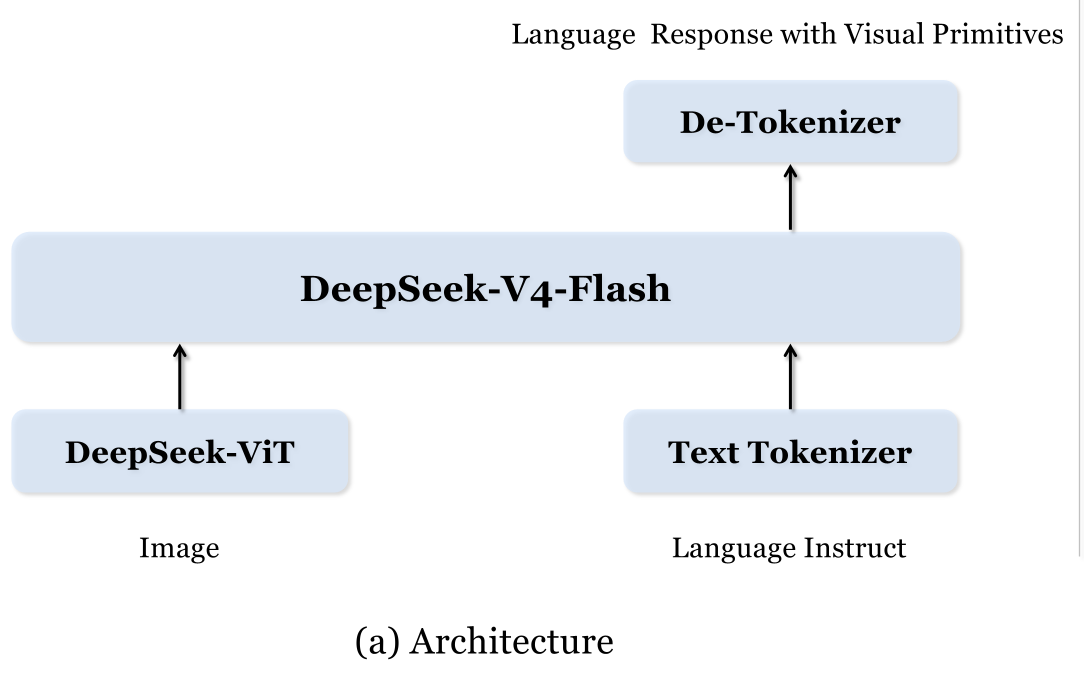
模型基于 DeepSeek-V4-Flash(MoE 架构),其核心亮点在于极致的视觉效率:
- 3x3 空间池化:将相邻 9 个 patch 压缩为 1 个。
- Compressed Sparse Attention (CSA):在 LLM 内部进一步将 KV 缓存压缩 4 倍。
- 结果:从原始像素到最终 KV 缓存,实现了惊人的 7,056倍 压缩率,这意味着模型可以用极少的资源处理极其复杂的视觉推理。
2. 训练 pipeline:冷启动与强化学习
为了教会模型“指读”,研究团队构建了一个精密的流程:
- 数据清洗:从 4000 万个 Web 样本中剔除无意义的“机器码”类标签,保留具有语义价值的空间标注。
- 冷启动(Cold-Start):针对计数、空间推理、迷宫导航和路径追踪四个维度,手动构建了高质量的思维链示例。
- 特殊 RL(基于 GRPO):
- 针对迷宫任务,设计了壁垒违规惩罚和探索进度奖赏。
- 针对计数任务,引入了平滑指数衰减奖赏(允许微小误差,重罚离群预测)。
实验与结果:降维打击般的空间智力
实验结果显示,引入“视觉原语”后,模型在传统 MLLM 表现极差的拓扑推理任务上展现了统治力:
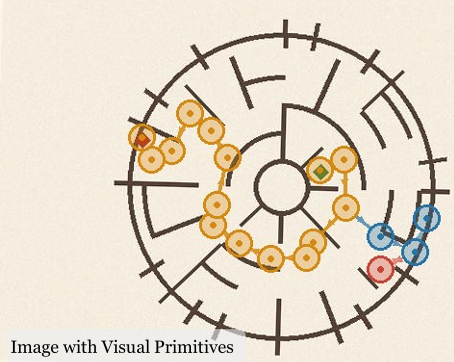
- 迷宫导航:在 DS_Maze_Navigation 榜单上,模型准确率高达 66.9%,而 GPT-5.4 甚至不足 51%。
- 路径追踪:在高度重叠的曲线图中寻找终点,模型通过生成密集的坐标序列进行逐点追踪,准确率远超所有闭源 Frontier Models。
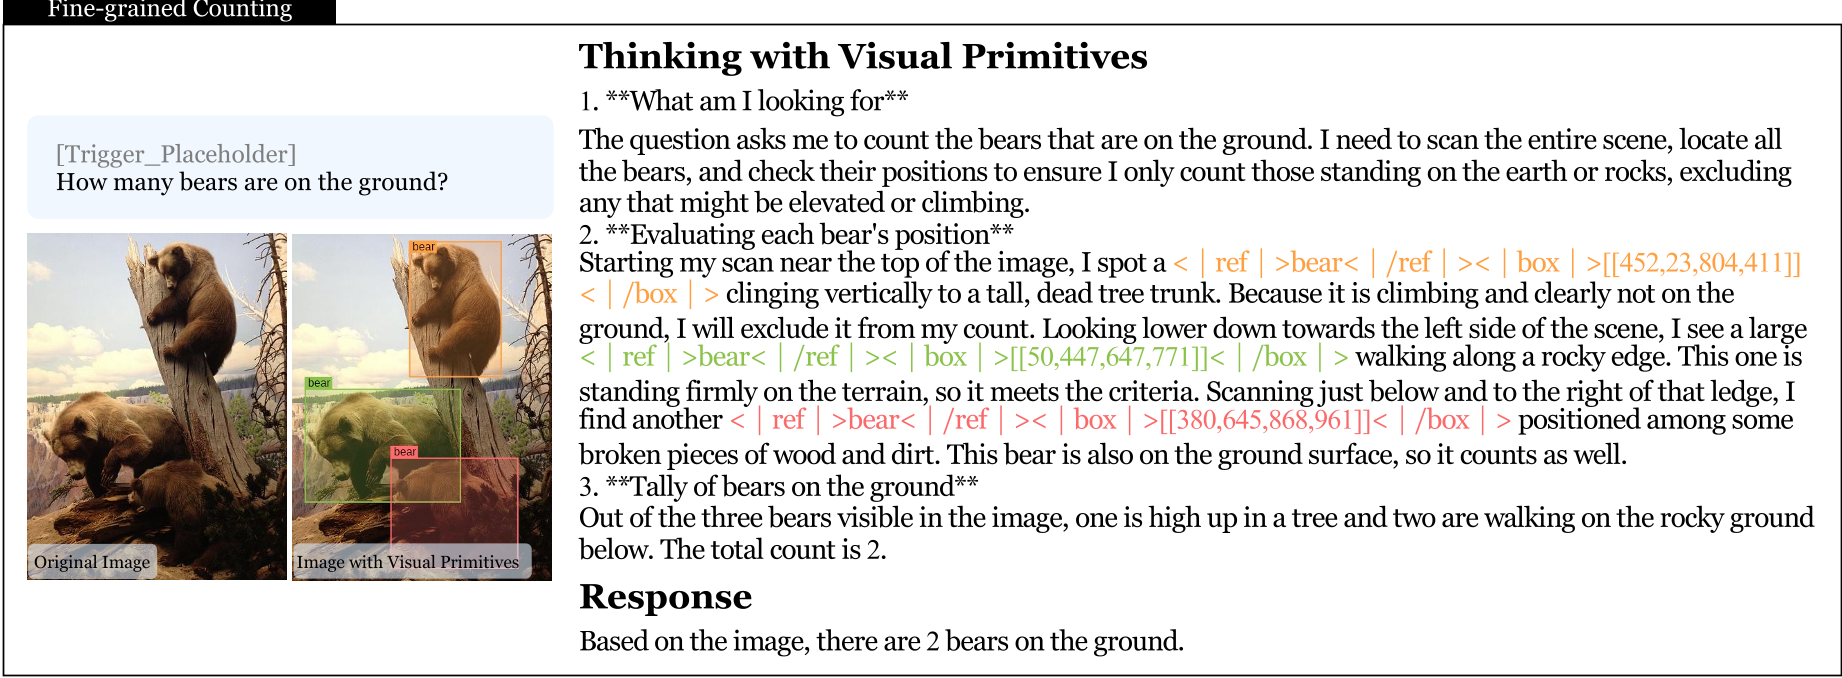
在定性分析中(见图 7, 8),模型能够精准识别出“图中谁更重”、“桌子上有几个宝可梦”等细粒度问题。通过 <|point|> 特殊 Token,模型生成的思维轨迹清晰地展示了它如何一步步在视觉空间内扫遍所有目标。
深度洞察:迈向“系统 2”的物理归口
本文的价值不仅仅在于刷榜,更在于它揭示了 MLLM 进化的一个重要方向:具身化思考(Embodied Thinking)。
- 锚定效应:将文本 Token 强制映射到坐标,相当于给 LLM 的逻辑推理上了一道“物理枷锁”,大大降低了多步推理中的漂移风险。
- 效率革命:证明了“视觉压缩”与“视觉推理”并不矛盾。只要引入了正确的引用机制,低 Token 预算同样能产生高阶智力。
局限性与挑战
作者也坦诚指出,目前模型仍依赖特定的触发词来开启“原语思考”模式。未来的终极形态应当是模型能够根据问题复杂度,自主决定是否需要动用这种高消耗、高精度的空间指代能力。
总结
《Thinking with Visual Primitives》告诉我们,通往通用人工智能(AGI)的道路,或许不仅需要模型有“璀璨的辞藻”,更需要它有一根能够指向物理世界的“手指”。