
Thinking with Visual Primitives:让 AI 像人一样“指着图”进行深度思考
Thinking with Visual Primitives
DeepSeek 团队提出了 Thinking with Visual Primitives (TVP),这是一种新型的多模态大模型推理框架。该方法将点(Points)和边界框(Bounding Boxes)提升为“最小思维单元”,使模型在 Chain-of-Thought 推理过程中能直接交织空间参考,在空间推理和拓扑任务上达到了与 GPT-5.4 和 Claude-Sonnet-4.6 相当的 SOTA 水平。
TL;DR
DeepSeek 团队发布的这篇论文,通过将**点(Points)和边界框(Boxes)**设计为推理链中的“最小思维单元”,有效解决了多模态大模型(MLLM)在复杂空间推理中的“参考间隙”问题。该模型不仅能够精准计数和推理空间关系,甚至展现出了破解复杂迷宫和追踪缠绕曲线的逻辑能力,其表现足以媲美甚至超越 GPT-5.4 等顶尖闭源模型。
1. 痛点:看得清,不代表想得明白
在 MLLM 领域,人们一直致力于解决“感知间隙(Perception Gap)”,即通过提高分辨率让模型看清细节。然而,DeepSeek 的研究者发现,即使模型看清了每一个像素,它们在处理诸如“数一下这堆糖果里有多少个红色”或“这条线通往哪里”的任务时,依然会胡言乱语。
这就是参考间隙(Reference Gap):
- 语言的无力感:用纯文字描述复杂的空间位置非常低效且容易产生歧义。
- 逻辑链脱节:在多步推理中,模型容易在思维过程中“跟丢”它正在讨论的视觉对象。
2. 核心机制:将坐标作为“思维基元”
作者的灵感源于人类:当我们数数或走迷宫时,手指会自然地指点。TVP 框架将这种“点对点推理”内化到了模型中。
2.1 架构革新:极致压缩
模型基于 DeepSeek-V4-Flash 架构,采用 Compressed Sparse Attention (CSA) 机制。
- 惊人的效率:从原始像素到最终 LLM 推理时的 KV Cache,实现了 7056倍 的压缩比。
- Token 节省:仅需极少量的 Visual Token 即可维持高质量的认知深度,这为长上下文推理提供了巨大优势。
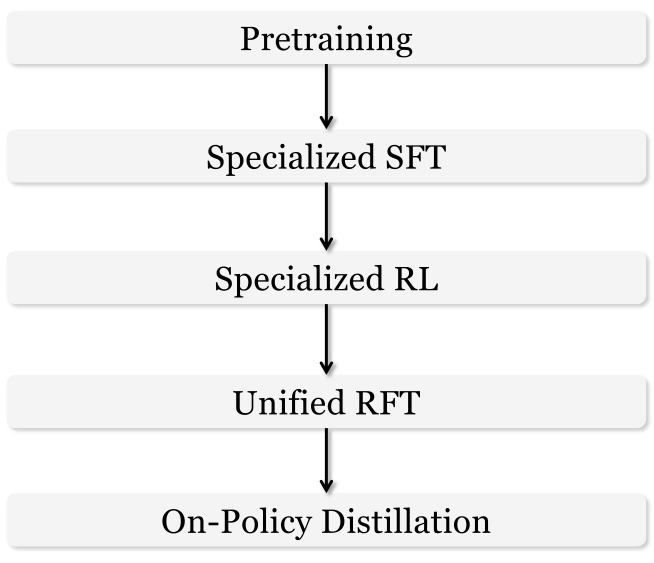
2.2 推理范式:Interleaved Thinking
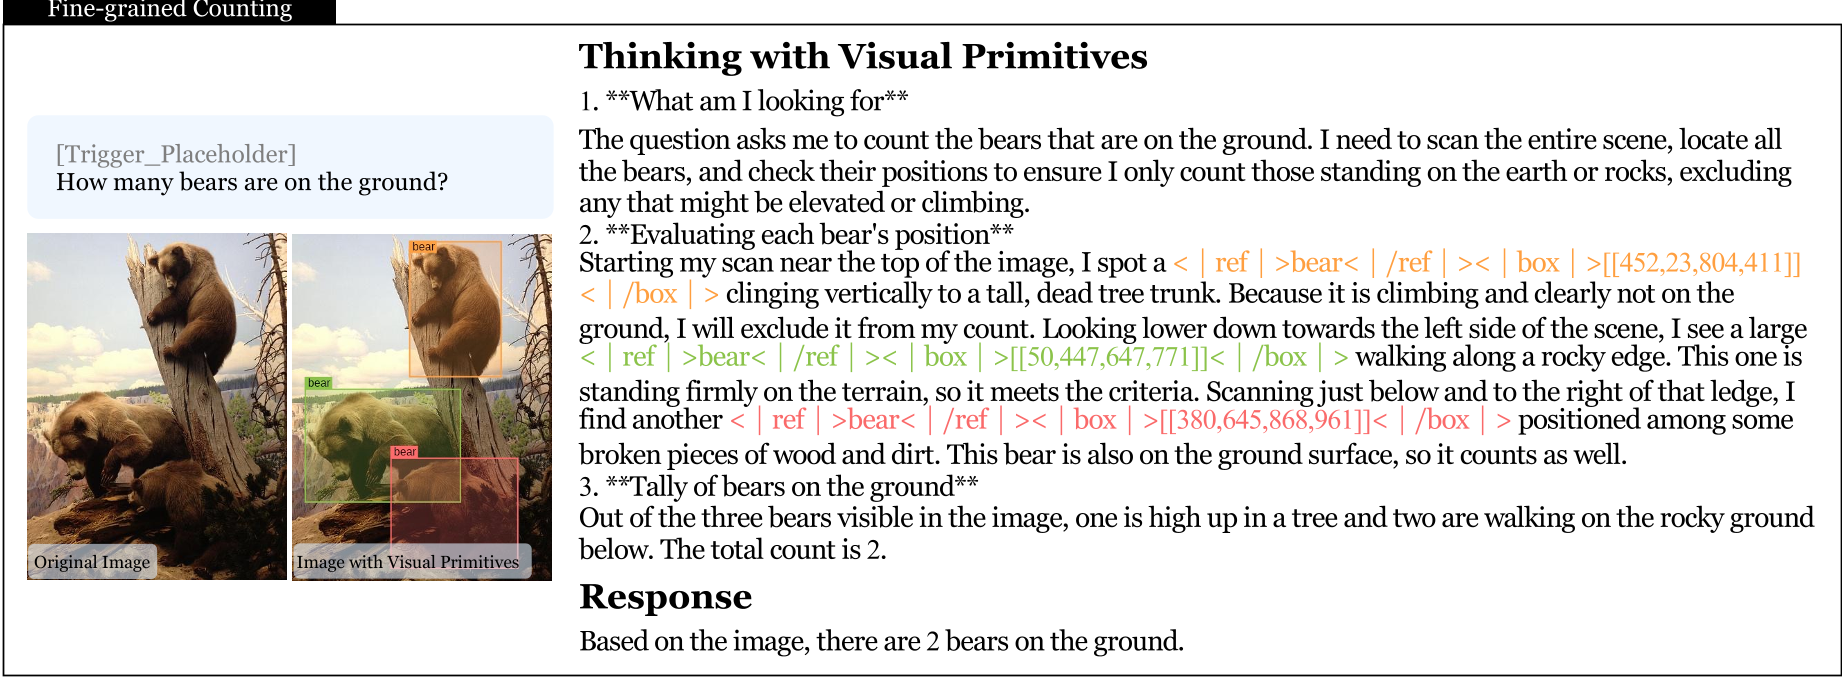
模型产生的不仅仅是文字,而是文字与坐标的交织体:
Thinking: 首先,我定位到... <|ref|>目标对象<|/ref|><|box|>[[x,y,x,y]]<|/box|>,接着根据它的位置...
3. 被“冷启动”唤醒的特殊能力
为了训练这种能力,团队构建了四大类极具挑战性的训练任务:
- 密集计数:通过 Box 锚点避免重复计算。
- 空间推理:解决多步逻辑关联(Multi-hop Reasoning)。
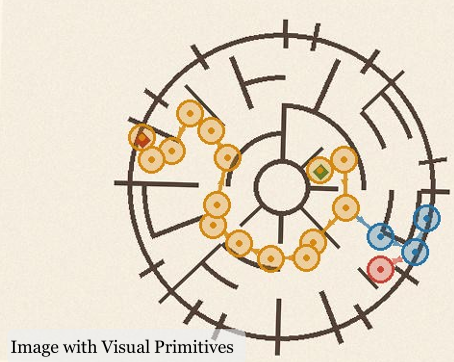
- 迷宫导航:利用 DFS 思想在迷宫中进行点对点路径搜索。
- 路径追踪:在高度缠绕的线条中识别唯一的通路。
4. 实验结果:拓扑推理的新高度
实验显示,TVP 在传统的 VQA 任务上略胜一筹,但在涉及“拓扑推理”的任务中简直是降维打击。
| 任务 (Metric) | Gemini-3-Flash | GPT-5.4 | Ours (DeepSeek) |
|---|---|---|---|
| 迷宫导航 (ACC) | 49.4 | 50.6 | 66.9 |
| 路径追踪 (ACC) | 41.4 | 46.5 | 56.7 |
这种提升证明了:引入空间坐标作为思维媒介,赋予了模型原本不具备的、类似 System-2 的逻辑严密性。
5. 深度洞察与总结
DeepSeek 的这项工作标志着 MLLM 从“看图说话”向“看图逻辑思考”的重要转型。
- 核心贡献:打破了纯语言 Chain-of-Thought 的局限性,将坐标系统合法的引入了 LLM 的推理空间。
- 局限性:目前这种“思维基元”模式仍需要特定的触发词引导,未来若能实现自动触发将更具威力。
- 启示:未来的多模态 AI,不仅需要更敏锐的眼睛,更需要一种能将“所见”与“所思”精确对应起来的底层架构。
本文主编评论:DeepSeek 再次用极高的工程效率和深刻的物理直觉证明,有时候改进模型思维逻辑的收益,远大于单纯堆叠数据和分辨率。